Fast jede Branche nutzt Lösungen für Echtzeit-Big-Data-Analysen sowie Software für Echtzeit-Präzisionsanalysen, und es gibt viele Anwendungsfälle für Echtzeit-Big-Data. Dies gilt insbesondere im E-Commerce, bei Sportwetten, Handel, maßgeschneiderter Werbung und in der Politik (wo Aktuelle Updates zu den Wahlresultaten in Echtzeit sind Pflicht).
Laut einer BARC-Umfrage von 2022 unter 2.396 Nutzern zu Themen wie Analytik, Business Intelligence und Analyse-Trends gehören Echtzeitdatenverarbeitung und -analyse zu den Top-10-Trends im Jahr 2022. Da die Geschäftswelt zunehmend daten- und kundenorientiert wird, sind Echtzeit-Datenlösungen äußerst vorteilhaft, da sie Zeit sparen. Mit schneller Datenverarbeitung können Sie Kunden sofort einen Mehrwert bieten.
Analytische Plattformen in Echtzeit minimieren die Zeit, die für Entscheidungen benötigt wird. Sie müssen in der Lage sein, Big Data in Echtzeit zu verarbeiten, um vielen Nutzern zeitnahe Erkenntnisse und Analysen zu bieten. Bestehende Analysetools bieten selten umfassende Daten in einer übersichtlichen Struktur sowie einen personalisierten Ansatz. Aber das sollte sie wirklich bieten!
Warum sollten Echtzeit-Big-Data-Analyselösungen umfassende Daten und einen personalisierten Ansatz bieten?
Es gibt viele Beispiele für Echtzeit-Analysen. Nehmen wir Netflix, das Informationen über die Suchanfragen, Bewertungen, die Fernsehprogramme gesehen wurden usw. seiner Kunden sammelt. Als datengetriebenes Unternehmen nutzt Netflix maschinelles Lernen und A/B-Tests, um Echtzeit-Inhaltsempfehlungen für seine Kunden bereitzustellen.
Dadurch kann Netflix seinen Kunden personalisierte Empfehlungen anbieten, Inhalte hervorheben, die ähnlich zu dem sind, was sie bereits gesehen haben, oder Titel aus einem bestimmten Genre vorschlagen. Dank dieser Personalisierung erzielt Netflix jährlich $1 Milliarde an Umsatz durch die Bindung seiner Kunden.
Beispiele für Echtzeitanalysen in Logistik
Das Baulogistikunternehmen Command Alkon hat eine Echtzeit-Datenanalyseplattform implementiert, um den Datenfluss des Unternehmens effizient zu steuern und entscheidende Geschäftsanalysen zu generieren. Diese Plattform ermöglicht es den Nutzern, relevante Daten zu Lieferungen von Baustoffen in Sekundenschnelle zu erhalten, diese zu analysieren und benutzerdefinierte Dashboards zur Verfolgung von Kennzahlen zu erstellen. Das Team von Command Alkon aktualisiert seine Lösung ständig, um Kunden noch schnellerere Analysefunktionen zur Verfügung zu stellen.
Dashboards sind eine hervorragende Möglichkeit, logistische Daten zu visualisieren, und es gibt viele moderne Lösungen, um solche Dashboards zu erstellen. Sie können sich dazu in den folgenden Artikeln informieren: Unser Artikel über die Integration von Dashboards in die Supply Chain-Verfolgbarkeit.
Beispiel für Echtzeit-Analysen in der FinTech-Branche
Die kanadische digitale Bank Scotiabank hat ebenfalls auf Datenanalyse gesetzt, um ihren Kunden personalisiertere Dienstleistungen anzubieten. Mit Hilfe von Datenanalysetools konnte die Bank die Zeit, die für die Generierung von Kundenangeboten benötigt wird, von 14 Tagen auf nur wenige Stunden verkürzen. Zudem hat das Team von Scotiabank dank der Erkenntnisse aus der Analyse die Unterstützung von Tausenden von Kunden während der COVID-19-Pandemie deutlich verbessert.
Persönlicherere Dienstleistungen motivieren Kunden dazu, loyal gegenüber Ihrer Marke zu bleiben und mehr mit Ihrem Unternehmen zusammenzuarbeiten.
Wenn Ihre Idee es ist, ein umfassendes, aber einfaches Tool zu entwickeln, das die reibungslose Verarbeitung von Daten in Echtzeit ermöglicht, wird Ihnen diese Einführung in ein Echtzeit-Datenmanagement-System einen Wettbewerbsvorteil verschaffen. Beachten Sie, dass das von Ihnen entwickelte Tool mit großen Daten umgehen muss. Um diesen umfassenden Leitfaden zum Echtzeit-Big-Data-Verarbeiten (unterstützt durch Beispiele für Echtzeit-Big-Data-Verarbeitung) zu beginnen, definieren wir zunächst, was genau Big Data ist.
Lesen Sie auch: Unsere Expertise in der Data Science
Big Data: ein großes Thema für die Entscheidungsfindung
Big Data bezeichnet Datensätze, die so groß sind, dass herkömmliche Software zur Datenverarbeitung sie nicht verarbeiten kann. Der Aufstieg von Big Data erfolgte allmählich dank mehrerer günstiger Bedingungen.
Initiativen zur globalen digitalen Transformation haben die Schaffung von Datenerhebungsmethoden gefördert, die es ermöglicht haben, die Anzahl der Datenquellen zu erweitern. Damit ist es nun möglich, Daten aus sozialen Medien, Online-Suchmaschinen, elektronischen Transaktionen, IoT-fähigen Geräten, RFID-Tags und vielen weiteren Quellen zu sammeln. Dies macht es möglich, Big Data-Dienste wesentlich für die Verarbeitung und Analyse dieser riesigen Menge an Informationen.
Ein weiterer Faktor, der zur Verbreitung großer Datenmengen beigetragen hat, war der Aufstieg fortschrittlicher Speicherlösungen. Die Cloud-Computing-Technologie ermöglichte es, große Datensätze zu einem angemessenen Preis zu speichern. Datenrepositories So dienen Datenseen und Datenlager als Cloud-Speicherspeicher für große und vielfältige Datensätze. Eine einzelne Organisation kann verschiedene Datenspeicher für unterschiedliche Zwecke und Datentypen nutzen.
Ein Data Lake eignet sich ideal für Big Data, da es alle Arten von Daten speichern kann, die ein Unternehmen sammelt (Vorteile von Data Lakes). Auf der anderen Seite ist ein robustes Unternehmen-Datenbanken Kann große Mengen strukturierter Daten speichern und dient als einzige Quelle der Wahrheit und als zentraler Anlaufpunkt für die gesamte Organisation, wodurch mehrere Datenanalysetechnologien möglich werden.
Deshalb bedeutet das, dass Datenmengen groß sind, nicht zwangsläufig, dass man mit Big Data. Es gibt fünf Merkmale oder fünf V, die darauf hinweisen, dass Sie mit Big Data arbeiten.
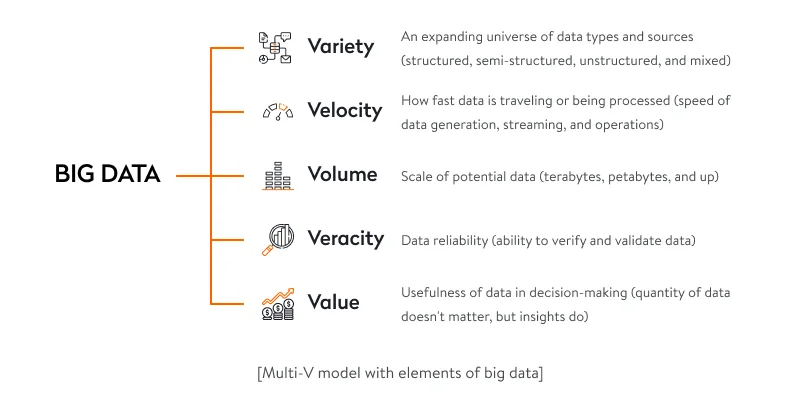
Aber den Wert aus Big Data extrahieren bedeutet nicht nur die Analyse der Daten – das ist eine ganz andere Herausforderung. Es ist ein umfassender Prozess, der es Analysten und Führungskräften erfordert, Muster zu erkennen, logische Annahmen zu treffen und den Verlauf der Ereignisse vorherzusagen. Mehr erfahren wie wir Software entwickelt haben, um Big Data für ein 3PL-Unternehmen zu verwalten.
Um diesen Prozess zu vereinfachen, können Sie mit Echtzeit-Big-Data-Analysetools Informationen zu Ihren Prozessen, Kunden, Markt usw. aufdecken. Echtzeit-Big-Data-Analysen erfordern, dass Daten sofort an Analysetools und Echtzeit-Präzisionsanalysetools gesendet werden, sobald sie eintreffen. Tools wie Apache Storm und Apache Spark helfen Unternehmen dabei, große Datenmengen zu verarbeiten. Sehen Sie sich den gesamten Datenfluss an, um Ihnen und Ihren Kunden dabei zu helfen, datengestützte Entscheidungen zu treffen.
Real-time-Big-Data-Analysen
Die Analyse großer Datenmengen in Echtzeit erfordert die Erhebung, Übertragung, Verarbeitung und Bereitstellung von Daten zur Identifizierung von Mustern oder Trends. Die Echtzeitanalyse ist Teil des größeren Konzepts fortschrittlicher Datenanalyselösungen. In ein früherer Artikel, In diesem Artikel erklären wir, was Advanced Analytics ist, indem wir es mit Business Intelligence vergleichen und dabei das Beispiel der Logistikbranche verwenden. Sehen Sie sich das folgende Bild an, um mehr über den Prozess der Echtzeitanalyse zu erfahren.

System zur Echtzeit-Erfassung großer Datenmengen
Je nachdem, für welche Daten verwendet werden, kann der Datenerhebungsprozess, der mithilfe einer Software zur Echtzeitdatenverfolgung durchgeführt wird, bei unterschiedlichen Organisationen unterschiedlich aussehen.
Wo könnten Daten gewonnen werden?
Wenn Ihr Ziel es ist, Nutzern dabei zu helfen, Entscheidungen anhand hochspezialisierter Daten zu treffen, müssen Sie Drittanbieter-Integrationen mit Datenquellen implementieren. Wenn Sie Nutzer analysieren und ihnen personalisierte Services anbieten möchten, müssen Sie Daten über Nutzer und deren Verhalten sammeln. In jedem Fall besteht Ihr Ziel darin, Kundenserviceprozesse zu optimieren.
Integrationen von Drittanbietern. Um Daten aus APIs zu erhalten, empfehlen wir die Verwendung eines Crawlers, eines Planers und der Event-Sourcing-Technik. Datenwissenschaftliche Dienstleistungen Diese Integrationen können ihre Effizienz weiter verbessern, indem ein nahtloses Datenflusssystem und fortschrittliche Analysefunktionen sichergestellt werden. Ein Crawler nutzt einen Scheduler, um regelmäßig Daten von Drittanbieter-APIs abzurufen und diese Daten in einer Datenbank zu speichern. Event-Sourcing hilft dabei, Daten automatisch zu aktualisieren und Ereignisse zu veröffentlichen; es verfolgt einen eventorientierten Ansatz zur Datenhaltung: Ein Business-Objekt wird durch die Speicherung einer Sequenz von Zustandsänderungsereignissen persistent gespeichert. Wenn sich das Zustandsvermögen eines Objekts ändert, wird eine neue Ereignisdatei in die Sequenz hinzugefügt.
Kundendaten. Sie können Kundendaten sammeln, indem Sie die Nutzer direkt darum bitten (zum Beispiel bei der Anmeldung). Technologien wie Cookies und Webbeacons auf Ihrer Website können Ihnen dabei helfen, die Browserverläufe der Besucher zu überwachen. Social-Media-Plattformen, E-Mails und Unternehmensdaten über Kunden sind ebenfalls großartige Quellen, aus denen Sie Daten abrufen können.
IoT-fähige Geräte. Sensoren, die in Lagern, Lastwagen, Banken, Geldautomaten oder Krankenhäusern installiert sind, können viele wertvolle Echtzeitdaten generieren. Sie werden durch jede Art von körperlicher Aktivität ausgelöst und sammeln und übertragen Daten in Echtzeit, die sofort für die Analyse genutzt werden können.
Lesen Sie auch: Eine Anleitung IoT-Tests
Drei Arten von erhobenen Daten
Es gibt drei Arten von Daten, die normalerweise aus Cloud-Speichern, Servern, Betriebssystemen, eingebetteten Sensoren, mobilen Apps und anderen Quellen erhoben werden.
Strukturiertes Datenformat. Diese Daten sind linear aufgebaut und werden in einer relationalen Datenbank (wie z. B. in einer Tabellenkalkulation) gespeichert. Strukturierte Daten sind für Big-Data-Tools viel einfacher zu verarbeiten als semistrukturierte und unstrukturierte Daten. Leider machen strukturierten Daten nur einen kleinen Anteil der modernen Daten aus.
Halbstrukturiertes Datenvolumen. Diese Art von Daten bietet einige Kennzeichnungseigenschaften. Aber Maschinen können sie nicht leicht verstehen. XML-Dateien und E-Mail-Nachrichten sind Beispiele für semistrukturierte Daten.
Unstrukturierte Daten. Heutzutage ist die meiste Daten nicht strukturiert. Sie werden meist von Menschen in Form von Textnachrichten, Social-Media-Beiträgen, Videos, Audiodateien usw. erstellt. Da diese Daten vielfältig (und teilweise zufällig) sind, benötigen Big-Data-Tools viel Zeit und Aufwand, um sie zu interpretieren.
Manchmal ist es notwendig, vergangene Daten zu speichern, um es einem Benutzer zu ermöglichen, diese mit Ereignissen in Echtzeit zu vergleichen. Eine Sportwetten-App kann beispielsweise Nutzern dabei helfen, basierend auf alten Daten Wetten zu platzieren, indem sie die Analysen für ein bestimmtes Jahr einsehen. Ebenso kann ein Benutzer bestimmte Datenarten in der aktuellen Periode vergleichen.
Deshalb muss eine Datenbank in der Lage sein, Daten mit minimaler Latenz an einen Benutzer zu speichern und weiterzugeben. Datenbanken müssen in der Lage sein, Hunderte von Terabyte an Daten zu speichern, Milliarden von Anfragen pro Tag zu verwalten und einen nahezu 100-prozentigen Verfügbarkeitsgrad zu gewährleisten. NoSQL-Datenbanken wie MongoDB werden typischerweise eingesetzt, um diese Herausforderungen zu bewältigen.
Die gesammelten Daten müssen dann verarbeitet und sortiert werden. Lassen Sie uns besprechen, wie dies erfolgen sollte.
Lesen Sie auch: Wie wir die Finanzdaten unserer Kunden für eine Vermögensverwaltungsplattform aggregiert haben

Tools, Technologien und Datenverarbeitung für Echtzeit-Big-Data-Streaming
Für die Streaming von Big Data werden zwei Techniken eingesetzt: Batch und Stream. Die erste erfasst eine Sammlung von gruppierten Datensätzen für einen bestimmten Zeitraum. Die zweite verarbeitet einen kontinuierlichen Datenstrom und ermöglicht es, Big Data in Echtzeit umzuwandeln.
Batch-Verarbeitung Erfordert, dass alle Daten für die Verarbeitung in eine Speicherstelle (eine Datenbank oder ein Dateisystem) geladen werden. Diese Methode ist sinnvoll, wenn eine Echtzeitanalyse nicht erforderlich ist. Das Batchen großer Datenmengen ist sinnvoll, wenn es wichtiger ist, große Datenmengen zu verarbeiten als sofortige Analysen zu erhalten. Für die Arbeit mit großen Datenmengen ist jedoch Batchverarbeitung nicht notwendig, da auch Stream-Verarbeitung mit großen Datenmengen umgeht.
Im Gegensatz zur Batch-Verarbeitung, Streamverarbeitung Verarbeitet Daten in Bewegung und liefert schnell Analyseergebnisse. Dieser Ansatz wird häufig in von einem Unternehmen entwickelten Lösungen angewendet. Unternehmen für die Entwicklung von Applikationen für maschinelles Lernen Um Echtzeit-Insights zu ermöglichen. Wenn Echtzeit-Analystik-Lösungen für den Erfolg Ihres Unternehmens entscheidend sind, ist Stream-Processing die richtige Wahl. Diese Methodik gewährleistet eine minimale Verzögerung zwischen der Datenerhebung und der Verarbeitung. So kann Ihr Unternehmen bei Bedarf schnell transformiert werden.

Lesen Sie auch: Unsere Expertise in Big Data und Analytics
Sie können Open-Source-Tools verwenden, um die Echtzeit-Verarbeitung großer Datenmengen sicherzustellen. Hier sind einige der bekanntesten:
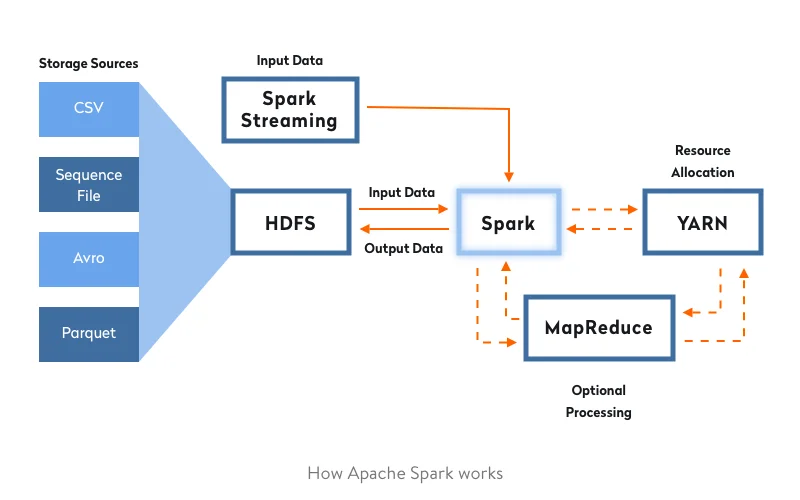
Apache Spark is eine Open-Source-Plattform für die Verarbeitung von Streams, die in-Memory-Datenverarbeitung bietet, sodass sie Daten viel schneller verarbeitet als Tools, die traditionelle Diskverarbeitung verwenden. Funke Funktioniert mit HDFS und anderen Datenlagern, einschließlich OpenStack Swift und Apache Cassandra. Die verteilte Berechnung von Spark kann zur Verarbeitung strukturierter, unstrukturierter und semistrukturerter Daten eingesetzt werden. Darüber hinaus ist es einfach, Spark auf einem einzigen lokalen System zu betreiben, was die Entwicklung und Testphase vereinfacht.
Apache Storm ist ein verteilter Echtzeit-Framework Verwendet zur Verarbeitung unbegrenzter Datenströme. Storm unterstützt jede Programmiersprache und verarbeitet strukturierte, unstrukturierte und halbstrukturiert Daten. Sein Scheduler verteilt die Arbeitslast auf die Knoten.
Apache Samza ist ein verteilter Stream-Verarbeitungssystem, das eine einfach zu verwendende Callback-API bietet. Samza bietet Snapshots-Management und Fehlerüberwachung auf dauerhafte und skalierbare Weise.
Weltbekannte Unternehmen entscheiden sich oft für diese etablierte Lösung. So nutzt Netflix Apache Spark, um den Nutzern empfohlene Inhalte bereitzustellen. Da Spark ein Komplettsystem für die Arbeit mit Big Data ist, wird es zunehmend von führenden Unternehmen eingesetzt. Das Bild unten zeigt das Prinzip der Funktionsweise:
Sie können auch eine benutzerdefinierte Software erstellen. Die Wahl der Methode hängt von Ihren Antworten zu drei Fragen ab. Wie viel Fragen:
– Wie viel Komplexität planen Sie zu managen?
– Wie viel planen Sie zu skalieren?
– Wie viel Zuverlässigkeit und Fehlervermeidungsfähigkeit benötigen Sie?
Wenn Sie den oben genannten Prozess ordnungsgemäß umgesetzt haben, werden Sie keine Nutzer verlieren. Wie können Sie also darauf vorbereitet sein?
Architektur für Echtzeit-Big-Data-Analysen
In diesem Abschnitt besprechen wir die bequemste Architekturart für die Echtzeit-Big-Data-Analytik. Eine Reihe von Amazon Kinesis-Services, darunter Amazon Kinesis Data Streams, Amazon Kinesis Data Firehose und Amazon Kinesis Data Analytics, kann hilfreich sein, um eine individuelle Architektur für die Datenanalyse zu entwickeln.
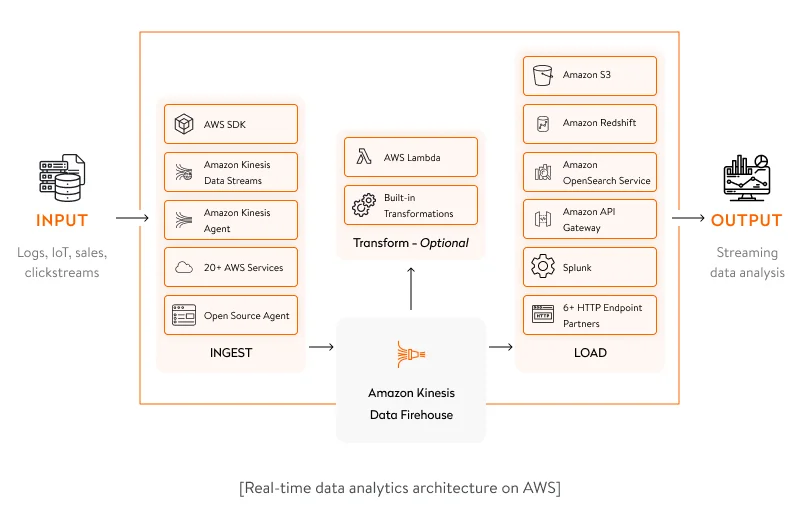
Amazon Kinesis Data Streams ist ein Dienst zur Erfassung, Verarbeitung und Speicherung von Datenströmen jeder Größe. Er eignet sich für Softwarelösungen, die hochfrequente Echtzeitdaten generieren und diese Daten in Sekundenbruchteilen verarbeiten können.
Amazon Kinesis Data Firehose Es handelt sich um ein Tool für das Extrahieren, Transformieren und Laden (ETL), das Echtzeitdaten erfassen, verarbeiten und in verschiedene Datenspeicheranlagen wie ein Data Warehouse (Amazon Redshift) oder ein Data Lake (Amazon S3) oder direkt an Analyse-Services übertragen kann. Dieses Tool ermöglicht außerdem eine effiziente Überwachung der Sicherheit real-time-netzwerkbasierter Systeme und die Erstellung von Warnmeldungen zu möglichen Cyberbedrohungen.
Amazon Kinesis Data Analytics ist ein Amazon-Service, der Echtzeit-Data-Analytics mithilfe von Apache Flink ermöglicht. Er bietet flexible APIs in Programmiersprachen wie Java, Scala und Python. Mit Hilfe vorgefertigter Analysefunktionen können Sie in Echtzeit eine robuste Streaming-Anwendung in nur wenigen Stunden erstellen.
Die Entwicklung einer serverlosen Architektur ist eine der geeignetsten Lösungen, um alle oben genannten Amazon-Services für die Echtzeitanalyse richtig zu kombinieren. Für Unternehmen, die diese Herangehensweise in Betracht ziehen, ist eine Zusammenarbeit mit erfahrenen Experten von Vorteil. Berater für künstliche Intelligenz Dies ermöglicht eine effiziente Gestaltung und Implementierung der Lösung. Eine serverlosen Architektur bedeutet die Abwesenheit jeglicher Infrastruktur, die Sie verwalten müssen, sowie umfangreiche automatische Skalierbarkeit.
Um eine serverlose Architektur zu erstellen, lohnt es sich, AWS Lambda als Logikschicht der Anwendung zu verwenden. AWS Lambda ist ein Ereignis-basiertes Computing-Service, der Tausende von Ereignissen pro Sekunde verarbeiten kann. Es hilft Ihnen dabei, hochskalierbare und leistungsstarke Softwarelösungen zu entwickeln.
Eine Echtzeit-Analytik-Architektur bietet viele Vorteile, aber die wichtigsten sind die hohe Belastbarkeit und die Skalierbarkeit durch die Implementierung von Echtzeit-Analysen.
Lesen Sie auch: Wie wir einen Data Lake für ein Fertigungsunternehmen implementiert haben
Hohe Ladekapazitäten und Skalierbarkeit durch Big Data und Echtzeit-Analysen
Ein ordnungsgemäß entwickeltes System könnte viele Nutzer anziehen. Stellen Sie daher sicher, dass es hohen Belastungen standhalten kann. Selbst wenn Ihr Projekt klein ist, könnte es notwendig sein, die Größe zu vergrößern.
Was ist eine hohe Belastung?
- Ein hohes Lastauslasten tritt auf, wenn ein Server nicht in der Lage ist, alle Ihre Daten effektiv zu verarbeiten.
- Wenn eine Instanz gleichzeitig 10.000 Verbindungen verarbeitet, handelt es sich um eine hohe Belastung.
- Eine hohe Belastung bedeutet gleichzeitig die Verwaltung von Tausenden oder Millionen von Benutzern.
- Wenn Sie Ihre App auf Amazon Web Services, Microsoft Azure oder Google Cloud Platform bereitstellen, erhalten Sie automatisch eine hochbelastbare Architektur.
Prinzipien für die Entwicklung von Apps, die hohe Belastungen bewältigen können
Dynamik und Flexibilität. Bei der Entwicklung großflächiger Apps sollte der Fokus auf Flexibilität liegen. Mit einer flexiblen Architektur können Sie Änderungen und Erweiterungen viel einfacher vornehmen. Dies führt zu geringeren Kosten, weniger Zeit und weniger Aufwand. Darüber hinaus, Verwendung des Prinzips Sie kann bei der Entwicklung von Benutzerschnittstellen helfen und somit frühe Tests und die Feinabstimmung von Designkonzepten ermöglichen. Beachten Sie jedoch, dass Flexibilität das wichtigste Element eines schnell wachsenden Softwaresystems ist.
Skalierbarkeit. Unternehmen sollten die Skalierbarkeit an ihre Entwicklungsziele anpassen, d. h. entsprechend der Anzahl der erwarteten Nutzer. Stellen Sie sicher, dass Sie eine vorläufige Analyse durchführen, um sicherzustellen, dass Ihre App ausreichend skalierbar ist, um die erwartete Belastung zu bewältigen. Gleiches gilt für die App-Architektur. Denken Sie daran, dass skalierbare Produkte die Grundlage erfolgreicher Softwareentwicklung sind.
Die Skalierung einer App umfasst vier Schritte:
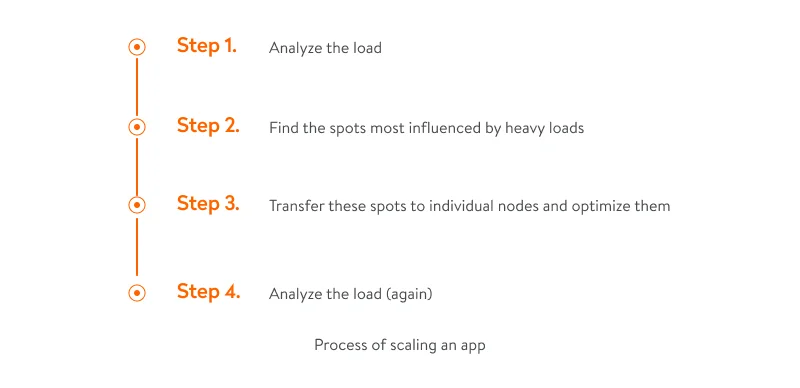
Wenn Sie eine neue App entwickeln, ist es nicht notwendig, sofort eine Infrastruktur zu erstellen, die mit Millionen von Nutzern und Millionen von Ereignissen täglich umgehen kann. Wir empfehlen jedoch, Ihre App von Anfang an skalierbar zu gestalten. Dies hilft Ihnen langfristig, große Änderungen zu vermeiden.
Wir empfehlen außerdem, neue Projekte in der Cloud zu hosten, da dadurch die Serverkosten gesenkt und die Verwaltung verbessert wird.
Darüber hinaus bieten viele Cloud-Hosting-Dienste private Netzwerke an. Diese Dienste ermöglichen es Entwicklern, mehrere Server in der Cloud sicher zu nutzen und Systeme skalierbar zu machen.
Folgende Tipps helfen Ihnen dabei, skalierbare Apps zu erstellen:
Wählen Sie die richtige Programmiersprache aus. Erlang und Elixir bieten beispielsweise die Möglichkeit, kontextbezogene Konkurrenten zu implementieren. Diese Sprachen ermöglichen es Prozessen, miteinander zu kommunizieren, selbst wenn sie auf verschiedenen physikalischen Computern laufen. Daher müssen Entwickler sich keine Sorgen um das zugrunde liegende Netzwerk oder das verwendete Kommunikationsprotokoll machen.
Sorgen Sie für die Kommunikation zwischen den Mikroservices. Der Kommunikationskanal zwischen Ihren Diensten sollte ebenfalls skalierbar sein. Um dies zu erreichen, können Sie einen Messaging-Bus implementieren, eine Infrastruktur, die verschiedenen Systemen hilft, über eine gemeinsame Reihe von Schnittstellen zu kommunizieren. Dadurch können Sie ein lösungsgruppenfreies System erstellen, das Ihre Dienste unabhängig skalieren lässt.
Verhindern Sie eine einzige Schwachstelle. Vergewissern Sie sich, dass keine einzelne Ressource Ihr gesamtes Applikationskonzept zum Stillstand bringen könnte. Um dies zu gewährleisten, sollten Sie mehrere Kopien aller Dinge erstellen. Wir empfehlen, eine Datenbank auf mehreren Servern zu betreiben. Einige Datenbanken unterstützen die Replikation standardmäßig – zum Beispiel MongoDB. Gleiches gilt für Ihren Backend-Code: Laden Sie Load Balancers ein, um diese auf mehreren Servern auszuführen.
Die Rolle von Datenbanken bei der Verarbeitung hoher Lasten
Traditionelle relationale Datenbanken sind nicht darauf ausgelegt, von horizontaler Skalierung zu profitieren. Eine neue Klasse von Datenbanken, die NoSQL-Datenbanken genannt werden, nutzt das Cloud-Computing-Umfeld. NoSQL-Datenbanken können die Belastung nativ verwalten, indem sie Daten auf viele Server verteilen. Dadurch eignen sich diese Datenbanken für Cloud-Computing-Umgebungen. Um mehr Einblicke in die Auswahl einer Datenbank zu erhalten, lesen Sie Unser detaillierter Leitfaden.
Ein Grund dafür, dass NoSQL-Datenbanken hohe Lasten bewältigen können, liegt darin, dass verwandte Daten zusammen statt in separaten Tabellen gespeichert werden. Ein solches Dokumentdatenmodell, das in MongoDB und anderen NoSQL-Datenbanken verwendet wird, macht diese Datenbanken ideal für Cloud-Computing-Umgebungen (Typen von Datenmodellen).
Um die hohe Belastbarkeit unserer Kunden-App „World Cleanup Day“ zu gewährleisten, verwendeten wir PostgreSQL, das simultane I/O-Verfahren ermöglicht und hohe Belastungen bewältigt. Weitere Details finden Sie in unserer Fallstudie.
Durch die oben genannten Implementierungen und die in diesem Leitfaden beschriebene Nutzung von Big-Data-Technologie können Sie Nutzern Software für die Deep-Analytics- und Reporting-Funktionen bereitstellen, die Daten in Echtzeit aus mehreren Quellen verarbeitet und visualisiert. Yalantis verfügt über umfangreiche Erfahrung in allen Phasen des Entwicklungsprozesses für mobile und web-freundliche Echtzeit-Analysetools: Erhebung von Daten aus mehreren Quellen, Erstellung attraktiver Diagramme und Anzeige von Prognosen (Verwaltung von Lebenszyklusdaten). Wir helfen Ihnen gerne weiter, wenn Sie an der Beratung und Entwicklung von Big Data-Infrastrukturen interessiert sind.
Haben Sie ein großes Datenprojekt im Kopf?
Warum nicht darüber diskutieren?
FAQ
Was ist Echtzeit-Data-Analytics?
Eine solche Analyse ist die sofortige Analyse strukturierter und unstrukturierter Daten, die eine schnelle und fundierte Entscheidungsfindung ermöglicht. Diese Art von Analyse hilft Organisationen dabei, die Risikostufen zu überwachen und zu bewerten, eine Personalisierung sicherzustellen, Betrug zu erkennen und Business Intelligence bereitzustellen.
Was ist Echtzeitdatenverarbeitung?
Es handelt sich um die Verarbeitung eines unbegrenzten Datenflusses mit sehr kurzen Latenzzeiten – gemessen in Millisekunden oder Sekunden.
Was ist eine Echtzeit-Analytikplattform?
Eine solche Plattform hilft Unternehmen dabei, die Vorteile der Echtzeitdaten optimal auszuschöpfen und daraus aussagekräftige und handlungsrelevante Erkenntnisse und Trends zu gewinnen. Mit Hilfe solcher Plattformen können Sie Informationen aus betriebswirtschaftlicher Sicht in Echtzeit analysieren.
Über den Autor