|
Wichtige Erkenntnisse
|
Vor einigen Monaten sprachen unsere Data-Experten mit dem CTO eines mittelständischen Logistikunternehmens. Sie hatten kürzlich einen Chief Data Officer (CDO) eingestellt, ihre BI-Tools modernisiert und stark in die Cloud-Infrastruktur investiert. “Wir haben alles nach den Regeln gehandhabt”, sagte der CTO. “Aber irgendwie können wir immer noch keine Entscheidungen anhand von Daten treffen.”
Dieser CTO ist nicht allein. Die Executive Survey zu Data und KI von NewVantage Partners Ein interessanter Entdecker DiskrepanzWährend fast 74 Prozent der Unternehmen einen CDO oder Chief Analytics Officer (CAO) eingestellt haben, geben nur etwa 26 Prozent an, dass sie tatsächlich datengetrieben geworden sind.
Diese Ergebnisse beweisen, dass die Ernennung eines CDO oder CAO selbst noch nicht garantiert, dass ein Unternehmen datengetrieben wird. Ohne eine zuverlässige Grundlage für die Speicherung, Verwaltung und den Zugriff auf Unternehmensdaten kann selbst die bestens qualifizierte Führung keine bedeutsame Transformation vorantreiben. Eine der Hauptgründe dafür, dass Unternehmen nicht in der Lage sind, Daten zu nutzen, liegt in der Mangel an einer zentralisierten, gut strukturierten Datenumgebung. Deshalb ist es wichtig, ein Enterprise Data Warehouse (EDW) ist ein entscheidender Schritt.
In diesem Beitrag behandeln wir folgende Themen:
- Was ist eine EDW
- Warum? Sie brauchen es
- wie Sie können davon profitieren
- Ein detaillierter Schritt-für-Schritt-Prozess Über die Erstellung eines Data-Warehouse für Ihre Unternehmensanforderungen.
Was ist ein Data Warehouse und ein Enterprise Data Warehouse (EDW)?
In diesem Abschnitt werden wir sehen, wie ein Data Warehouse sich von einem Enterprise Data Warehouse unterscheidet und ob man ein solches benötigt oder nicht.
Definition eines Data-Warehouse oder warum Datenbanken nicht ausreichen
Ein Data Warehouse ist ein Architekturkonzept zur effizienten Organisation großer Mengen strukturierter Daten für die Datenanalyse und die Entscheidungsfindung auf der Grundlage von Daten. Unter effizienter Speicherung versteht man die Speicherung nur derer Datensätze, die für ein bestimmtes Unternehmen relevant sind. Beispielweise wäre es für ein E-Commerce-Unternehmen besser, nicht die Gesamtzahl der Verkaufstransaktionen zu speichern, sondern die Gesamtsumme der Verkäufe über einen bestimmten Zeitraum zu speichern. Diese Datensätze bieten mehr Wert und können Einblicke darüber liefern, wie ein Unternehmen performt und ob es seine finanziellen Ziele erreicht.
Warum ist ein Data Warehouse besser als die einfache Abfrage von Daten aus verschiedenen Anwendungsspeichern für die Analyse? Datenbanken speichern Transaktionsdaten, die regelmäßig aktualisiert werden. Wenn Sie also beispielsweise daran interessiert sind, Ihre Verkaufsdaten über fünf Jahre hinweg zu analysieren, indem Sie diese Daten einfach aus Anwendungsspeichern extrahieren, werden Sie diese Daten dort niemals finden. Im Gegensatz dazu Ein Data Warehouse kann große Datenmengen speichern, die jederzeit für die historische Datenanalyse verfügbar sind.
Definition von EDW
Der Computerwissenschaftler B. Inmon führte das Design von Enterprise Data Warehouses ein. Nehmen wir Inmons Definition eines EDW aus seinem Buch “Building the Data Warehouse”: Ein EDW ist eine themenorientierte, integrierte, zeitvariante, nicht-volatile Datensammlung zur Unterstützung des Entscheidungsprozesses der Unternehmensführung. Es handelt sich um die Datenlast Ihrer Geschäftsprozesse.
Mit Hilfe einer EDW können Sie Ihre eigenen Bedingungen für die Datenaggregation, die Datengranularität und die Datenaufteilung festlegen. Um diese strukturierten Datensätze zu verstehen und aussagekräftige Erkenntnisse zu gewinnen, wenden sich Unternehmen oft an Business Intelligence-Dienstleistungen.Sie können unterschiedliche Kriterien für die niedrige (detaillierteere) oder hohe (weniger detaillierte) Gruppierung von Datensätzen festlegen. Für eine optimierte Datenspeicherung können Sie Datensätze zudem in kleinere Einheiten aufteilen. Um solche maßgeschneiderte Datenstrategien effektiv umzusetzen, setzen viele Unternehmen auf professionelle Unterstützung. Dienstleistungen für die Entwicklung von Data Science zur Verbesserung der Datenmanagement- und Analysefähigkeiten.
Vergleich zwischen einem Data Warehouse und einem EDW
A Datenbanken Ist ein breiter Begriff, der auf ein zentralisiertes System für die Speicherung großer Datenmengen mit strukturierten Daten hinweist. Stellen Sie sich das als eine Allzwecklösung für die Datenspeicherung vor, die je nach Design und Nutzung verschiedene analytische und Berichtsbedürfnisse unterstützen kann.
An Enterprise Data Warehouse (EDW), Der andere Typ von Data Warehouse ist hingegen ein spezieller Typ von Data Warehouse, der sich um Geschäftsprozesse und Entscheidungsbedürfnisse. In dieser Methode ist es Ihre Ziele des Unternehmens, operative Arbeitsabläufe und Analyseanforderungen das bestimmt, welche Daten erfasst werden, wie sie verarbeitet werden und wie sie gespeichert werden.
Kurz gesagt:
- A Datenbanken ist das Werkzeugkasten.
- An EDW ist eine maßgeschneiderte Lösung, die mithilfe dieses Toolkoffers entwickelt wurde, um die spezifischen Datenanalysebedürfnisse Ihres Unternehmens zu erfüllen.
Vorteile des Unternehmensdatenlagers
- Strukturiertes Datenmanagement. Enterprise Datenbankverwaltungsdienstleistungen ermöglicht Organisationen eine strukturierte Vorgehensweise bei der Datenspeicherung und damit auch bei der Datenanalyse. Ganz einfach: Mit einer klaren Anforderung können Sie in einer EDW schnell alle benötigten Daten finden.
- Zentraler Zutrittskontrollsystem. Mit einer EDW müssen Sie keine mehreren Richtlinien für den Datenzugriff verwalten. Sobald alle Ihre Unternehmensdaten in der EDW konsolidiert sind, müssen Sie nur die Zugriffsrechte verwalten.
- Schnellere und genauere Berichte und Analysen. Die Erfassung verschiedener Daten aus zerstreuten Unternehmensdatenbanken erschwert und verlängert die Erstellung von Berichten erheblich. Daher können Datenanalysten während dieses Prozesses potenziell Fehler machen. Mit einer EDW können Analysten schnell auf notwendige (und vor allem genaue) Daten zugreifen und somit korrekte und effiziente Berichte erstellen.
- Hohe Datenqualität. Da die Daten in einer EDW normalisiert und für zukünftige Analysen transformiert werden, kommt es zu minimaler Datenduplikation, und daher benötigen Datenanalysten weniger Zeit, um qualitativ hochwertige Berichte zu erstellen.
Vergleichen Sie das Leben mit einer EDW mit dem Leben ohne:
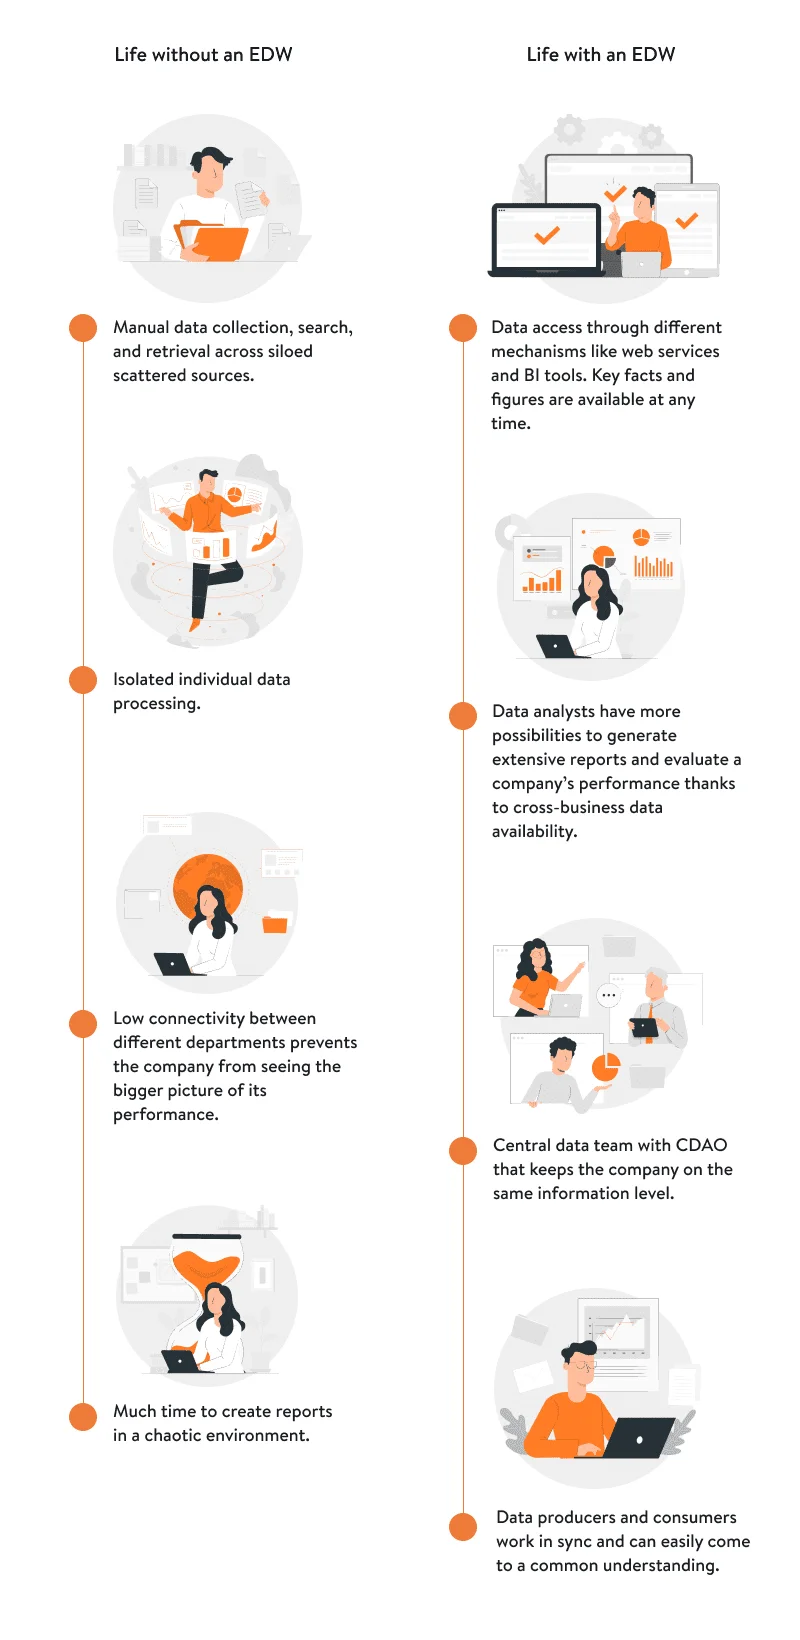
Die obige Infografik zeigt, dass Die Implementierung eines Unternehmensdatenlagers bietet die Möglichkeit, einen weiteren Schritt in Richtung einer datengetriebenen Organisation zu machen. Sie werden wissen, wie Sie Ihre Unternehmensdaten verwalten und welche spezifischen Datensätze analysiert werden müssen, um fundierte Entscheidungen zu treffen, die die Geschäftsergebnisse beeinflussen.
Weiterlesen, um mehr über die Erstellung eines Datenlagers von Grund auf zu erfahren. Ein digitales Lager kann zu einem End-to-End-Geschäftslösung durch die Verknüpfung aller relevanten Unternehmensdatenquellen.
Die tatsächliche Anwendung einer EDW in der Praxis
Der erste und wichtigste Grund für die Erstellung eines Data-Warehouse von Anfang an besteht darin, dass es perfekt zu Ihrem aktuellen Geschäftsmodell passt. Besonders wenn Ihr Unternehmen groß ist und Sie den Datenfluss über mehrere Abteilungen oder sogar Einrichtungen wie ein Krankenhausnetzwerk verfolgen müssen. Es ist erwähnenswert, dass ein EDW Teil Ihrer größeren Projekte im Bereich der Unternehmensdatenverwaltung sein kann.
Beispielsweise ein großes Universitätsklinikum Helsinki (HUS) mit mehr als 17 Krankenhausstandorten Das Unternehmen hat schrittweise Enterprise-Data-Warehouse-Lösungen als Teil eines viel größeren Projekts namens “Big Data Platform” eingeführt. Es benötigte eine einzige Quelle für strukturierte Daten, wie z. B. Finanzdaten, und unstrukturierte Daten, wie medizinische Bilder. Sie können auch erfahren, wie wir das US-amerikanische 3PL-Unternehmen dabei geholfen haben, mehr Erkenntnisse zu gewinnen und den Datenfluss mithilfe unserer Technologie besser zu steuern. Lösung für die Analyse großer Datenmengen.
In der Anfangsphase dieses Projekts entwickelten sie eine EDW, um strukturierte Daten zu sammeln und zu speichern. So stellte sich eine EDW als wesentlicher Baustein einer viel größeren Lösung heraus. Datenplattform für das gesamte Unternehmen. Dies ist einer der zusätzlichen Vorteile eines Unternehmensdatenlagers, da es mit anderen Datenrepository-Lösungen in Ihrer Organisation integrierbar ist., Hust hat eine eigene Datenplattform aufgebaut, wie zum Beispiel ein Data Lake, um eine einzigartige Datenplattform zu schaffen, die perfekt auf die Anforderungen Ihres Unternehmens zugeschnitten ist. Seit der ersten Implementierung dieser EDW hat HUS diese Datenplattform stetig erweitert, um sie besser an die sich verändernden Geschäftsumgebungen anzupassen.
Lesen Sie auch: Zentrales Datenarchiv
Müden von zerstreuten Daten und langsamen, ungenauen Berichten? Erstellen wir eine einzige Quelle der Wahrheit, um das Chaos zu beenden und unsere Analysen zu optimieren.
Typen von Enterprise-Datenbanken
Je nach Hosting-Umgebung können unternehmensspezifische Data Warehouses eingesetzt werden. on-premises, cloud oder hybrid. Ihre langjährigen analytischen Ziele, die Datenmenge sowie die Hardware- und Softwarekapazitäten bestimmen diese Entscheidung und viele andere nicht so offensichtliche Faktoren. Wenn Sie beispielsweise beschließen, Ihre gesamte Infrastruktur in die Cloud zu migrieren, ohne zuvor Ihre Datentechnologien, versteckte Kosten und Zeitbeschränkungen analysiert zu haben, kann dies für Ihr Unternehmen eine Katastrophe sein.
Es ist daher am besten, Ihre Hosting-Umgebung sorgfältig zu wählen, indem Sie die verfügbaren Ressourcen gründlich analysieren und den potenziellen ROI Ihrer Investition in eine bestimmte Umgebung ermitteln.
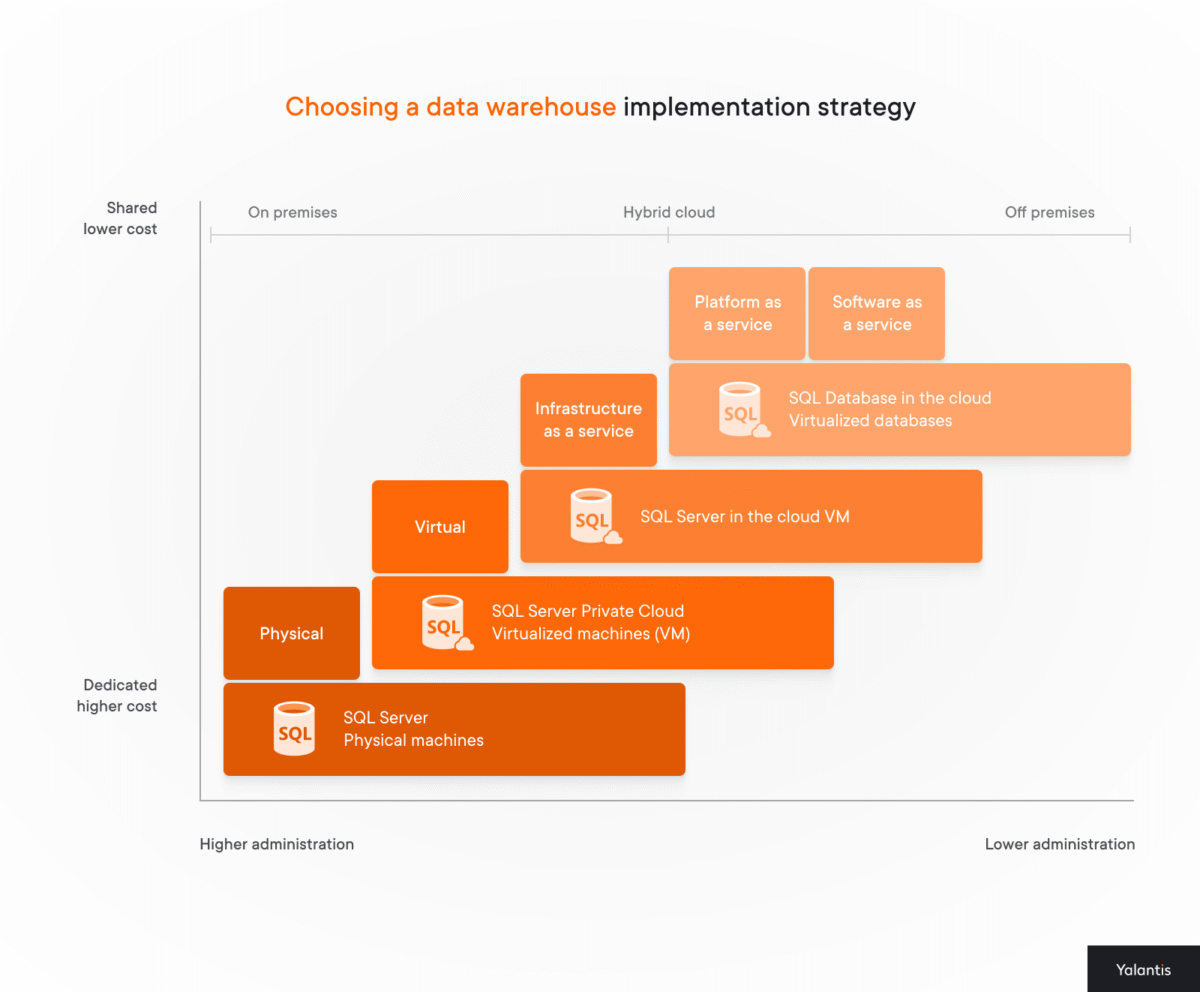
In diesem Abschnitt behandeln wir jede Art von Enterprise-Data-Warehouse-System detailliert und erläutern das folgende Diagramm, das zeigt, dass der Wechsel von der On-Premise-Architektur in die Cloud eine Senkung der administrativen Belastung und der Wartungskosten bedeutet, aber das ist nicht ganz so einfach. Lassen Sie uns herausfinden, warum.
On-Premises EDW
Die Bereitstellung eines Unternehmensdatenlagers vor Ort kann eine kostspielige, aber dennoch zuverlässige Option sein, um Ihre sensiblen Geschäftsdaten sicher zu halten. Eine Datenklassifizierungstrategie kann Ihnen helfen, Ihre Daten nach Sensitivität, geschäftswertlicher Bedeutung und regulatorischen Anforderungen zu kategorisieren. Basierend auf diesen Erkenntnissen können Sie analysieren, wie wichtig es für Ihr Unternehmen ist, Daten im Unternehmensdatenlager vor Ort zu speichern.
Die wichtigsten Vorteile, wenn Sie Ihre Daten vor Ort speichern, sind:
- Die vollständige Eigentümerschaft an der Dateninfrastruktur. Eine EDW-Lösung auf Basis eigener Hardware- und Softwarekomponenten ist lokal implementiert und stellt Ihre Mitarbeiter zum einzigen Eigentümer der EDW-Lösung. Dadurch können Sie Ihre EDW individuell anpassen, aktualisieren und ändern, so wie Ihr Unternehmen sie derzeit benötigt.
- Maximale Kontrolle über die Datenverwaltung. On-prem bietet Ihnen die volle Kontrolle darüber, wer auf was und wie zugreifen darf. Sie können detaillierte Sicherheitsrichtlinien implementieren und alles intern überwachen – was besonders in Branchen mit strengen Regeln für die Datenverarbeitung und -freigabe nützlich ist.
- Keine Abhängigkeit von der Internetverbindung. Ihr System bleibt auch während von Ausfällen oder Serviceunterbrechungen betriebsbereit, was für Betriebsabläufe von entscheidender Bedeutung ist, die keine Ausfälle vertragen können, wie etwa in Fertigungsanlagen, in kritischen Gesundheitsversorgungssystemen oder bei der Echtzeit-Finanzverarbeitung.
- Support für benutzerdefinierte oder ältere Systeme. Wenn Ihr Unternehmen auf Legacy-Anwendungen oder sehr spezifische Systemkonfigurationen – On-Premise kann die einzige Möglichkeit sein, diese nahtlos zu unterstützen, ohne dass eine erneute Architektur für die Cloud erforderlich ist.
Wählen Sie On-Premise, wenn Sie:
- Griff sehr sensible oder regulierte Daten
- Wir verfügen bereits über eine solide IT-Infrastruktur
- Erfordert eine strenge Kontrolle der Leistung, der Verfügbarkeit oder der Konfigurationen
- sind nicht bereit (oder dürfen nicht) bestimmte Datensätze in die Cloud stellen
Cloud EDW
Die Hosting-Lösung für ein Data Warehouse in einer Cloud-Umgebung kann in drei Kategorien unterteilt werden:
- Infrastruktur als Dienstleistung (IaaS). Ein Cloud-Anbieter übernimmt die gesamte Infrastruktur (Hardware-Seite). Sie erhalten eine virtuelle Maschine (VM) oder ein virtuelles Datenlager in der Cloud, in dem Sie Ihre eigene installieren und verwalten können. Server, So wie Sie es auf einem physischen Server in Ihrem Büro tun würden, ohne jedoch die Hardware kaufen oder warten zu müssen.
- Plattform-as-a-Service (PaaS). PaaS geht einen Schritt weiter. Der Cloud-Anbieter verwaltet sowohl die Hardware als auch das Betriebssystem. Sie müssen sich lediglich um die Entwicklung und den Betrieb Ihrer Anwendungen oder Datenbanken kümmern; Sie müssen sich keine Sorgen um Patches, OS-Updates oder System-Einstelleinstellungen machen.
- Software as a Service (SaaS). Endlich eine noch abstraktere Lösung, ideal für Teams, die eine sofort einsatzbereite Lösung benötigen. Sie müssen überhaupt keine EDW-Datenbanken einrichten. Stattdessen können Sie eine BI-Plattform wie Power BI oder Looker verwenden, wo alles aus der Fabrik bereitsteht: Daten-Connector, Visualisierungen, Benutzerberechtigungen usw.
Die Implementierung eines Data-Warehouse in der Cloud ist eine gängige Methode, da sie mehrere Vorteile bietet:
- Fertige Lösungen. Eine Cloud-Umgebung ist bereits etabliert und erfordert lediglich Skalierung, Konfiguration und Anpassung, um mit Ihren Zielen zu übereinstimmen.
- Elastizität. Je nach den Anforderungen Ihres Unternehmens können Sie entweder Speicherplatz erweitern oder reduzieren, und solche Manipulationen erfordern keine großen Investitionen, im Gegensatz zu einer On-Premise-Umgebung.
- Horizontale Integration mit verschiedenen Dienstleistungen. Cloud-Services können problemlos mit anderen Lösungen integriert werden. So können beispielsweise Cloud-Speicherdienste mit Cloud-Lösungen zur Datenanalyse integriert werden.
- Verringerte IT-Verwaltungskosten. Bei einer On-Premise-Implementierung müssen Sie ein großes IT-Team einstellen, das für die gesamte Hardware und Software zuständig ist. Um ein Cloud-Datenwarehouse zu betreiben, benötigen Sie deutlich weniger Mitarbeiter.
- Geringere Kapitalkosten und minimale Betriebskosten. Dieser Vorteil ist das ultimative Ergebnis aller oben genannten Vorteile. Um eine cloudbasierte Datenwarehouse-Lösung zu implementieren, müssen Sie keine teure Hardware oder Software kaufen. Sie zahlen nur dann, wenn Sie etwas benötigen, und behalten so Ihr Budget flexibel.
Alle großen Cloud-Anbieter bieten Lösungen für die Datenverwaltung an und positionieren sich als Anbieter von Enterprise-Datenbanken. Wir möchten insbesondere Amazon Web Services (AWS) und, Amazon Redshift. Redshift ist ein Dienst speziell für die Datenlagerung konzipiert. Ihr größtes Vorteil ist die Integration mit einem Datenmeer für vielfältige Daten. Anwendungsfälle für Data Lakes, Amazon Redshift ermöglicht eine nahtlose Informationsflutung in der gesamten Organisation in Echtzeit. Vollständige Datenanalyse-Funktionen und präsentiert eine völlig neue Idee – ein Data Lakehouse. Das Data Lakehouse kombiniert Daten aus Ihrem Data Lake und einem Data Warehouse und ermöglicht Ihnen, neue Höchstleistungen in der Unternehmensdatenanalyse zu erzielen.
Obwohl die Vorteile von Cloud Computing Das klingt überzeugend, bleibt die Frage: Ist es sicher genug, um Daten in der Cloud zu speichern? Die Antwort lautet eindeutig “ja”. Cloud-Services bieten zuverlässige Mechanismen zur Datenverschlüsselung, die die Daten während der Übertragung und Speicherung verschlüsseln. Und die Schlüssel, die zur Entschlüsselung der außerhalb der Cloud gespeicherten Daten verwendet werden. Auf diese Weise bieten Cloud-Services auch den sensibelsten Daten ein hohes Maß an Datensicherheit.
Anbieter von Cloud-Datenlagerdienstleistungen erfüllen außerdem die meisten gängigen Compliance-Anforderungen. So erfüllen beispielsweise AWS und Microsoft Azure die Anforderungen von HIPAA, PCI DSS, ISO 27001 und FedRAMP.
Lesen Sie auch: Sichere Anwendungsentwicklung von der Planung bis zur Produktion
Wählen Sie die Cloud, wenn Sie:
- Wollen die Investitionskosten so gering wie möglich halten
- Es muss schnell skalierbar sein
- Will nicht Hardware verwalten
- Verwenden Sie eine breite Palette integrierter Cloud-Services (BI-Tools, KI-/ML-Plattformen)
- Sie sind mit externen Datenspeicher- und Verschlüsselungstandards vertraut
Hybrid EDW
A Hybrid-Unternehmen-Datenbank Sie vereint das Beste aus beiden Welten – die Kontrolle und Sicherheit der lokalen Infrastruktur mit der Skalierbarkeit und Kosteneffizienz der Cloud. Für viele Unternehmen bietet diese Strategie für ein Unternehmensdatenlager die nötige Flexibilität, um sowohl sensible, regulierte Daten als auch schnell wachsenden, analytisch nutzbare Datensätze zu verwalten.
Beispielsweise können Sie sensible Kundendaten oder Finanzdaten in Ihren lokalen Systemen für vollständige Kontrolle und Compliance speichern, während Sie die Cloud zur Speicherung betrieblicher oder historischer Geschäftsdaten für analytische Anwendungen auf Abruf und langfristige Speicherung nutzen. Bei der richtigen Konfiguration arbeiten die beiden Umgebungen nahtlos zusammen und ermöglichen eine effiziente Datenübertragung, Integration und Zugriff.
Die Strategie-Diagramm Das Beispiel, das Sie zuvor gesehen haben, illustriert genau diese Balance: Wenn Sie von physischen Servern (links) zu vollständigen Cloud-Lösungen (rechts) wechseln, sinkt die Verwaltungskostenquote, während die gemeinsame Infrastruktur und die Kosteneffizienz steigen. Hybrid ist genau in der Mitte und ermöglicht Ihnen die Entscheidung. Was unter Ihrem Dach bleibt und Was auf die Cloud migriert basierend auf der Datenklassifizierung, den Geschäftsprioritäten und den Compliance-Anforderungen.
Die wichtigsten Vorteile eines hybriden EDW:
- Flexibilität bei der Datenplatzierung. Halten Sie sensible Workloads vor Ort, nutzen Sie die Flexibilität der Cloud jedoch für Analysen oder langfristige Speicherung.
- Optimierte Ressourcenauslastung. Priorisieren Sie Investitionen in die Infrastruktur nur dort, wo sie am wichtigsten sind.
- Skalierbarer Analyse-Umgebung. Verwenden Sie die Leistung der Cloud-Computing-Technologie für die Datenverarbeitung, maschinelles Lernen oder Echtzeit-Dashboards, ohne die On-Premise-Server zu überlasten.
- Verbesserte Widerstandsfähigkeit. Eine hybride EDW-Architektur kann durch die Aufteilung von Systemen in Cloud- und physische Umgebungen eine integrierte Redundanz und Disaster Recovery bieten.
Wählen Sie Hybrid, wenn Sie:
- Sie wechseln von Legacy-Systemen in die Cloud und benötigen einen schrittweisen Migrationspfad (z. B., Migration zu Mikroservices)
- arbeiten in einer regulierten Branche, möchten aber moderne Analysewerkzeuge nutzen, die nicht vor Ort unterstützt werden
- Verwalten von Daten aus mehreren Quellen und Regionen unter Berücksichtigung lokaler Aufbewahrungsbestimmungen
- Wollen die Cloud-Funktionalitäten testen, ohne eine vollständige Migration oder eine Verpflichtung zu übernehmen
- Sie möchten Ihre bestehende Infrastruktur erweitern, anstatt sie zu ersetzen, da diese für Ihr Unternehmen weiterhin von Nutzen ist.
Sie sollten Ihre Wahl des Implementierungsumfelds anhand Ihrer Geschäftsanforderungen und -anforderungen treffen. Aber die Zusammenarbeit mit einem Expertenteam für Daten oder einem Data-Engineering-Dienste Eine Agentur kann Ihnen vor vielen möglichen finanziellen Verlusten schützen.
Ein Data-Team kann Ihnen dabei helfen, Ihre bestehende Dateninfrastruktur in separate Komponenten aufzuteilen, die entscheidend für die richtige Entscheidung beim Auswahl einer Datenwarehouse-Hosting-Umgebung sind. Solche Komponenten können Datentechnologien, analytische Fähigkeiten, Transaktionsdatenbanken, ETL-Prozesse und Datentypen (strukturierte, semistrukturierte und unstrukturierte) umfassen. Fachliche Data-Experten wissen, wie kompliziert und vielschichtig diese Entscheidung sein kann und können verborgene Fallstricke aufzeigen, die für Sie möglicherweise nicht im Vordergrund standen. Nur ein ganzheitlicher Ansatz kann Ihnen dabei helfen, eine kluge Entscheidung mit einem hohen Potenzial für eine positive Investition zu treffen.
Die Erstellung eines Enterprise-Data-Warehouse Schritt für Schritt
Die Implementierung eines Data Warehouse ist glücklicherweise ein schrittweiser Prozess wie Digitale Transformation Und Sie müssen keine großen Investitionen auf einmal tätigen. Hier finden Sie eine Liste der Schritte, die Sie gemeinsam mit Ihren IT-Ingenieuren unternehmen sollten. Volle Prozessumgebung für die Entwicklung von maßgeschneiderten Lösungen Um ein Data Warehouse schrittweise erfolgreich aufzubauen und in Ihren täglichen Arbeitsablauf zu implementieren. Darüber hinaus werden wir einige der wichtigsten Elemente aus dieser Liste genauer besprechen.
Schritt 1. Geschäftsanforderungen definieren
Auf Ihre Geschäftsanforderungen abgestimmt, erstellen Sie eine detaillierte Liste mit priorisierten funktionalen und nicht-funktionalen Geschäftsanforderungen, da diese Einfluss auf Ihre Auswahl der Datenlagerungslösungen haben werden. Wenn Ihr Geschäftsumfeld beispielsweise ständig sich verändert, sollte eine Ihrer nicht-funktionalen Anforderungen Flexibilität sein. Wenn Sie in naher Zukunft planen, Ihr Unternehmen zu verändern und zu wachsen, sollte Ihre Priorität die Skalierbarkeit sein. Nutzen Sie bei der Definition und Handhabung Ihrer Geschäftsanforderungen die Hilfe eines qualifizierten Lösungskonstruktors. Lesen Sie weiter Unser Blogartikel erklärt, wie ein qualifizierter Architekt dies erreichen kann.
Schritt 2. Datenanalyse
Um sicherzustellen, dass in Ihr Data Warehouse nur relevante und korrekte Daten geladen werden, sollten Sie alle verfügbaren Datenquellen definieren. Es ist außerdem wichtig, Systemen zur Erfassung von Daten zu folgen, um unnötige Datensätze zu vermeiden. Einige Daten können nämlich Teil mehrerer Speichersysteme sein. Beispielsweise können Informationen zu Verkaufsaufträgen aus Ihrem Order Management System (OMS) in die Logistiksoftware für Ihre betrieblichen Anforderungen übertragen werden. Dennoch bleibt das OMS die Quelle der Wahrheit, da die Logistiksoftware die Daten manipulieren und potenziellen Erkenntnissen zu entbehren kann.
Schritt 3. Erstellen von konzeptionellen, logischen und physikalischen Datenmodellen
Nachdem Sie Ihre geschäftlichen Anforderungen definiert haben, ist es an der Zeit, ein erstes Modell für das Unternehmensdatenlager zu erstellen. Dieses Modell hilft Ihnen, Ihre wichtigsten Geschäftsprozesse, also Ihre Unternehmensstrukturen und deren Interaktion untereinander, schematisch darzustellen. Es ist entscheidend, diese Modelle mit Hilfe von Domänenexperten, Da jede Branche spezifische Geschäftsprozesse hat.
Ein konzeptionelles Datenmodell Es ist notwendig, klare Beziehungen zwischen den wichtigsten Geschäftseinheiten (Konzepten) zu etablieren, um die Informationsbedürfnisse eines Unternehmens zu definieren. Eine Supply-Chain-Firma kann beispielsweise Geschäftseinheiten wie Spediteure, Transportunternehmen, Lieferanten, Produkte, Bestellungen, Kunden und Hersteller unterscheiden.
Ein logisches Datenmodell ist eine detaillierte Version eines konzeptionellen Modells. Das logische Modell enthält Attribute (Spalten), die mit einer bestimmten Geschäftseinheit verknüpft sind, wie beispielsweise das Land eines Transportunternehmens für ein Transportunternehmen.
Ein physisches Datenmodell Es ist noch detaillierter, da es mehr Attribute zu Entitäten wie Primär- und Fremdschlüssel hinzufügt. Ein Primärschlüssel ist eine eindeutige Kennung, und es kann in einer Tabelle nur ein solcher Schlüssel geben. Ein Fremdschlüssel wird erstellt, um zwei Tabellen (Entitäten) miteinander zu verknüpfen. In der Praxis ist ein Fremdschlüssel ein Primärschlüssel aus einer Tabelle, der in eine andere Tabelle eingefügt wird.
Sie müssen sicherstellen, dass Ihr EDW-Datenmodell einfach an die Entwicklung Ihres Geschäfts angepasst werden kann. Geschäftsveränderungen können erhebliche Aktualisierungen des Datenumfelds erfordern, weshalb die Einbeziehung eines qualifizierten Informationsarchitekten erforderlich ist, um sicherzustellen, dass das Datenmodell flexibel genug ist.
Schritt 4. Identifizieren und erstellen Sie ein Schema für ein Data Warehouse
Dieser Schritt ist eine logische Fortsetzung des vorhergehenden. Sobald Sie klare Modelle Ihrer Geschäftsprozesse haben, können Sie mit der Erstellung der endgültigen und detaillierten Version beginnen. Datenmodellierungsprojekte — das physische Modell — in ein Data-Warehouse-Schema. Es gibt viele Arten von Schemas und Methoden, um diese automatisch zu generieren. Ihr Software-Architekt kann Ihnen helfen, die beste Vorgehensweise für die Einrichtung eines Data-Warehouse für Ihre Bedürfnisse auszuwählen. Um Ihnen einen umfassenden Überblick zu geben, werden wir in der nächsten Sektion einige davon besprechen – insbesondere die Star-Schema, den Snowflake-Schema und das Data-Vault-Schema.
Schritt 5. Implementieren Sie schrittweise eine Data-Warehouse-Architektur
Mit einem geeigneten Schema für ein Data-Warehouse können Sie ein Enterprise-Data-Warehouse-System erstellen. Es gibt mehrere Arten von Architekturen für Enterprise-Data-Warehouse-Systeme. Lesen Sie weiter, um herauszufinden, welche Sie wählen können und wie Sie ein Data-Warehouse erstellen.
Von der Festlegung der Anforderungen bis hin zur Implementierung der Architektur übernehmen wir den gesamten End-to-End-Prozess zur Entwicklung Ihres individuellen Unternehmensdatenlagers.
Komponenten, Schemata und Architekturdesigns für Enterprise-Datenlager
Kernkomponenten des EDW-Designs
Im Folgenden werden die häufigsten Komponenten beschrieben, die in das Unternehmensdatenwarehouse integriert werden können; nicht alle sind jedoch obligatorisch, und einige können je nach Geschäftsanforderungen individuell angepasst werden.
- Datenquellen. Diese Quellen stammen aus verschiedenen betrieblichen Datenlagern wie ERP, CRM, SCM und externen Datenquellen und liefern die Rohdaten, die in die EDW eingespeist werden.
- Aufbaubereich. Ein temporärer Speicherplatz, in dem Daten gesammelt und vorverarbeitet werden. Diese Ebene sorgt dafür, dass die Daten zuvor gereinigt und entsprechend transformiert werden, bevor sie in das Lager geladen werden.
- ETL-/ELT-Verfahren. Die Aufgabe besteht darin, Daten aus Quellen zu extrahieren, diese in ein geeignetes Format zu transformieren und sie in das Warehouse zu laden. Die ELT-Varianten laden zuerst die Daten und transformieren sie anschließend in der Warehouse-Umgebung.
- Speicherung in einem Datenlager. Das zentrale Repository, in dem integrierte, historische und thematische Daten gespeichert werden. Diese Speicherung ist für die Abfrageleistung und die analytische Verarbeitung optimiert.
- Metadaten-Repository. Eine Datenwarehouse-Komponente, die Informationen über den Ursprung, die Struktur und die Transformationen der Daten speichert. Metadaten erleichtern die Datenverwaltung, ermöglichen die Verfolgung der Herkunft und verbessern die Verständlichkeit der Daten für die Benutzer.
- Data-Marts. Subgruppen des Data Warehouse, die auf spezifische Geschäftsbereiche zugeschnitten sind und eine gezielte Analyse und Berichterstellung ermöglichen.
- Online-Analytische-Verarbeitung (OLAP)-Quellen. Mehrdimensionale Datenstrukturen ermöglichen komplexe analytische Abfragen, wie Trendanalysen und Prognosen, indem Daten vorab aggregiert werden, um eine schnellere Abfrage zu ermöglichen.
- Zugriffstools und APIs. Schnittstellen und Tools, die es Benutzern ermöglichen, mit dem Data Warehouse zu interagieren, einschließlich BI-Tools, Dashboards und APIs für individuelle Anwendungen.
- Datensicherheits- und Governance-Schicht. Mechanismen zur Gewährleistung der Datensicherheit, der Compliance und der Integrität. Dazu gehören rollenbasierte Zugriffssteuerung, Verschlüsselung und Überprüfungspfade.
- Überwachung und Management-Tools. Enterprise-Datenwarehouse-Tools überwachen die Leistung, Verfügbarkeit und den Zustand des Datawarehouse und sorgen so für optimalen Betrieb und eine schnelle Problembehebung.
Schemas für Datenlagerhäuser
Es gibt drei Schemaarten für Data Warehouses: Die Star-Schema-, Snowflake-Schema- und Data Vault-Schema. Ein Schema legt die Beziehungen zwischen Datensätzen in einem Data Warehouse fest, um diese für die Abfrage und weitere Analyse bereit zu machen.
Jedoch entscheiden sich bestimmte Unternehmen dafür, keine Schemas zu erstellen, sondern stattdessen eine Reihe flacher Tabellen zu erstellen, um mehrere Datenspalten in eine einzige Tabelle einzubinden. Diese Herangehensweise berücksichtigt jedoch nicht die Datengranularität und die Schwierigkeit, Änderungen an Tabellen vorzunehmen. Daher sind Schema-Designs entstanden, da sie mehr Flexibilität und eine bessere Datenstruktur bieten.
Sternschema
Dies ist die häufigste und traditionellste Art, ein Data Warehouse zu erstellen. Ein Star-Schema besteht aus Faktentabellen und Dimensionstabs. Um besser zu verstehen, wie es aufgebaut wird und zu welchem Zweck es verwendet wird, nehmen wir als Beispiel ein typisches Star-Schema für ein Gesundheitsunternehmen.
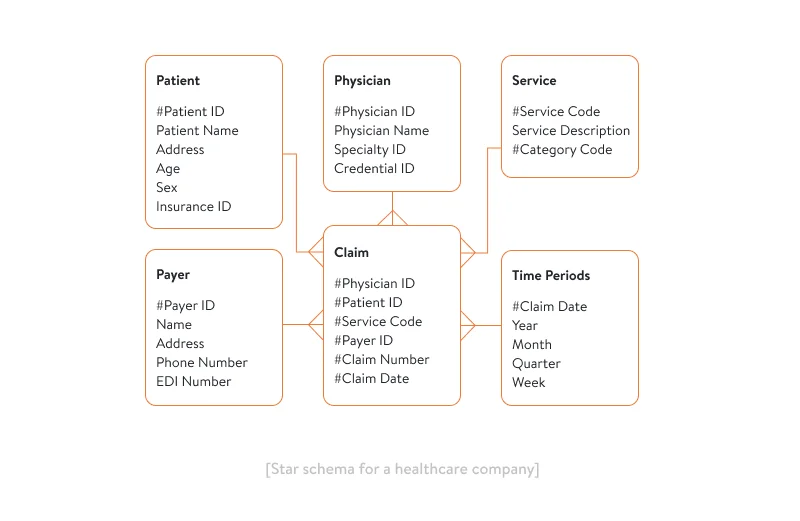
Die Tabelle in der Mitte ist eine Faktentabelle, die Schlüssel enthält, um jede Dimensionstabelle zu definieren. Jede Dimensionstabelle enthält wiederum Dimensionattribute. Eine Dimensionstabelle für einen Patienten könnte beispielsweise solche Attribute enthalten wie den Patientennamen, die Adresse, das Alter, das Geschlecht und die Krankenversicherungsnummer.
Vorteile eines Sternschema:
- Einfach zu entwerfen und einzurichten, dank der einfachen Beziehung zwischen Datensätzen
- Datenanalysten können dank einer vereinfachten Join-Logik zwischen der Faktentabelle und den Dimensionstabs schnell Daten abfragen.
Nachteile eines Sternschemas:
- Weniger Flexibilität im Vergleich zu anderen Schemas und nicht geeignet für komplexe analytische Abfragen
- Hoher Grad an Datenredundanz und -duplikation
Snowflake-Schema
Ein weiteres Schema für Datenlagerung ist das Snowflake-Schema. In der Praxis ist das Snowflake-Schema eine erweiterte und normalisierte Variante des Star-Schemas. Das Snowflake-Schema enthält außerdem Faktentabellen, deren Dimensionentabellen jedoch in mehrere zusätzliche Dimensionentabellen aufgeteilt werden. Nehmen wir das gleiche Beispiel eines Healthcare-Star-Schemas und transformieren es in ein Snowflake-Schema.
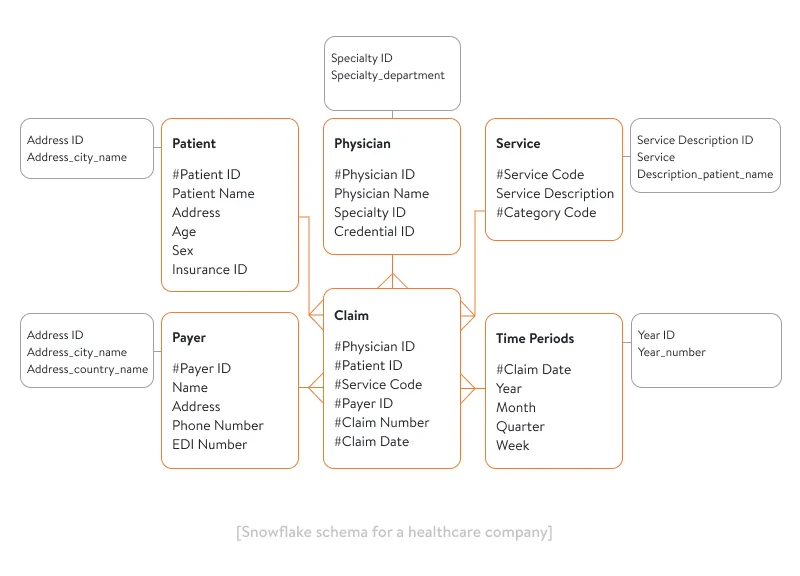
Wir haben ein sehr vereinfachtes Schneeflockenschema erstellt, das aber dennoch seine Essenz wiedergibt. Wir haben lediglich eine zusätzliche Dimension in jede der ursprünglichen Tabellen eingefügt, aber es kann mehr als eine Dimension geben. Deshalb kann ein Schneeflockenschema recht komplex werden.
Vorteile eines Schneeflockenschemas:
- Eliminiert Datenredundanz und -duplikation, da jedes Dimensionattribute eine eigene Tabelle erhält und nicht mit ähnlichen Attributen vermischt wird
- Bietet mehr Möglichkeiten für Datenanalysen als ein Star-Schema aufgrund der komplexeren Beziehungen zwischen Datensätzen.
Nachteile eines Schneeflockenschemas:
- Schneeflockenschema werden schwieriger zu entwerfen und zu verwalten als Sternschema
- Die komplexe Anordnung von Datensätzen innerhalb eines Snowflake-Schemas erschwert Datensuchanfragen und führt zu längeren Durchlaufzeiten als bei einer Star-Schema-Architektur.
Datenspeicher
Ein Data Vault ist ein hybrider Ansatz für die Datenwarehouse-Design, der das Beste aus der Star-Schema-Technik und der dritten normalen Form (3NF) (einer anderen Art normalisierter Datenschema) kombiniert. Der Erfinder des Data Vaults, Dan Lindstedt, sagt, dass ein Data Vault perfekt für moderne Enterprise-Datenwarehouse-Lösungen geeignet ist. Der aktuellste Version ist Data Vault 2.0.
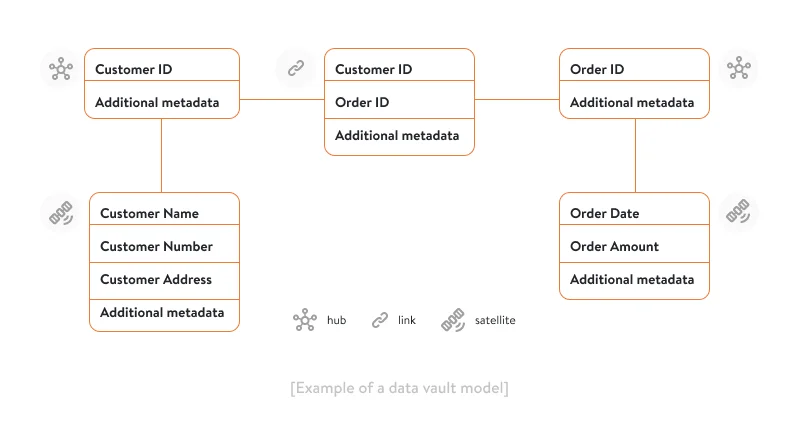
Ein Data Vault 2.0 enthält sowohl Rohdaten als auch Geschäftsdaten; das Rohdaten-Vault enthält alle Rohdaten innerhalb des Unternehmens zusammen mit Datendubletten, während das Business-Vault eine darüber liegende Ebene darstellt, die aus Geschäftsregeln und Berechnungen besteht. Das Rohdaten-Vault besteht aus drei Komponenten:
- Hubs Sogenannte Business Keys sind Einheiten, die eine Verbindung zu einem bestimmten Datensatz herstellen. Falls keine direkte Business Key verfügbar ist, werden Hubs auch Ersatzkeys verwenden, um ihre Datenobjekte zu identifizieren.
- Links Sie dienen als Verbindungsstufen zwischen verschiedenen Hubs und schaffen Beziehungen zwischen Geschäftsknotenpunkten.
- Satelliten Beschreibungstabellen sind mit Hubs verbunden. Jede Hub- oder Verbindungsstelle kann einen oder mehrere Kind-Satelliten enthalten. Die Satelliten enthalten außerdem Metadaten, die sie mit ihrer übergeordneten Hub- oder Verbindungsstelle verknüpfen.
Hubs und Links sind strukturelle Elemente eines Data Vault-Modells, während Satelliten den Kontext für die in den Hubs und Links festgelegten Geschäftsprozesse bieten. Das Data Vault ist ein komplexeres und skalierbares Modell als die Star- und Snowflake-Schemas. Im Folgenden ist ein vereinfachtes Beispiel für die Verteilung von Kundendaten und Bestellinformationen im Data Vault-Modell dargestellt.
Vorteile eines Data Vaults:
- Flexibel und skalierbar hinsichtlich der Anbindung oder Deaktivierung von Datenquellen (kann auf Hunderte von Terabyte oder Petabyte erweitert werden)
- Ein ETL-Prozess kann mit einem Data Vault schnell und einfach automatisiert werden und gleichzeitig Daten an Hubs, Links und Satelliten heruntergeladen werden.
- Die Data Vault-Modellierungstechnologie ermöglicht es, Geschäftsprobleme zu erkennen, die zuvor aufgrund mehrerer Datenverknüpfungen nicht offensichtlich waren.
Nachteile eines Data Vaults:
- Nicht geeignet für statische Daten mit geringen oder gar keine Änderungen
- Nicht für eine reibungslose Abfrageleistung optimiert und erfordert oft die Erstellung von Datenmarts als Präsentationsebene.
Um die richtige Wahl der Datenlagerungstools zu treffen, sollten Sie die Technologie-Stack und die Tools berücksichtigen, die Sie zur Analyse der Daten verwenden werden. Zum Beispiel funktioniert das Business Intelligence-Tool von Tableau mit einfachen Flachtabellen; dieses System kann es nämlich nicht so viele Datenverbindungen verarbeiten wie bei den Stern- und Schneeflockenschemata. Power BI kann Sternschemata problemlos verarbeiten.
Der Entwicklungsprozess eines Data Warehouse ist inkrementell und fortlaufend. Laut Inmon kann er folgendermaßen aussehen:
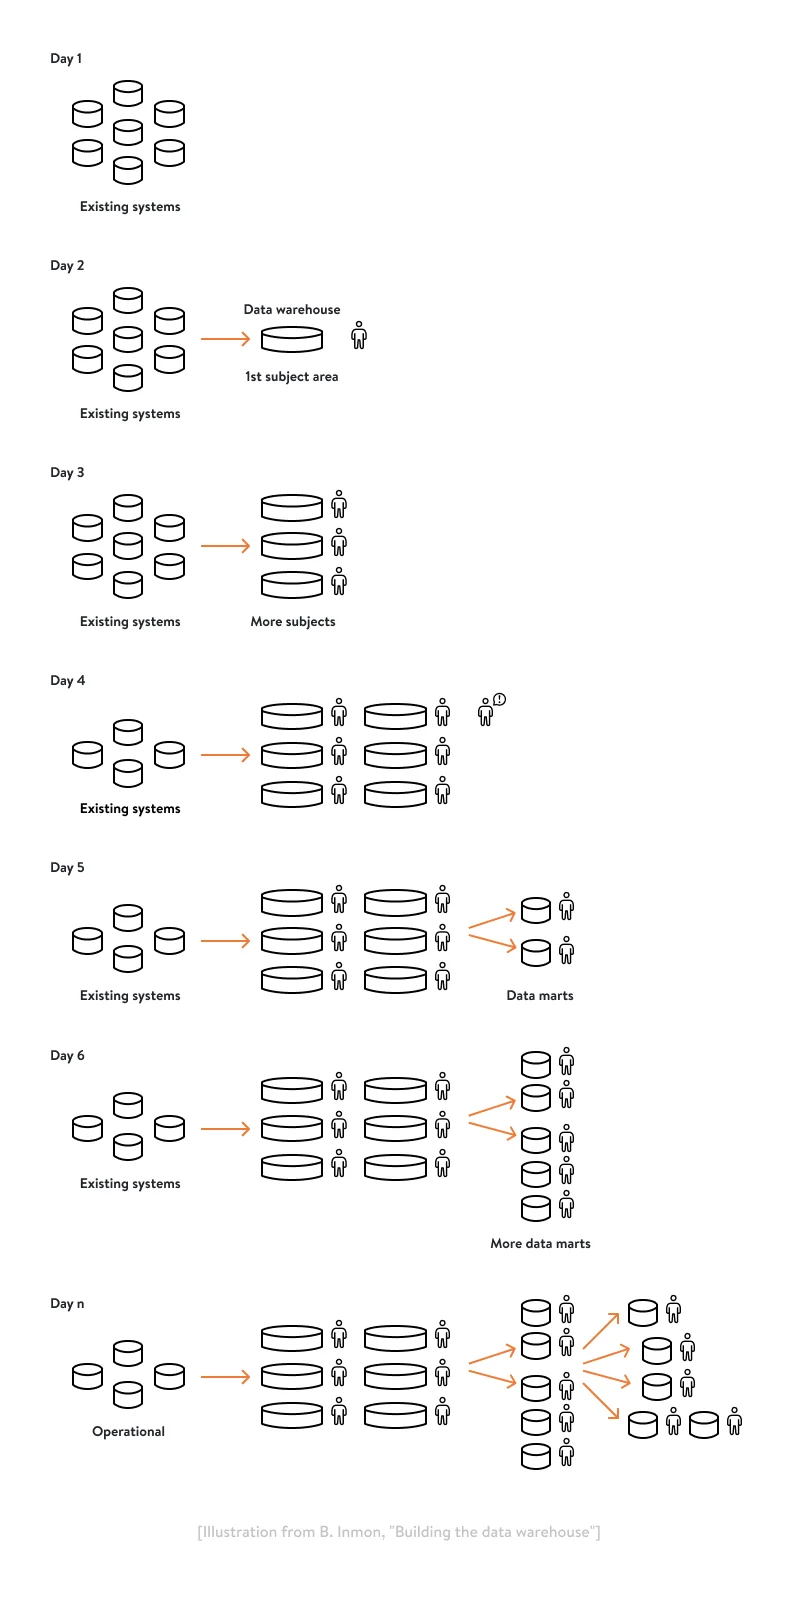
Dieser Prozess erfolgt nicht zwangsläufig innerhalb weniger Tage, und das obige Schema ist eher vereinfacht und beschleunigt. Zunächst implementieren Sie ein Fachgebiet für Ihr Data Warehouse und haben eine kleine Anzahl von Analysten, die diese Daten für Berichterstellung verwenden können.
Anschließend fügen Sie weitere Themenbereiche hinzu und mehr Personen erhalten Zugriff auf Daten. Anschließend beginnen Sie, mithilfe von EDW-Modulen einige Data Marts zu erstellen, um die Datennutzung zu organisieren und zielgerichtete Datenabfragen zu ermöglichen. Anschließend können Sie mit weiteren EDW-Modulen und Datenverbrauchern noch weiter skalieren. Ganz im Allgemeinen können Sie Ihre EDW skalieren, solange Ihr Unternehmen skaliert, Ihr Datenvolumen wächst und Ihre Informationsbedürfnisse im gesamten Unternehmen zunehmen.
Das obige Schema von Inmon lässt sich in drei Strategien zur Entwicklung eines Data Warehouse unterteilen:
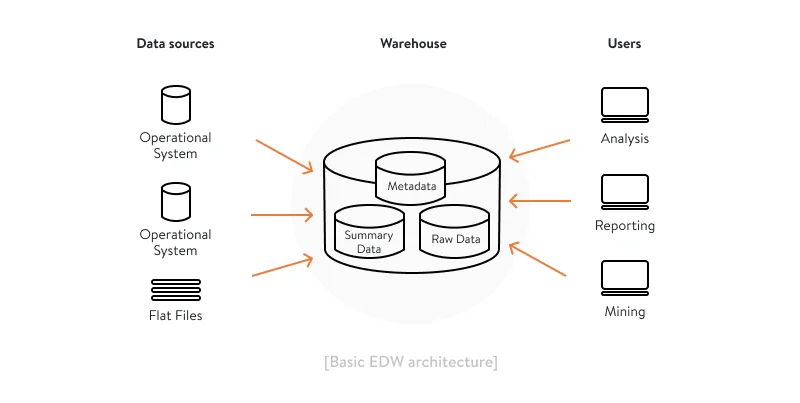
Grundlegende Architektur
Dieses Beispiel einer Enterprise-Data-Warehouse-Architektur entspricht grob dem, was Inmon bei der Implementierung eines Data-Warehouse an erste Stelle hatte. Es ist jedoch kaum möglich, das volle Potenzial eines Enterprise-Data-Warehouse mit einer einfachen Architektur zu erschließen. In diesem Stadium konfigurieren Sie einfach den Datenfluss von Ihren Unternehmensdatenquellen zu einer neuen Einheit – dem Enterprise-Data-Warehouse-Software.
Architektur mit einer Aufstellungsfläche
Diese Architektur deutet bereits auf die Einrichtung eines Data-Warehouse mit einer ETL-Logik (Extract, Transform, Load) hin, indem eine Staging-Area implementiert wird. In diesem Punkt Ihrer EDW-Implementierung werden Sie beginnen, Geschäftsadressen aus Ihren Stammdatensystemen in das Data-Warehouse zu laden, indem eine Staging-Area verwendet wird, die Daten reinigt und transformiert, um sie an den erforderlichen Ort im Data-Warehouse und im erforderlichen Format zu bringen.
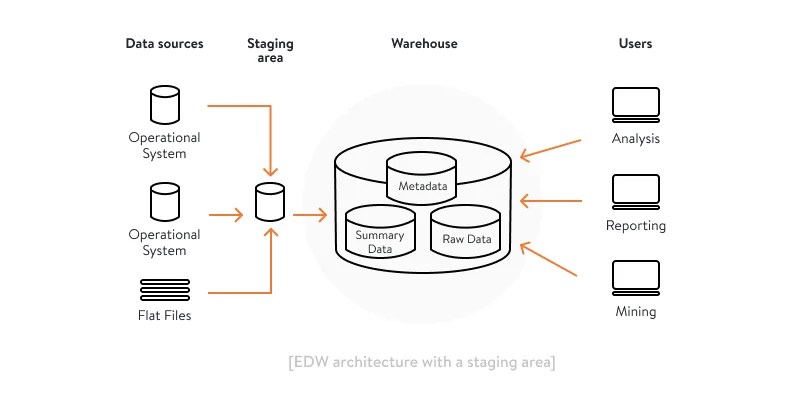
Architektur mit einer Staging-Area und Data Marts
Um die Datensuche zu vereinfachen und verschiedenen Abteilungen gleichzeitig nur die Datensätze zur Verfügung zu stellen, die sie für ihre geschäftlichen Zwecke benötigen, können Sie zudem auf Ihrem Data Warehouse Datenmengenstrukturen erstellen.

Das Endergebnis ist eine geschichtete Architektur für ein Unternehmensdatenlager, die vollständig in Ihr Unternehmensdatenmanagement-Framework integriert ist:

- Die Inhaltsschicht ist ein Zwischenspeicher, der Daten vorbereitet, bevor sie in das Data Warehouse geladen werden.
- Die Speicher-Schicht besteht aus dem Data Warehouse selbst und den Data Marts, die Daten speichern und in den richtigen Stellen und Formaten aufbewahren, damit sie für analytische Zwecke verfügbar sind.
- Die Präsentationsschicht ermöglicht die Abrufung der notwendigen Daten mithilfe verschiedener Business-Intelligence-Tools und Web-Services, um diese als Einblicke zu visualisieren, zu analysieren und anzuzeigen, anstatt sie lediglich als Tabellen und Spalten darzustellen.
Best Practices für die Implementierung und Unterstützung von EDW
- In die Planung von Anfang an einbeziehen Sie Unternehmensanwender. Es sind nicht nur Ihre Softwaresysteme, sondern auch Mitarbeiter, die wichtige Geschäftsdaten verwalten. Die Durchführung individueller Interviews mit verschiedenen Stakeholdern im Unternehmen kann Ihnen helfen, eine bessere Vorstellung von wichtigen Datenquellen, den wichtigsten Geschäftsproblemen und fehlerhaften Kundenerfahrungen zu gewinnen, die Ihnen Kosten verursachen.
- Arbeiten Sie mit einem Experten-Data-Team zusammen. In diesem Artikel erwähnen wir immer wieder, dass Sie bei der Implementierung eines Data-Warehouse unbedingt mit Data-Professionals zusammenarbeiten sollten – insbesondere auf unternehmensweiter Ebene. Die Implementierung eines EDW umfasst Architektur, Governance, ETL-Pipelines und Analyse-Workflows. Ein kompetentes Data-Team (intern oder extern) kann skalierbare Systeme entwerfen, Leistungsengpässe vermeiden und von Anfang an die richtigen Tools auswählen – was Ihnen später Geld und Zeit spart.
- Planen Sie für die zukünftige Skalierbarkeit und Integration. Ihr EDW sollte in der Lage sein, sowohl das Wachstum der Datenmengen als auch die zunehmende Komplexität des Geschäfts zu bewältigen. Wählen Sie eine Architektur und Tools, die mit Ihnen wachsen können, und stellen Sie sicher, dass sie mit Ihrem umfassenderen Datenökosystem (BI-Tools, KI-/ML-Plattformen usw.) kompatibel sind.
- Mit dem Zug fahren und Wissen vermitteln. Organisieren Sie praktische Schulungen für Analysten, Manager und Entscheidungsträger. Dokumentieren Sie Prozesse, erstellen Sie leicht nachvollziehbare Anleitungen und ernennen Sie interne Ansprechpartner, die andere unterstützen können.
- Einstellen eines CDO/CAO. Die Einstellung eines Chief Data oder Analytics Officers ist ein großer Schritt, aber stellen Sie sicher, dass er in die Strategie integriert ist und nicht isoliert in der IT verwaltet wird. Geben Sie ihm die Befugnis und den Budgetrahmen, um über funktionsübergreifende Datenentscheidungen Einfluss zu nehmen.
Bereit, Ihr Unternehmensdatenwarehouse zu implementieren?
Lassen Sie uns von Diskussionen und Überlegungen zu tatsächlichen Maßnahmen absehen. Wenn die Entwicklung und Implementierung einer EDW schon eine Weile in Ihrem Kopf und auf Ihrer Geschäftsagenda steht, ist es an der Zeit, anzufangen. Sie können eine EDW stetig und schrittweise entwickeln und implementieren. Und wir können Ihnen während des gesamten Prozesses zur Seite stehen. Erinnern Sie sich an die Schritte zur Erstellung eines Data Warehouse? Sie können alle diese Schritte gemeinsam mit unseren Fachleuten aus dem Bereich der Domänenanalyse und technischen Spezialisten durchführen. Auf diese Weise stellen wir sicher, dass wir eine maßgeschneiderte Lösung entwickeln, um Ihre aktuellen Herausforderungen im Bereich der Datenverwaltung zu bewältigen.
FAQ
Welche Geschäftsprobleme kann eine Enterprise-Data-Warehouse-Strategie lösen?
Eine EDW hilft dabei, Datensilos zu eliminieren, die Verzögerungen bei der Berichterstellung zu reduzieren und die Entscheidungsfindung zu verbessern, indem alle wichtigen Daten in einem zentralen Repository gespeichert werden. Sie ermöglicht die Zusammenarbeit zwischen verschiedenen Fachbereichen, da Ihre Mitarbeiter leicht auf genaue Erkenntnisse zugreifen und datenbasierte Entscheidungen treffen können.
Ist die Erstellung eines Data-Warehouse für mittelständische Unternehmen geeignet?
Absolut notwendig, insbesondere wenn Sie schnell skalieren oder sich auf Daten für strategische Entscheidungen verlassen. Eine gut ausgelegte EDW hilft mittelständischen Unternehmen, agil zu bleiben, die Datengenauigkeit zu verbessern, Daten aus unterschiedlichen Quellen zu integrieren und fortschrittliche Analysen zu unterstützen, ohne den Chaos von zerstreuten Tabellenkalkulationen und Systemen zu erleben.
Wie lange dauert es normalerweise, eine EDW einzuführen?
Es hängt von Ihren Zielen, der Datenkomplexität und dem Team ab. Eine grundlegende EDW-Implementierung kann 3–4 Monate dauern, während eine umfassendere Implementierung 6–12 Monate dauern kann. Ein schrittweiser Rollout ist oft der klügste Weg, um frühzeitig Wert zu liefern und schrittweise zu skalieren.
Wie sicher ist ein Unternehmensdatenlager für die Speicherung sensibler Daten?
Wenn sie in der für Ihr Unternehmen optimalen Hosting-Umgebung ordnungsgemäß implementiert werden, ist eine EDW äußerst sicher. Dank rollenbasierter Zugriffssteuerung, Verschlüsselung, Überwachungswerkzeugen und Compliance-Unterstützung (wie HIPAA, GDPR oder ISO 27001) kann sie selbst den sensibelsten Unternehmensdaten sicher begegnen, ob lokal oder in der Cloud.
Sollten wir eine cloudbasierte oder eine lokale EDW-Lösung wählen?
Das hängt von Ihrem Budget, Ihrer internen Expertise, Ihrer Infrastruktur und der Sensitivität Ihrer Daten ab. Die Cloud bietet eine schnellere Einrichtung, eine einfachere Skalierung und geringere Betriebskosten. Ein On-Premise-System ist sinnvoll, wenn Sie die volle Kontrolle benötigen, strenge Compliance-Standards erfüllen oder bereits über eine robuste interne Infrastruktur verfügen.
Wie können wir eine EDW im Laufe der Zeit aufrechterhalten und skalieren?
Der anhaltende Erfolg hängt von proaktiver Überwachung, regelmäßigen Überprüfungen der Datenqualität und der Anpassung der Architektur an die sich ändernden Geschäftsanforderungen ab. Ob in der Cloud oder lokal – eine gute EDW sollte eine modulare Skalierung unterstützen und Ihnen die Möglichkeit bieten, neue Datenquellen, Benutzer oder Analysewerkzeuge hinzuzufügen, wenn Sie wachsen.
Über den Autor