Sind Sie sicher, dass Sie alle Daten sammeln, die Ihr Unternehmen benötigt? Wir sind sicher, dass Sie das tun. Aber diese Daten sind höchstwahrscheinlich unter verschiedenen Unternehmenssystemen verstreut und möglicherweise sogar in separaten Systemen gespeichert. Dadurch verpassen Sie wichtige Informationen bei der Auswertung Ihrer Daten. Um Ihre Unternehmensdaten zu analysieren und daraus wertvolle Erkenntnisse zu gewinnen, sollten Sie ein zentrales Datenarchiv erstellen und pflegen.
Die Implementierung eines Datenlagers ist jedoch nicht nur in Bezug auf die Datenverwaltung, sondern auch in Bezug auf Geschäftsprozesse transformativ. Daher ist es entscheidend, eine ausgewogene Wahl aus einer ganzen Reihe von Datenlagern zu treffen, die auf dem Markt verfügbar sind. In diesem Artikel stellen wir Ihnen eine Vergleichsliste an Datenlagern vor, um Ihnen zu helfen, die am besten geeignete zu wählen – oder vielleicht sogar mehrere. Lassen Sie uns mit den Herausforderungen beginnen, mit denen Sie sich derzeit bei der täglichen Datenverwaltung möglicherweise konfrontiert sehen.
Lesen Sie auch: Unsere Expertise bei der Entwicklung maßgeschneiderter Data Science-Lösungen
Probleme, die mit einem Datenarchiv gelöst werden können
Je digitaler unsere Welt wird, desto mehr Daten generieren wir. Ein Prozess der digitalen Transformation Die vollständige Entfaltung seiner Möglichkeiten wird nicht möglich sein, wenn eine Organisation die Daten, die jede digitale Lösung erfasst, nicht richtig analysiert. Ein Datenrepository ermöglicht eine detaillierte Datenanalyse und hilft Organisationen, wertvolle Erkenntnisse aus Terabyte an unterschiedlichen Datensätzen zu gewinnen.
Die Datenverwaltung bringt viele Herausforderungen mit sich. Aber ein geeigneter Datenspeicher kann die Probleme lösen. Hier sind typische Herausforderungen aufgeführt, die Datenspeicher bewältigen können.
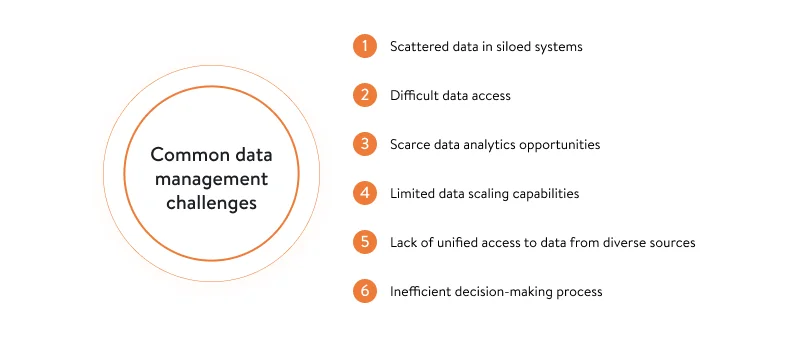
- Verstreute Daten in gesonderten Systemen. Geschäftsinformationen, die in verschiedenen Datenbanken verstreut sind, stellen eine ernsthafte Einschränkung auf dem Weg zu einer effizienten Datenverwaltung und Datenanalyse dar. Datenrepository-Plattformen dienen als einzige Quelle der Wahrheit für Ihre Organisation und helfen, zu verhindern, dass aussagekräftige Daten in veralteten, gespaltenen Systemen verbleiben.
- Problematischer Datenaustausch. Je mehr Zugänge zu Daten es gibt, desto schwieriger wird es und desto länger dauert es, die richtigen Daten zu finden. Ein Datenrepository ermöglicht es Ihrem Analytikteam, über einen einzigen Zugangspunkt problemlos auf alle Datensätze zuzugreifen, die sie benötigen, um Abhängigkeiten zwischen Datenelementen zu erkennen. Außerdem erleichtert ein zentrales Datenrepository die Verwaltung der Zugriffsrechte.
- Mangelhafte Möglichkeiten für Datenanalyse. Beschäftigung Datenwissenschaftliche Dienstleistungen Sie können ungenutzten Potenzial in Ihren Datensätzen aufdecken und Ihrem Team dabei helfen, aussagekräftigere Erkenntnisse zu generieren, die auf die sich entwickelnden Geschäftsanforderungen zugeschnitten sind. Wenn Sie bereits seit Jahren eine bestimmte Datenanalysemethode anwenden, könnten Sie an einem Punkt stehen, an dem Ihre Datenberichte für Ihre aktuellen Geschäftsanforderungen nicht mehr relevant sind. Die Einrichtung eines Datenlagers ermöglicht es Ihnen, Ihre Geschäftsanomalien aus verschiedenen Perspektiven einfach zu analysieren. Ohne ein Datenlager müssten Sie viel mehr Zeit in die Erstellung separater Pipelines investieren, um Daten direkt aus Ihren Unternehmenssystemen abzurufen.
- Begrenzte Skalierbarkeit der Daten. Wenn ein Unternehmen wächst, wächst auch die Datenmenge. Es wird immer schwieriger, diesen stetig wachsenden Datenstrom überhaupt zu speichern, geschweige denn zu katalogisieren und zu analysieren. Sie können ein Datenrepository implementieren, das sich an die steigende Datenmenge anpassen kann, um sicherzustellen, dass Sie nie an Kapazitäten für die Speicherung und Analyse Ihrer Geschäftsinformationen ausgehen.
- Mangel an einem einheitlichen Zugang zu Daten aus verschiedenen Quellen. Heute kann alles eine Datenquelle sein: Nachrichtenwebsites, Twitter-Beiträge, Instagram-Reaktionen, IoT- und Telematik-Geräte (IoT Lösungen für die Gesundheitsversorgung). Mit modernen Datenrepository-Lösungen wie denen von AWS und Microsoft Azure ist es möglich, Daten aus externen Quellen (wie oben beschrieben) und internen Quellen (einschließlich Ihres ERP-, CRM- oder ähnlichen Systems) zu integrieren. Dadurch können Sie Ihr Unternehmen ohne großen Aufwand aus verschiedenen Perspektiven betrachten.
- Ineffizienter Entscheidungsprozess. Idealerweise sollte jede Geschäftsentscheidung auf zuverlässigen Fakten basieren. Datengetriebene Geschäftslandschaften ermöglichen es Führungskräften, selbstbewusster zu sein, ambitionierter zu agieren und weniger riskante Entscheidungen zu treffen. Je mehr Daten Sie sammeln und analysieren, desto besser ist die Grundlage, um effizientere Geschäftsergebnisse zu erzielen.
Nun, da wir die Definition von Datenrepositories im Allgemeinen betrachtet haben, gehen wir in diesem Abschnitt jeweils auf die einzelnen Typen von Datenrepositories ein, um deren Unterschiede, Gemeinsamkeiten und Anwendungsfälle herauszuarbeiten. Alle besten Datenrepositories haben ein gemeinsames Ziel: die Bereitstellung neuer Möglichkeiten für die Datenanalyse in Ihrer Organisation.
Lesen Sie auch: Wie wir eine Echtzeit-Lösung für die Verarbeitung von Wahldaten implementiert haben
Data Lake vs Data Warehouse vs Data Mart
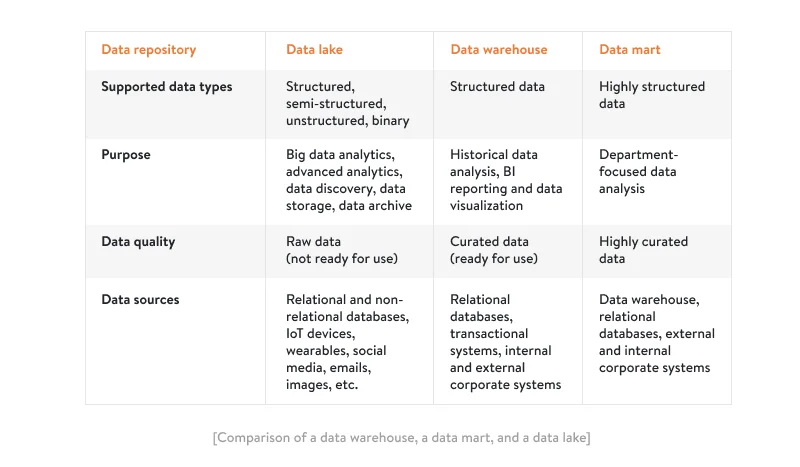
In diesem Abschnitt konzentrieren wir uns auf drei Haupttypen von Datenrepositories.
Lassen Sie uns mit einem Data Lake beginnen. Wir werden klar definieren, was ein Data Lake ist, verschiedene Datenspeichermodelle vorstellen und Ihnen zeigen, wie Sie einen Data Lake erstellen können.
Lesen Sie auch: Wie wir einen Data Lake für ein Fertigungsunternehmen implementiert haben
1. Datensee
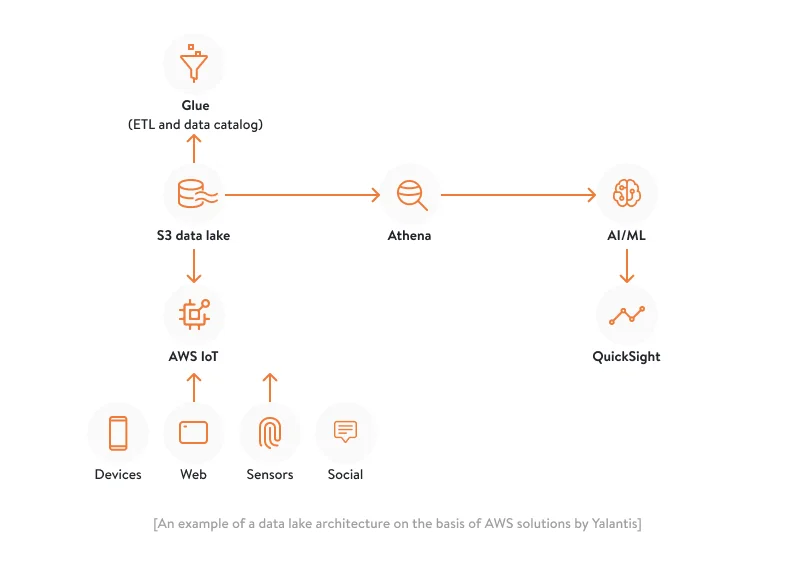
Ein Data Lake ist eine zentrale Repository-Datenbank, die jede Art von Rohdaten speichern kann, einschließlich strukturierten, semistrukturierten, unstrukturierten und binären Daten aus verschiedenen Quellen. Diese Daten können aus Social-Media-Plattformen, Websites, IoT-Geräten oder RFID-Tags stammen – allesamt Bestandteile des Big-Data-Flusses. Folgende Architekturdarstellung zeigt ein Projekt, in dem wir ein Data Lake für ein Fertigungsunternehmen implementiert haben. Um ein Data Repository für dieses Unternehmen erfolgreich einzusetzen, entwickelten wir eine ausgeklügelte Architektur für das Data Lake mit der AWS Data Lake-Technologie. Big Data-Lösungen Dies hat die Verwaltung und Verarbeitung dieser Daten optimiert und ermöglicht bessere Erkenntnisse und Entscheidungen. Sie können sich auch eine Big-Data-Analysesoftware ansehen, die wir für ein 3PL-Unternehmen entwickelt haben.
Warum ein Data Lake?
- Erweiterte Analysen. Dank der vielseitigen Möglichkeiten der großen Datenmengen, die Data Lakes speichern können, können Data Scientists und Data Lake-Architekten maschinelles Lernen (ML) und künstliche Intelligenz (KI)-Algorithmen nutzen, um tiefgreifende analytische Erkenntnisse zu generieren.
- Forschung und Entdeckung. Rohdaten in Data Lakes können die perfekte Grundlage für alle Arten von analytischen Untersuchungen sein, die mit Hilfe eines traditionellen Data Warehouse nicht möglich wären.
Beispiel:
Der Hersteller und Vertriebspartner medizinischer Geräte DRG Diagnostics hat seine Datensätze auf einen Cloud-Datenspeicher übertragen, um aus großen Datensätzen aus dem Gesundheitswesen aussagekräftige Erkenntnisse zu gewinnen. Die Ergebnisse dieser Umstellung waren erstaunlich. Innerhalb der ersten drei Monate der Implementierung gelang es dem Unternehmen, Folgendes zu erreichen:
- Erhalte 1,5 Mal mehr Produktivität
- Unterstützt fünfmal mehr Benutzer
- mehr als 100 Terabyte an Daten an Bord
Data Lake vs. Data Warehouse:
- Ein Data Lake Speichert Rohdaten, die nicht sofort für die Datenanalyse bereit sind, während ein Data Warehouse Sie speichert strukturierte Daten (kuratierte Daten), die für Business Intelligence-Berichte und Datenvisualisierung bereit sind.
- Ein weiterer Unterschied zwischen einem Data Lake und einem Data Warehouse besteht darin, dass ein Data Lake Kann Echtzeitdaten empfangen, während ein Data Warehouse Speichert historische Daten.
- Daten aus ein Data Lake ist für fortgeschrittene Analysen und die Entwicklung von KI-/ML-Algorithmen geeignet, während Daten in ein Data Warehouse ist am besten für Business Intelligence geeignet.
Mit dem richtigen Lieferung von bi-Lösungen, Damit können Unternehmen Daten aus einem Data Warehouse nutzen, um umfassende Berichte und Visualisierungen zu erstellen und Entscheidungsträgern die Möglichkeit zu geben, fundierte Entscheidungen zu treffen.

Data Lake vs. Data Mart:
- Ein Data Lake ist viel größer als Ein Data-Mart.
- Es ist einfacher zu warten und zu verwalten ein Data-Mart im Vergleich zu einem großen Data Lake.
- Aufgrund der fachspezifischen Natur von Data Marts können Datenanalysten Daten schnell aufrufen. ein Data-Mart Um Entscheidungen auf departementspezifischer Ebene zu erleichtern. Obwohl die Daten in ein Data Lake Da die Daten in einem Katalog gespeichert sind, kann es länger dauern, die notwendigen Informationen zu extrahieren als bei einer Data Mart-Anwendung.
- Ein Data Lake bietet viel vielfältigere Datensätze, die den Data Scientists mehr Flexibilität bei der Datenmodellierung bieten (Beispiele für Datenmodellierung), wobei ein Data-Mart Hilft bei der Erstellung eher einfacherer Erkenntnisse.
Im nächsten Abschnitt besprechen wir Data Warehousing und beantworten eine häufig gestellte Frage: Was ermöglicht Data Warehousing für Organisationen?
Lesen Sie auch: Wie wir Finanzdaten von Kunden für eine Plattform für Finanzberatungsdienstleistungen aggregiert haben
2. Datenlager
Was ist ein Data-Warehouse-Repository? Es ist ein Datenrepository, das strukturierte historische Daten speichert. Mithilfe eines ETL-Engines (Extract, Transform, Load) werden Daten aus verschiedenen Datenquellen wie Transaktionsdatenbanken, Datenbanken, dem Web, Logdateien und Data Lakes in das Data-Warehouse übertragen.

Es gibt zwei wesentliche architektonische Ansätze zur Erstellung eines Data Warehouse: den von Inmon und Kimball.
- Inmon’s architektonisches Konzept wird auch als Unternehmen-Informationsfabrik. Dieser Ansatz sieht vor, ein unternehmensweites Datenwarehouse zu entwickeln, in dem alle strukturierten Daten des Unternehmens gespeichert werden.
- Kimballs Ansatz wird als Dimensionale Modelldatenbank. Dieser Ansatz ermöglicht eine schnelle Berichterstattung, ohne dass die gesamte Datenmenge gesammelt werden muss, um eine einzige Quelle der Wahrheit innerhalb eines Unternehmens zu schaffen.
Die Wahl des architektonischen Ansatzes hängt weitgehend von den Bedürfnissen des Unternehmens ab. Aber Inmons Datenmanagement-System ist häufiger anzutreffen.
Warum ein Data Warehouse?
- BI-Datenvisualisierung. Ein Data Warehouse ist die geeignetste Datenquelle für BI-Tools. Ein gut strukturierter Data Warehouse ermöglicht eine schnelle Datenabfrage und eignet sich daher gut zur Erstellung detaillierter BI-Berichte und Dashboards täglich.
- Online-analytische Verarbeitung (OLAP). Mit dieser Software können Datenanalysten gleichzeitig Erkenntnisse aus Daten in verschiedenen Datenbanken extrahieren. Da ein Data Warehouse saubere und strukturierte Daten aus dem gesamten Unternehmen speichert, können diese Daten einfach in einen OLAP-Server importiert werden, um eine detaillierte Analyse durchzuführen.
Beispiel:
Die Führungskräfte des Texas Children’s Hospital haben $4,5 Millionen an direkter Nutzen aus ihren vier Enterprise-Data-Warehouse-Projekten erzielt. Nun werden alle relevanten Daten, die das Krankenhaus erfasst, gesammelt, strukturiert und analysiert, um operative Erkenntnisse zu gewinnen, anstatt in separaten Systemen wie elektronischen Patientenakten (EHR) gefangen zu bleiben.
Anschließend werden wir die Definition eines Data Marts und die Erstellung eines Data Marts besprechen. Am Ende des folgenden Abschnitts werden wir den wesentlichen Unterschied zwischen einem Data Warehouse und einem Data Mart zusammenfassen.
Lesen Sie auch: So erstellen Sie ein Enterprise Data Warehouse von Grund auf
3. Datenmarkt
Data Marts sind eine Untergruppe von Data Warehouses. Eine Data Mart enthält ebenfalls strukturierte Daten, ist jedoch nur für eine bestimmte Abteilung relevant, wie zum Beispiel Marketing oder Finanzen. Ein Data Mart ist ein viel kleineres Datenreservoir im Vergleich zu einem Data Lake und einem Data Warehouse. Zudem kann es in einer Organisation mehrere Data Marts geben, die jeweils für eine bestimmte Abteilung innerhalb der Organisation verantwortlich sind.
Nach Angaben von Kimball gibt es drei Haupttypen der Daten-Mart-Entwicklung:
- Unabhängig. Diese Art setzt voraus, dass Data Marts als separate, kleine Datenspeicher für jeden Unternehmensbereich aufgebaut werden und nicht von den Daten im Data Warehouse abhängen.
- Abhängig. Diese Data Marts sind abhängig vom zentralen Data Warehouse. Alle strukturierten Daten des Unternehmens gelangen zunächst ins Data Warehouse, erst danach erhält jeder Data Mart seine themenspezifischen Daten.
- Hybrid. Diese Art von Daten-Mart-Architektur setzt voraus, dass eine Organisation sowohl abhängige als auch unabhängige Daten-Marten besitzt. Die hybride Bereitstellungsstrategie eignet sich am besten zur Verarbeitung sensibler Daten in unabhängigen Daten-Marten und weniger sensibler Daten in abhängigen Daten-Marten. Es muss ein wirklich guter Grund dafür geben, einen hybriden Daten-Mart zu entwickeln, da es viel einfacher ist, mehrere abhängige Daten-Marten als mehrere unabhängige zu erstellen.
Warum ein Data-Mart?
- Sicherer Datenaustausch innerhalb einer Organisation. Durch die Einrichtung von Data Marts können die einzelnen Abteilungen nur auf ihre jeweiligen Data Marts zugreifen und benötigen keinen Zugriff auf das zentrale Datenlager.
- Datenanalyse, die sich auf einzelne Abteilungen konzentriert. Durch die gut strukturierte Struktur der Daten in den Data Marts können Business Analysten schnell nur die für die Analyse notwendigen Daten abrufen, ohne dass sie diese über das gesamte Data Warehouse abfragen müssen.
Beispiel:
Das Data-Analysis-Team von McDonald’s stellte fest, dass es schwierig war, ein Data-Warehouse nur für die Analyse von Verkaufsdaten einzusetzen, um bessere Prognosen über die Ergebnisse von Treueprogrammen und Menüänderungen zu erstellen. Die Implementierung einer Data-Mart-Anwendung auf der AWS-Plattform ermöglichte es den Data-Analysten, präzisere Analysen durchzuführen, wie beispielsweise die Vergleiche von Verkäufen zu verschiedenen Zeitpunkten des Tages. Eine Data-Mart-Anwendung sammelt sowohl Daten aus Loyalty-Programmen als auch Daten aus Verkaufsautomaten (POS) und dem Betriebssystem des Geschäfts (SOS), was die Suche nach Verkaufsdaten für die Business-Analysten von McDonald’s vereinfacht.
Datenbank vs. Datenmarkt:
- Nach dem Datenarchitekturansatz von Inmon ist die primäre Datenquelle für ein Data-Mart ist ein Data Warehouse, während ein Data Warehouse Er erhält strukturierte Daten aus allen relationalen Datenbanken in der Organisation.
- Ein Data Warehouse ist ein vielseitiges Datenarchiv, da es Daten auf Unternehmensniveau speichert. Eine Data Mart ist ein themen- oder abteilungsbezogener Datenspeicher und speichert nur Daten, die sich auf ein bestimmtes Thema oder eine bestimmte Abteilung beziehen.
- Eine Data Mart ist ein deutlich kleineres Datenarchiv als ein Data Warehouse.
Jetzt kennen Sie die Hauptidee aller drei Datenspeicher sowie ihre wesentlichen Unterschiede. Dies sollte Ihnen ermöglichen, die beste Lösung für Ihr Unternehmen zu definieren. Lassen Sie uns über die möglichen Möglichkeiten sprechen, wie Sie ein Datenspeicher in Ihrer Organisation implementieren können.
Lesen Sie auch: Unsere Expertise in Big Data und Analytics
On-Premise- oder Cloud-basierter Datenspeicher?
In diesem Abschnitt werden wir uns zwei mögliche Möglichkeiten ansehen, wie man ein Datenrepository bereitstellt – lokal oder in der Cloud. Jedes Implementationsszenario hat seine Vor- und Nachteile sowie bevorzugte Einsatzfälle.
On-Premises-Implementierung
Angesichts der wachsenden Nachfrage nach Cloud-Computing-Services mag es so erscheinen, als hätte die On-Premise-Infrastruktur ihre Bedeutung verloren. Das stimmt jedoch nicht. On-Premise-Implementierungen sind weiterhin relevant, da sie die höchstmögliche Sicherheit bieten und manchmal zur Einhaltung von Gesetzen, Normen und Branchenvorschriften erforderlich sind. Lassen Sie uns kurz die Besonderheiten dieses Ansatzes erläutern:
- Individuelle Hardware- und Software-Konfiguration. Bei der Einrichtung der On-Premises-Infrastruktur muss eine Organisation sowohl in Rechenzentren und Server investieren als auch ein IT-Team einstellen, um die On-Premises-Infrastruktur zu verwalten. Je nach Speicherkapazität Ihres Datenbanks benötigen Sie eine andere Speicherplatzmenge. Beachten Sie, dass ein Data Lake viel mehr Speicherplatz benötigt als ein Data Mart, da Data Lakes große Mengen an Rohdaten in allen Formaten speichern.
- Hohe Datensicherheit und Datenmanagement. Die Implementierung eines lokalen Datenspeichers kann gewährleisten, dass Ihre Daten hochsicher sind, da nur Ihre Organisation die Server besitzt und verwaltet, auf denen Ihre Daten gespeichert werden. Diese Methode eignet sich besonders für die Speicherung sensibler Daten wie z. B. persönliche Gesundheitsinformationen (PHI) oder Kreditkartendaten.
Wenn eine On-Premise-Implementierung nicht vollständig Ihren Anforderungen gerecht werden kann, müssen Sie leider nicht nur eine On-Premise- oder eine Cloud-Implementierung wählen. Einige Datenspeicher funktionieren einfach besser in Cloud-Services – wie zum Beispiel ein Data Lake –, andere, wie ein Data Mart, lassen sich hingegen perfekt vor Ort implementieren. Lassen Sie uns genauer auf Cloud Computing eingehen. Wahrscheinlich können Sie erwägen, einige Ihrer Datenspeicher (oder alle) in der Cloud zu implementieren.
Cloud-Implementierung
Cloud Computing ist vor allem aufgrund seiner Kosteneffizienz im Vergleich zu On-Premises-Infrastrukturen beliebt. Allerdings, Dave Raffo, leitender Analyst bei Evaluator Group, sagt, dass die Cloud nicht immer günstiger ist, insbesondere wenn man mit großen Datenmengen zu tun hat. Ihr Hauptvorteil ist ein viel einfacherer Kaufprozess und eine einfachere Wartung sowie die Möglichkeit, die Skalierung auf Abruf zu nutzen.
Es gibt drei Arten von Cloud-Services, und jeder hat seine eigenen Besonderheiten.
- Ein privater Cloud-Anbieter Sie bieten Cloud-Services nur für eine Organisation an. Private Clouds werden oft mit On-Premises-Implementierungen verwechselt, da sie hinsichtlich ihrer hohen Sicherheits- und Datenverwaltungsfunktionen ähnlich sind (Modelle für die Datenverwaltung). Allerdings ist eine private Cloud im Vergleich zu einer öffentlichen Cloud teurer und weniger skalierbar.
- Eine öffentliche Cloud Ist eine Lösung, die vollständig von Drittanbietern wie Data-Lake-Anbietern (AWS, Microsoft Azure usw.) gesteuert wird und keine Investitionen in IT-Teams erfordert, um sie zu betreiben. Es ist die einfachste Lösung zur Skalierung im Vergleich zu On-Premises-Servern und privaten Clouds und kann hohe Software-Aufgaben bewältigen.
- Eine Hybridwolke Es handelt sich um eine Lösung, die sowohl private als auch öffentliche Cloud-Optionen kombiniert. In einer solchen Umgebung können Daten zwischen mehreren Clouds übertragen werden. Mit einer Hybridcloud kann eine Organisation sensiblere Daten in einer privaten Cloud speichern, während große Datensätze mit geringeren Sicherheitsanforderungen in der öffentlichen Cloud gespeichert werden können.
Wie Sie sehen können, ist es durchaus möglich, seinen eigenen Cocktail an Datenspeicheroptionen zu erstellen, da man nicht nur auf eine einzige Infrastruktur beschränkt werden muss. Schauen Sie sich das an Checkliste für die Cloudmigration auf unserem Blog Um selbstbewusst in die Cloudmigration einzusteigen. Weitere Informationen zu den Möglichkeiten der Hybriddatenverarbeitung für die Gesundheitsbranche finden Sie in unserem Blogbeitrag. Cloud-basierter Medizintechniksystem für ein US-Krankenhausnetzwerk.
Wenn Ihr Unternehmen wächst, empfiehlt die Mehrheit der Cloud-Dienstleister, auf mehrere Cloud-Umgebungen umzusteigen, in denen Sie verschiedene Cloud-Typen nutzen können. Um nicht mit all den verfügbaren Cloud-Optionen verwirrt zu werden, lassen Sie uns Unser Cloud- und DevOps-Center of Excellence Hilft Ihnen dabei, die am besten geeigneten Cloud-Technologien für Ihr aktuelles Geschäftsmodell auszuwählen.
Anwendungsfälle für die Implementierung eines Datenlagers in verschiedenen Branchen
Die Essenz der oben genannten Datenspeicher ist praktisch für alle Branchen gleich. In der Tat profitieren alle Branchen von verbesserten Datenanalysediensten durch die Speicherung von Daten in Datenspeichern. Abhängig von den gespeicherten Daten und den Datenschutzanforderungen sind jedoch bestimmte Besonderheiten zu beachten. Deshalb kann es sinnvoll sein, einen Spezialisten einzustellen. Domänsorientiertes IT-Team Um ein Datenarchiv für Ihre Organisation zu entwickeln und einzusetzen.
In diesem Abschnitt besprechen wir drei Branchen: die Lieferkette, FinTech und die Gesundheitsbranche. Unser Unternehmen hat eng mit Kunden in allen drei Branchen zusammengearbeitet.

Anwendungsfälle für die Supply Chain-Branche
Eine ordnungsgemäße Verwaltung der Daten in der Lieferkette ist unerlässlich, um den volatilen Kundenanforderungen gerecht zu werden und einen ununterbrochenen Arbeitsablauf in vielen Organisationen zu gewährleisten, die von der rechtzeitigen Lieferung von Materialien abhängig sind. Hier sind einige Anwendungsfälle, die bei der Implementierung eines Datenspeichers für ein Unternehmen der Lieferkette in Erwägung gezogen werden sollten:
- Voraussagen der Nachfrage und der Angebotssituation. Die Kenntnis von Schwankungen in Angebot und Nachfrage kann es Ihnen ermöglichen, die Supply Chain-Aktivitäten deutlich zu optimieren. Die Implementierung eines Data Lakes kann Ihre Eintrittsbereitschaft zu fortgeschrittenen Analysen sein, die eine genaue Prognose von Angebot und Nachfrage ermöglichen. Dies werden wir in einem detaillierteren Beitrag näher erläutern. Unser Blogbeitrag zu fortgeschrittenen Supply-Chain-Analysen. Die erweiterte Analyse ermöglicht die Analyse jeglicher Art von Daten wie PDF-Dokumenten, E-Mails, Videos und Bildern mithilfe von KI-/ML-Algorithmen und anderen fortschrittlichen Technologien.
- Verbesserte Berichterstattung über alle Abteilungen hinweg. Die Lieferkette umfasst oft viele Beteiligte wie Lieferanten, Hersteller und Transportunternehmen. Dank einer Data-Mart-Implementierung haben alle Beteiligten einfachen Zugriff auf Daten, die für ihre jeweilige Abteilung relevant sind und können somit ihre Gesamtleistung durch Reporting besser erfassen.
Anwendungsfälle für die Fintech-Branche
Wie alle anderen Branchen auch, basiert die Finanzdienstleistungsbranche auf Datenanalyse. Die Implementierung einer einzigen Quelle der Wahrheit in Finanzorganisationen kann dabei helfen, Erkenntnisse aus Kundendaten zu gewinnen und die Qualität der bereitgestellten Dienstleistungen zu verbessern.
Bei der Implementierung eines Datenspeichers sollte jedoch auch die sensible Art der finanziellen Daten berücksichtigt werden. Solche Daten sollten sicher gespeichert werden; gleichzeitig muss jedoch auch sichergestellt werden, dass nur autorisierte Benutzer auf sie zugreifen, sie abrufen und analysieren können.
Anwendungsfälle für die Implementierung eines Datenlagers im Bereich FinTech könnten wie folgt sein:
- Nahtlose Berichterstellung für regulatorische Bewertungen. Da Finanzunternehmen in der Regel einer Compliance-Prüfung unterliegen, ist es von Vorteil, dass sie kontinuierlich auf Unternehmensdaten zugreifen können. In diesem Fall kann ein All-in-One-Datenspeicher Datenanalysten die Möglichkeit bieten, notwendige Finanzberichte schnell zu erstellen.
- Automatisierte und KI-gestützte Entscheidungsfindung. Die Speicherung von Kundendaten in zentralen Datenspeichern ermöglicht Finanzdatenanalysten die Nutzung von ML- und KI-Technologien. Diese Technologien können die Entscheidungsfindung in Finanzinstituten automatisieren und somit vereinfachen. So kann eine Bank beispielsweise den Kreditantragsverfahren automatisieren, indem sie alle strukturierten und unstrukturierten Kundendaten, die in Data Warehouses und Data Lakes gesammelt werden, schnell analysiert.
Lesen Sie auch: Sichere Anwendungsentwicklung von der Planung bis zur Produktion
Anwendungsfälle für die Gesundheitsbranche
Gesundheitsorganisationen müssen außerdem vielen Datenschutzanforderungen wie HIPAA in den USA, dem GDPR in Europa und vielen anderen entsprechen. Gesundheitsrecht und -vorschriften in anderen Ländern. Das liegt daran, dass Gesundheitsdaten oft vertraulich sind und zusätzliche Sicherheitsmaßnahmen erfordern. Leider sind Datenverstöße in der Gesundheitsbranche am häufigsten – und gleichzeitig auch am schwerwiegendsten. Daher sollten Datenspeicher so aufgebaut werden, dass alle notwendigen Sicherheitsmaßnahmen berücksichtigt werden.
Wenn eine Organisation erwägt, ihre Dienste und Dokumentation in die Cloud zu migrieren, muss ein Cloud-Provider die Einhaltung der erforderlichen Anforderungen gewährleisten. So ermöglicht AWS beispielsweise die Einhaltung der am weitesten verbreiteten Gesundheitsrechtsvorschriften wie HIPAA sowie der Finanzstandards wie PCI DSS.
Gängige Anwendungsfälle für die Implementierung eines Datenlagers in der Gesundheitsbranche umfassen Folgendes:
- Telemedizin. Datenspeicher sind ein Muss für digitale Gesundheitsdienstleistungen. Die Gesundheit und das Leben eines Patienten hängen von der Genauigkeit der Diagnose eines Arztes ab. Die Möglichkeit, Daten von Wearables und IoT-Geräten wie Bluetooth-EKG-Monitoren zu sammeln und zu analysieren, kann Ärzten dabei helfen, genauere Diagnosen zu stellen. Sie können mehr zu diesem Thema in unserem detaillierten Artikel lesen. Fallstudie Über ein Projekt zur Telemedizin und der Fernüberwachung von Patienten.
- Klinische Forschung. Datenintensive klinische Forschung treibt die gesamte Gesundheitsbranche voran. Analysen großer Datenmengen ermöglichen Wissenschaftlern, die Tiefe der klinischen Studien zu erkunden und so Durchbrüche zu erzielen und Menschenleben zu retten. So konnten die Wissenschaftler von Moderna dank Cloud Computing und einer beeindruckenden Speicherinfrastruktur bereits 42 Tage nach Beginn der Pandemie die erste Dosis der COVID-19-Impfstoffe liefern. Das Unternehmen hat kürzlich auch klinische Studien an Menschen mit einem HIV-Impfstoff begonnen.
Die Branchen Supply Chain, FinTech und Healthcare können auf unterschiedliche Weise von der Implementierung von Datenrepositories profitieren. Aber eines haben sie alle gemeinsam: Mit dem Zugang zu großen Datensätzen können sie ihre Dienstleistungen schneller bereitstellen und so mehr Umsatz und zufriedeneren Kunden generieren. Zudem kann das richtige Datenrepository eine hervorragende Grundlage für die Entwicklung eines Nahtlose digitale End-to-End-Lösung In Ihrer Organisation. Lassen Sie uns in der nächsten Sektion herausfinden, wie Sie ein Datenrepository implementieren können, ohne dabei so viele Probleme wie möglich zu haben.
Was zu berücksichtigen ist, um eine reibungslose Implementierung des Datenlagers zu gewährleisten
Um ein Datenarchiv zu erstellen, benötigen Sie eine Team aus IT-Experten Vorzugsweise mit Erfahrung in Ihrem Fachgebiet und mit praktischen Kenntnissen. Sie können sich für die interne Einstellung oder die Outsourcing-Option entscheiden. Ihre Wahl hängt von Ihren Bedürfnissen und Erwartungen ab. Nehmen Sie sich Zeit, sich zu informieren. Unser Artikel, in dem wir gemeinsame Mythen über Outsourcing aufklären Damit Sie sicher sein können, dass Sie die richtige (und unvoreingenommene) Entscheidung treffen.
In diesem Artikel möchten wir Ihnen einige Tipps zum nahtlosen Übergang zu einem Datenrepository vorstellen.
- Beginnen Sie mit einem Proof-of-Concept (PoC). Viele Anbieter von Datenspeichern wie AWS bieten die Möglichkeit, diese zu implementieren. ein Datenrepository als PoC Zunächst einmal: Sie können diese Option in Betracht ziehen, um sicherzustellen, dass die Investition in ein Datenspeicher-System für Ihre Organisation von Vorteil ist.
- Sichern Sie die Zustimmung und die Unterstützung der Stakeholder. Sobald Sie eine PoC bereitgestellt und die ersten Ergebnisse generiert haben, können Sie diese neue Lösung problemlos Ihren Stakeholdern und Sponsoren Ihres Unternehmens vorstellen. Selbst wenn Ihre Organisation geneigt ist, auf traditionelle Entscheidungen zu setzen, die auf der Erfahrung der Manager basieren, können datenbasierte Berichte so überzeugend sein, dass sie die Rentabilität einer vollständigen Implementierung eines Datenlagers beweisen können.
- Beginnen Sie mit einem Data Warehouse oder einem Data Lake und überlegen Sie anschließend Data Marts. Datenlager und Datenseen sind viel größere Datenspeicher als Data Marts. Daher ist es sinnvoll, einen davon zuerst zu implementieren, bevor man eine Data Marts in Betracht zieht. Mit einem Data Warehouse oder einem Data Lake kann man schnell die Ergebnisse sehen und die Bedeutung einer Datenarchitektur für die eigene Organisation einschätzen.
- Denken Sie daran, dass die Möglichkeiten zur Datenskalierung unerlässlich sind. Akzeptieren Sie einfach, dass die Datenmengen mit der Zeit nur noch zunehmen werden. Stellen Sie daher sicher, dass Ihr Datenspeicher einfach skalierbar ist. Skalieren ist ein überzeugender Vorteil von Cloud-Services.
Diese vier einfachen Tipps können Ihnen helfen, sicher den Übergang zu einer einzigen Quelle der Wahrheit zu vollziehen. Wenn Sie sich für die Dienste eines professionellen IT-Teams entscheiden, um Ihr Datenarchiv einzurichten, können Sie sich auf eine umfassende Unterstützung zählen. Beratungssitzung vor Beginn der eigentlichen Arbeit. Bei diesem Beratungsgespräch können Sie mit unserem Team alle verbliebenen Zweifel und Ängste klären lassen, die Sie daran hindern, Ihre üblichen Datenmanagement-Praktiken zu verbessern. Kontaktieren Sie unsere Experten zur Beratung verfügbar.
Wollen Sie die Datenanalyse in Ihrem Unternehmen verbessern?
Wir können Ihnen ein passendes Datenrepository implementieren.
FAQ
Was sind die gängigen Arten von Datenrepositories?
Es gibt solche gängigen Datenspeicherarten wie Data Warehouse, Data Lake, Data Mart, Metadaten-Repository und Data Cube.
Was ist ein Datenmanagement-System?
Ein Datenmanagement-System wird dafür entwickelt, große Datenmengen zu sammeln und zu analysieren, die eine Organisation erfasst. Solche Systeme enthalten in der Regel Datenmanagement-Tools, die von der Datenbank oder von Drittanbietern entwickelt werden. Diese Systeme ermöglichen es IT-Spezialisten und Datenbankadministratoren, Probleme im Datenbanksystem oder in der Infrastruktur zu lösen, das Datenbankdesign zu ändern und vieles mehr.
Warum sollte Ihre Organisation Datenrepository-Plattformen nutzen?
Datenrepository-Plattformen bieten Ihrer Organisation eine einzige Quelle der Wahrheit und gewährleisten, dass wertvolle Daten nicht in gespaltenen Legacy-Systemen hängen bleiben.
Über den Autor