Die Art und Weise, wie Ihre App die Datenverwaltung angeht, kann das Nutzererlebnis entscheidend beeinflussen. Stellen Sie sich eine App mit einer großartigen Benutzeroberfläche und sauberem Code vor, die jedoch lange dauern kann, um Daten abzurufen, oder, was noch schlimmer ist, die Daten nicht sicher speichern kann. Deshalb ist die Wahl des richtigen Datenbankmanagementsystems (DBMS) wichtig.
Ihre Datenbank ist für die Performance Ihrer App verantwortlich und sorgt dafür, dass alles reibungslos und sicher funktioniert. Und während Sie die Auswahl treffen, über 300 Datenbanken Auf dem Markt kann es schwierig sein, wir helfen Ihnen gerne dabei.
Unser Team hat bereits die Recherchearbeit durchgeführt, um die optimalen Optionen für Ihr Projekt zu finden. In diesem Leitfaden werden die Auswahl eines Datenbanken für Ihr Projekt und die Verwendung der richtigen Datenbank für beste Ergebnisse vorgestellt. Dabei werden die einzelnen Schritte und die Vorteile der beliebtesten Datenbanklösungen erläutert.
Kurze Anweisungen zum Navigieren in diesem Artikel:
- Wenn Sie neu mit der Datenbankauswahl vertraut sind, Wir empfehlen Ihnen, den gesamten Artikel in der Reihenfolge zu lesen. Jede Abschnitte baut auf dem vorhergehenden ab und hilft Ihnen, letztendlich die endgültige Entscheidung zu treffen oder zumindest zu erkennen, dass Sie weitere Fragen haben, die unser Team gerne beantworten wird.
- Wenn Sie überlegen, welche Datenbank Sie wählen sollen, Sie können direkt zur detaillierten Übersicht springen und neun beliebte Datenbankoptionen beschreiben. Verpassen Sie nicht den Vergleichstabelle am Ende, die alle wichtigen Informationen zusammenfasst.
6 Schritte und Fragen, um eine Datenbank für Ihr Projekt auszuwählen
Bevor wir uns der detaillierten Datenbankvergleichsarbeit widmen, stellen wir Ihnen die Kriterien vor, die die Auswahl der Datenbank beeinflussen. Diese Kriterien werden in Form von Schritten dargestellt, da jedes Kriterium auch eine bestimmte Aktion seitens Ihres Unternehmens erfordert. Zusammen mit einer relevanten Frage:, Jeder Schritt zur Auswahl einer Datenbank hilft dabei, die richtige Denkweise zu entwickeln, mit der Sie diesen Artikel lesen sollten – dabei ist es wichtig, Ihre individuellen Geschäftsanforderungen zu berücksichtigen.
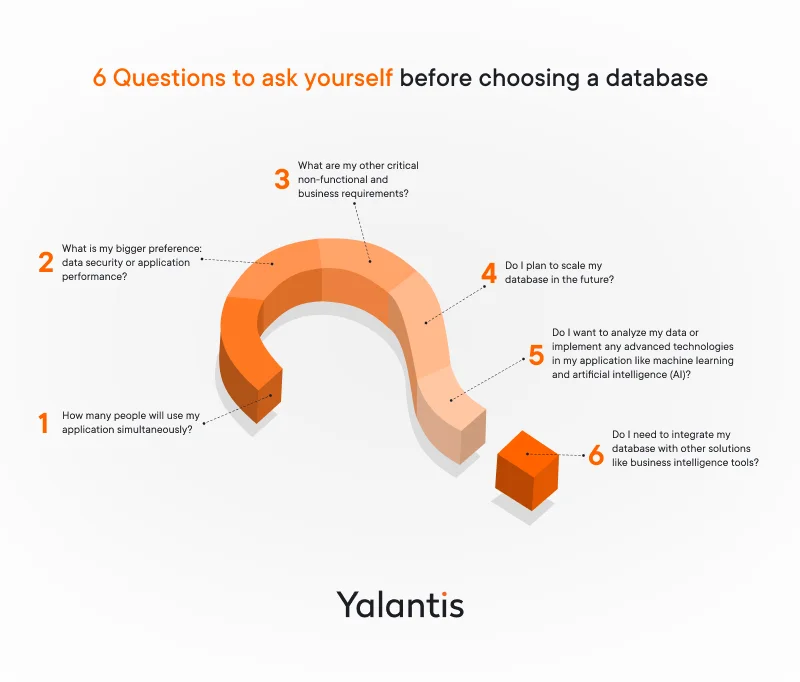
Schritt 1. Benutzerlast
Frage: Wie viele Personen werden unsere Anwendung gleichzeitig nutzen?
Bei der Auswahl einer Datenbank ist die erwartete Anzahl der Personen, die Ihre Anwendung nutzen werden, unerlässlich. So könnten Datenbanken wie SQLite hervorragend für Prototyping geeignet sein, fehlen ihnen jedoch die Leistungsfähigkeit, um viele Benutzer in Produktionsready-Lösungen zu verwalten.
Schritt 2. Sicherheit gegen Leistungsfähigkeit
Frage: Priorisieren wir die Datensicherheit oder die Anwendungsperformance?
Da eine Datenbank alle Benutzerdaten speichert, sollte sie gut geschützt sein. Relational Database-Systeme, die den ACID-Prinzipen (Atomzahl, Konsistenz, Isolation und Haltbarkeit) entsprechen, sind sicherer als nicht-relationalen Datenbanken, die den Grundprinzipien des BASE-Ansatzes (Basically Available, Soft State und eventually consistent) folgen und Kompromisse zwischen Performance und Skalierbarkeit und Konsistenz eingehen.
Schritt 3. Einheitliche Geschäftsbedürfnisse, abgestimmt auf die Datenarten
Frage: Welche anderen kritischen nicht-funktionalen und geschäftlichen Anforderungen haben wir?
Neben Leistung und Skalierbarkeit sollten Sie außerdem prüfen, was Sie von Ihrer Softwarelösung erwarten und bei der Entscheidung, welche Datenbank Sie verwenden sollten, alle nicht-funktionalen und geschäftlichen Anforderungen berücksichtigen. Wenn Sie beispielsweise erwarten, dass Ihre Software Daten aus anderen Systemen, wie etwa medizinischen Bildverarbeitungssoftware, abruft und anzeigt, sollte Ihr Datenbanksystem außerdem unstrukturierte Daten unterstützen, um medizinische Bilder in einem konsistenten Format für alle Softwarebenutzer anzuzeigen.
SQL-Datenbanken eignen sich hervorragend zur Speicherung und Verarbeitung strukturierter Daten, während NoSQL-Datenbanken die beste Lösung für die Arbeit mit unstrukturierten oder semi-strukturierten Daten darstellen. Wenn Sie sowohl strukturierte als auch unstrukturierte Daten verwalten möchten, können Sie sich für eine Mischung aus SQL- und NoSQL-Datenbanken entscheiden.
Schritt 4. Skalierbarkeit
Frage: Planen wir, unsere Datenbank in Zukunft zu skalieren?
Wenn Ihr Webprodukt wächst, sollte auch seine Datenbank wachsen. Ihre Auswahl an Datenbanken hängt von der Art der Skalierung ab, die Sie bevorzugen – ob horizontal oder vertikal. Nichtrelationale Datenbanken mit ihren Key-Value-Speichern sind für die horizontale Skalierung optimiert, während ein relationales Datenmodell für die vertikale Skalierung optimiert ist.
Schritt 5. Analytik- und KI-Bereitschaft
Frage: Wollen wir unsere Daten analysieren oder in unsere Anwendung fortschrittliche Technologien implementieren, wie zum Beispiel maschinelles Lernen und künstliche Intelligenz (KI)?
Die Wahl der Datenbank für eine moderne Anwendung hängt auch von der Art der Analysen ab, die Sie durchführen möchten. Wenn Sie beispielsweise eine Datenbank benötigen, die für die weitere Analyse große Mengen strukturierter Daten speichern kann, sollten Sie ebenfalls ein Data Warehouse einrichten. Wenn Sie hingegen große Datenmengen oder große Mengen unstrukturiertem Daten speichern und analysieren müssen, sollten Sie ein Data Lake wählen. Erfahren Sie, wie wir einem 3PL-Unternehmen dabei geholfen haben, große Daten aus mehreren Quellen zu aggregieren und zu analysieren, mithilfe eines Data Lakes.
Erfahren Sie, wie wir einem 3PL-Unternehmen dabei geholfen haben, Big Data aus mehreren Quellen zu aggregieren und zu analysieren, mithilfe eines Data Lakes.
Erfahren Sie mehr über die FallstudieSchritt 6. Integration
Frage: Müssen Daten und unsere Datenbank mit anderen Lösungen wie Business Intelligence-Tools integriert werden?
Wichtiger Hinweis bei der Auswahl eines DBMS: Stellen Sie sicher, dass Ihr Datenbankmanagement-System mit anderen Tools und Diensten Ihres Projekts integrierbar ist. In den meisten Fällen kann eine schlechte Integration mit anderen Lösungen die Entwicklung behindern.
Beispielsweise:, ArangoDB ArangoDB bietet hervorragende Leistung, aber die Bibliotheken für diese DBMS sind noch nicht vollständig entwickelt und bieten keinen ausreichenden Support. Die Verwendung von ArangoDB in Kombination mit anderen Tools kann riskant sein, weshalb die Entwicklergemeinschaft empfiehlt, bei komplexen Projekten ArangoDB zu vermeiden.
In den folgenden Abschnitten vergleichen wir allgemeine Datenbanktypen und gehen dann auf spezifische Beispiele ein, die in verschiedenen Branchen mögliche Einsatzmöglichkeiten bieten.
Haben Sie Schwierigkeiten, das volle Potenzial Ihrer Daten auszuschöpfen?
Die Datenanalysekompetenz von Yalantis kann Ihnen helfen, Ihre Rohdaten in wertvolle Erkenntnisse zu verwandeln, die Sie für eine fundierte Entscheidungsfindung nutzen können.
Typen von Datenbanken: SQL vs. NoSQL
Bei der Auswahl der besten Datenbanklösung stellt eine der größten Herausforderungen die Wahl zwischen komplexen Datenstrukturen in SQL- (relationalen) und NoSQL- (nicht-relationalen) Formaten dar. Obwohl beide eine gute Performance aufweisen, gibt es einige wichtige Unterschiede, die Sie beachten sollten.
| Name |
SQL-Datenbanken |
NoSQL-Datenbanken |
|
Art |
relationale (tabellebasierte) |
Nicht-relational (Key-Value, Dokument, Spalte, Diagramm) |
|
Struktur |
Vorgeschriebenes Schema mit Zeilen (Tuple) und Spalten (Attribute) |
Schema-lose oder dynamische Schemata, je nach Untertyp |
|
Abfragelanguage |
SQL (standardisiert, weit verbreitet unterstützt) |
Variiert je nach DB-Typ (eigene APIs oder Abfrage-Sprachen wie MongoDB Query Language) |
|
Skalierbarkeit |
Vertikal (Eine Skalierung nach oben erfordert leistungsfähigere Server) |
Horizontal (Skalierung durch Hinzunahme mehrerer Server) |
|
Datenintegrität (ACID, BASE) |
Voller ACID-Compliance: Atomisierung, Konsistenz, Isolation, Stabilität |
Begrenzte ACID-Eigenschaften; BASE-Compliance (im Grunde verfügbar, weiches Zustand, eventuell konsistent) |
|
Leistung |
Hochwertig für strukturierte Daten und Transaktionsoperationen |
Hochwertig für große Datenmengen mit semi-strukturierten oder unstrukturierten Daten |
|
Sicherheit |
Reife Zugangskontrollmechanismen und robuste Benutzerberechtigungsmodelle |
Variiert; ist oft weniger reif als SQL, aber entwickelt sich stetig |
|
Beste Anwendungsfälle |
Finanzsysteme, Gesundheitsapplikationen, ERP-Systeme, CRM-Plattformen |
Inhaltmanagement, Echtzeit-Analytik, IoT, Social Media, Caching und großflächige Web-Apps |
|
Nachteile |
– Schlechte Performance bei unstrukturierten Daten – Nicht für verteilte Systeme optimiert – Hohe Hardwarekosten bei der Skalierung |
– Einschränkungen bei komplexen Abfragen – Lernkurve für verschiedene Abfrage-Sprachen |
SQL-Datenbanken
Eine relationale Datenbank ist eine Reihe von Tabellen, die vordefinierte Beziehungen zueinander aufweisen. Es handelt sich um die am häufigsten verwendete Art von Datenbankverwaltungssystem. Um eine relationale Datenbank zu verwalten und zu abfragen, verwendet das Datenbankverwaltungssystem den strukturierten Abfragen-Sprachcode (SQL), eine gängige Anwendungssoftware, die eine einfache Programmierschnittstelle für Datenbankinteraktionen bietet.
Relationale Datenbanken bestehen aus Zeilen (Tuple) und Spalten (Attribute). Die Attribute der Zeilen sind identisch.
Vorteile von SQL-Datenbanken
- Ideal geeignet für strukturierte Daten. Eine relationale Datenbank eignet sich ideal zum Speichern strukturierter Daten (Postleitzahlen, Kreditkartennummern, Datumsangaben, Personalausweise). Die besten SQL-Datenbanken sind PostgreSQL und MySQL.
- Sicherheit. Moderne relationale Datenbanken unterstützen Zugriffsrechte, die festlegen, wer die Daten lesen und bearbeiten darf. Ein Datenbankadministrator kann bestimmten Benutzern bestimmte Zugriffs-, Einfüge- oder Löschrechte gewähren. Dadurch besteht keine Möglichkeit für Dritte, geschäftskritische Daten zu verfälschen.
- Einhaltung der ACID-Eigenschaften (Atomität, Konsistenz, Isolation und Stabilität). Um besser zu verstehen, was das bedeutet, nehmen wir an, dass zwei Käufer gleichzeitig ein Kleidungsstück derselben Größe kaufen wollen. Die ACID-Compliance sorgt dafür, dass diese Transaktionen nicht miteinander überlappen.
- Atomität Das bedeutet, dass jede Transaktion (eine Folge von einer oder mehreren SQL-Operationen) als Einheit behandelt wird. Wenn ein Benutzer einen Artikel kauft, wird Geld von seinem Konto abgezogen und auf das Konto des Händlers überwiesen. Die Atomität gewährleistet, dass die Abhebung nicht stattfindet, falls die Einzahlungstransaktion fehlschlägt.
- Konsistenz Das bedeutet, dass nur gültige Daten, die allen Regeln entsprechen, in die Datenbank geschrieben werden können. Falls die Eingabeinformationen ungültig sind, kehrt die Datenbank in ihren vorherigen Zustand zurück, bevor die Transaktion stattfindet. Dadurch wird sichergestellt, dass illegale Transaktionen die Datenbank nicht beschädigen können.
- Isolation Das bedeutet, dass unvollständige Transaktionen isoliert bleiben. Dies gewährleistet, dass alle Transaktionen sicher und unabhängig verarbeitet werden.
- Langlebigkeit Das bedeutet, dass die Daten vom System gespeichert werden, selbst wenn die Transaktion fehlschlägt. Dank der Beständigkeit werden die Daten nicht verloren gehen, selbst wenn das System abstürzt.
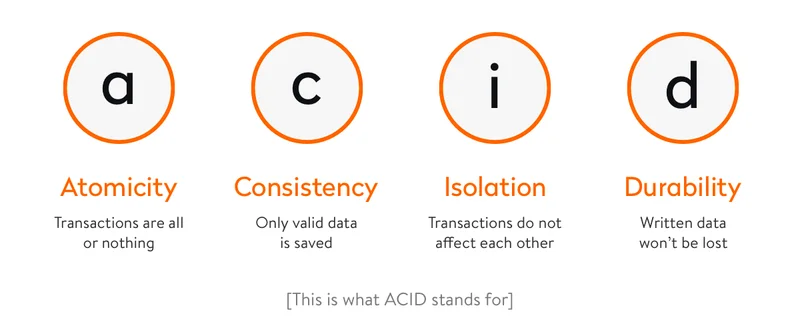
Die ACID-Compliance ist vorteilhaft für Anwendungen, die sensible Finanz-, Gesundheits- und persönliche Daten verarbeiten, da sie den Nutzern automatisch Sicherheit und Privatsphäre bietet.
Nachteile relationaler Datenbanken
- Relationale Datenbanken Arbeiten Sie nicht effizient mit semistrukturierten oder unstrukturierten Daten, Daher eignen sie sich nicht gut für große Datenmengen und IoT-Analysen.
- Wenn die Datenstruktur komplex wird, wird sie Es ist schwieriger, Informationen von einer großen, datenbasierten Softwarelösung in eine andere zu übertragen. In großen Institutionen wachsen relationalen Datenbanken oft unabhängig in separaten Abteilungen.
- Relationale Datenbanken Sie werden nur auf einem Server ausgeführt, Das bedeutet, dass Sie, wenn Sie Ihre DBMS dazu bringen wollen, mit einer größeren Datenmenge zurechtzukommen, in kostspielige physische Geräte investieren müssen.
Diese Nachteile haben Entwickler gezwungen, nach Alternativen zu relationalen Datenbanken zu suchen. Infolgedessen sind NoSQL- und NewSQL-Datenbanken entstanden.
Erfahren Sie, wie Yalantis eine Echtzeit-Web-basierte Plattform für die Analyse von Wahldatenbanken mithilfe der Aurora MySQL-Datenbank aufgebaut hat
Erfahren Sie mehr über die FallstudieNoSQL-Datenbanken
NoSQL-Datenbanken (“nicht nur SQL”) stellen eine breite Gruppe von Datenbankverwaltungssoftware dar, die für ihre nicht-relationalen Eigenschaften bekannt ist. Diese Datenbanken dienen als Alternative zu relationalen Datenbanken. Sie können unstrukturierte Daten (Fotos oder Musik aus sozialen Medien, Sensordaten aus dem Internet der Dinge usw.) speichern und verarbeiten und bieten Entwicklern somit mehr Flexibilität und Skalierbarkeit.
Vorteile von NoSQL-Datenbanken
- Skalierbarkeit. NoSQL-Datenbanken zeichnen sich durch eine horizontale Skalierbarkeit aus, was es ermöglicht, massive Datenmengen zu verwalten und wachsenden Arbeitslasten durch die Anbindung weiterer Server zu begegnen.
- Flexibilität. NoSQL-Datenbanken ermöglichen es Entwicklern, Daten mit unterschiedlichen Strukturen zu speichern und zu verwalten, ohne die Einschränkungen eines festen Schemas. Diese Flexibilität ist ideal für Projekte, bei denen die Datenstrukturen im Laufe der Zeit sich ändern, da sie eine agile Entwicklung und eine nahtlose Datenintegration ermöglichen.
- Hohe Fehlerbeständigkeit. NoSQL-Datenbanken sind für eine hohe Zuverlässigkeit ausgelegt und können auch dann weiterhin funktionieren, wenn einige Knoten oder Server ausfallen. Dies macht sie ideal für Anwendungen, die eine hohe Verfügbarkeit und Zuverlässigkeit erfordern, wie z. B. IoT-Systeme, E-Commerce-Plattformen und Content-Management-Systeme.
Nachteile von NoSQL-Datenbanken
- Begrenzte ACID-Transaktionen. NoSQL-Datenbanken legen oft die Performance und die Partitionsstabilität über die strenge Konsistenz (ACID-Eigenschaften) an den ersten Platz. Dies kann zu Situationen führen, in denen die Daten nicht sofort in allen Knoten konsistent sind, was möglicherweise nicht für Anwendungen geeignet ist, die strenge Datensicherheit erfordern.
- Mangel an einer standardisierten Abfrage-Sprache. Im Gegensatz zu relationalen Datenbanken, die SQL als gemeinsame Abfragesprache verwenden, kann jede NoSQL-Datenbank ihre eigene, eindeutige Abfragesprache oder API verwenden. Dies kann für Entwickler eine Lernkurve schaffen und die Portabilität zwischen verschiedenen NoSQL-Systemen einschränken.
- Begrenzte Unterstützung für komplexe Abfragen. NoSQL-Datenbanken haben möglicherweise Schwierigkeiten mit komplexen Abfragen, die mehrere Datenbeziehungen beinhalten, da sie in der Regel nicht über die robusten Abfragenoptimierungsmöglichkeiten von SQL-Datenbanken verfügen. Dies kann ein Nachteil für Anwendungen sein, die stark von komplexen Datenstrukturen abhängig sind. Dienstleistungen im Bereich der Datenanalyse und Berichterstattung.
Typen von NoSQL-Datenbanken
Je nachdem, wie NoSQL-Datenbanken Daten organisieren und speichern, fallen sie in vier Hauptgruppen: Schlüssel-Wert-Speicher, Dokumenten-Speicher, Spalten-Speicher und Graph-Speicher. Wir werden besprechen, wie alle diese Strukturtypen die Performance von Datenbanklösungen beeinflussen und herausfinden, wo sie eingesetzt werden können.
- Key-Value-Speicher
Dies ist die einfachste Art von NoSQL-Datenbank, die nur Schlüssel-Wert-Paare speichern kann und grundlegende Funktionen für die Abfrage des mit einem Schlüssel verbundenen Wert bietet. Ein Schlüssel-Wert-Speicher ist eine hervorragende Option, wenn Sie schnell Informationen mit einem Schlüssel finden möchten. Amazon DynamoDB und Redis Sie sind die brillantesten Beispiele für Schlüssel-Wert-Speichereinheiten.
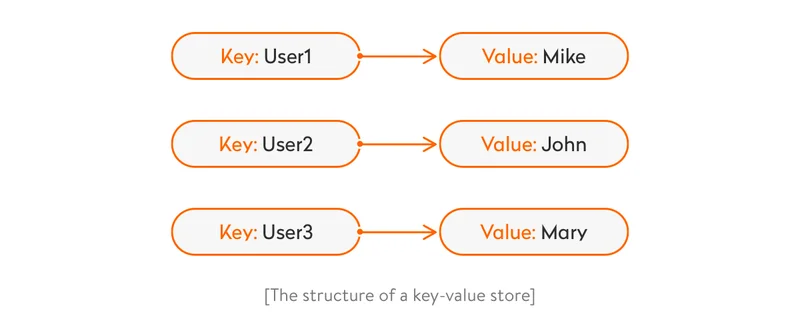
Die einfache Struktur von DynamoDB und Redis macht sie zu den bestausgereiftesten Skalierungsdatenbanken. Da zwischen den Werten keine Verbindung besteht und keine Konstruktionsschritte erforderlich sind, ist die Anzahl der Werte nur durch die Rechenleistung begrenzt.
Key-Value-Stores werden von Hosting-Anbietern wie ScaleGrid, Compose und Redis Labs eingesetzt. Entwickler verwenden diese Speicherarten oft, um Daten zu cachen. Sie eignen sich auch gut zur Speicherung von Blogkommentaren, Produktbewertungen, Nutzerprofilen und Einstellungen.
Diese Art von Datenbank ist für eine horizontale Skalierung optimiert, was bedeutet, dass Sie weitere Maschinen hinzufügen müssen, um mehr Daten zu speichern. Dies ist kostengünstiger als die Skalierung relationaler Datenbanken, kann jedoch zu hohen Betriebskosten für Kühlung und Strom führen.
Aber die Einfachheit von Schlüssel-Wert-Speichern kann auch ein Nachteil sein. Bei einem Schlüssel-Wert-Speicher ist es schwierig oder sogar unmöglich, die meisten der in anderen Datenbanken verfügbaren Operationen durchzuführen. Obwohl das Durchsuchen nach Schlüssel sehr schnell ist, kann das Durchsuchen nach Werten viel länger dauern.
In den meisten Fällen werden Schlüssel-Wert-Speichereinheiten in Kombination mit einer anderen Datenspeicherlösung verwendet. In diesem Fall wird eine Datenbank verwendet. Gesundheitsförderlich und KPMG Für die Entwicklung unserer Apps verwendeten wir den Redis-Key-Value-Store in Kombination mit dem relationalen Datenbank-Management-System PostgreSQL.
- Dokumentenlager
Dokumentorientierte Datenbanken speichern alle Informationen zu einem bestimmten Objekt in einer einzigen BSON-, JSON- oder XML-Datei. Dokumente desselben Typs können in sogenannte Sammlungen oder Listen gruppiert werden. Diese Datenbanken ermöglichen es Entwicklern, sich keine Sorgen um mehrere Datentypen und starke Beziehungen zu machen.
Eine dokumentorientierte Datenbank hat normalerweise einen Baum oder eine Waldstruktur. Datenbankmodell. Eine Baumstruktur bedeutet, dass ein Stammknoten eine oder mehrere Seitentypen aufweist. Eine Waldstruktur besteht aus mehreren Bäumen. Diese Datenstrukturen helfen Dokumentenbeständen dabei, schnelle Suchvorgänge durchzuführen. Dies erschwert zwar die Verwaltung komplexer Systeme mit zahlreichen Verbindungen zwischen Elementen, ermöglicht es Entwicklern jedoch, Dokumentenbestände nach Thema oder Typ zu erstellen.
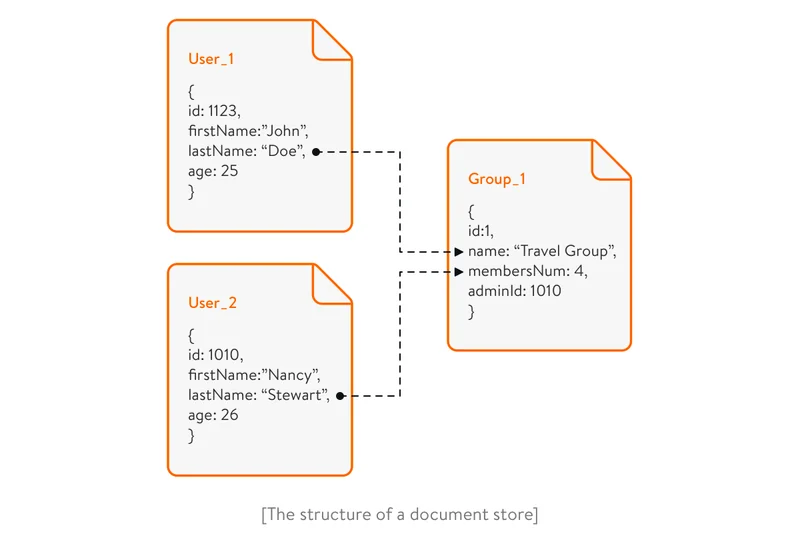
Wenn Sie beispielsweise eine Musik-Streaming-App erstellen, können Sie eine dokumentorientierte Datenbank verwenden, um eine Sammlung von Songs in einem bestimmten Genre zu erstellen, damit die Nutzer schnell bestimmte Titel finden können.
Um flexibel zu sein, vernachlässigen dokumentorientierte Datenbanken die ACID-Sicherheitsgarantien. MongoDB und Couchbase sind großartige Beispiele für dokumentorientierte Datenbanken.
Dank ihrer Struktur und Flexibilität werden dokumentorientierte Datenbanken häufig für die Inhaltsverwaltung, das Rapid Prototyping und die Datenanalyse eingesetzt.
- Spaltenspeicher
Eine Säulendatenspeicherung ist optimiert für die schnelle Abfrage von Datensäulen. Säulendatenspeicher speichern jede Spalte als logischen Wertspeicher. Diese Datenspeicher bieten eine hohe Skalierbarkeit und lassen sich leicht replizieren.
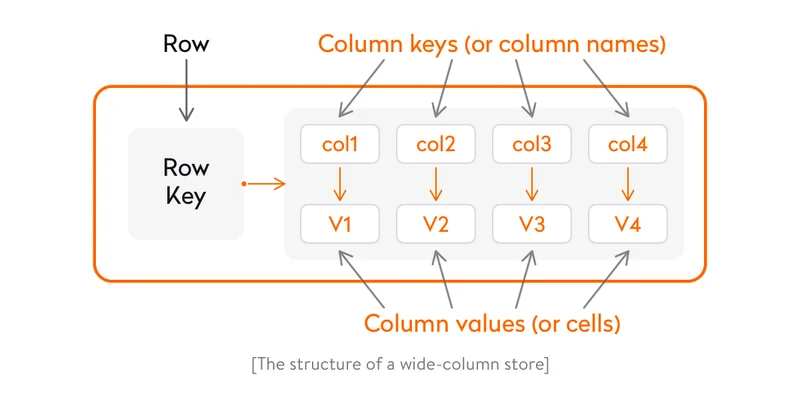
Eine Spaltendatenbank ist bestens für strukturierte und unstrukturierte Daten geeignet und vereinfacht die Datenbankexploration so weit wie möglich. Spaltenbasierte Datenbanken verarbeiten analytische Operationen schnell, zeigen jedoch bei der Verarbeitung von Transaktionen schlechte Ergebnisse. Apache Cassandra und Scylla Sowohl die Modelle als auch die Kollektionen von Are gehören zu den beliebtesten Säulenshops.
- Grafikspeicher
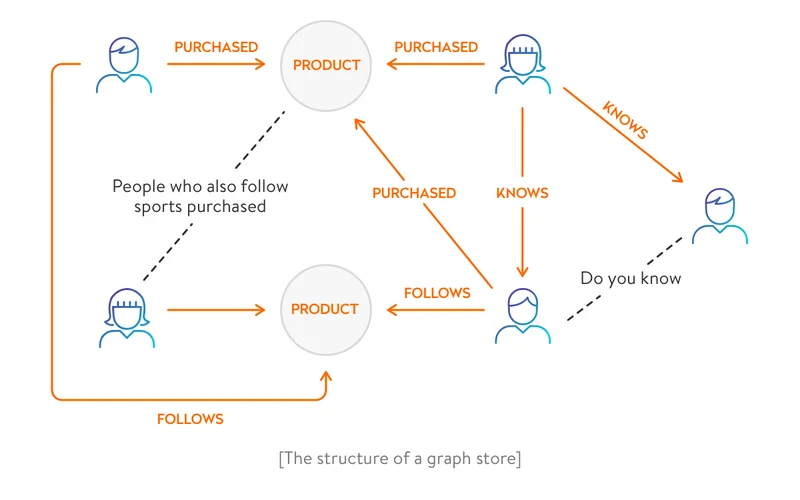
In einem Graph-Store ist jede Entität, die als Knoten bezeichnet wird, ein isoliertes Dokument mit freiformigen Daten. Knoten werden durch Kanten miteinander verbunden, die ihre Beziehungen beschreiben.
Dieser Ansatz erleichtert die Datenvisualisierung und die Analyse von Diagrammen. In der Regel werden Graphdatenbanken verwendet, um die Beziehungen zwischen verschiedenen Datensätzen zu ermitteln. Die meisten Graphdatenbanken bieten Funktionen wie die Suche nach Knoten mit den meisten Verbindungen und die Suche nach allen verbundenen Knoten.
Graphdatenbanken sind für Projekte mit graphischen Datentypen optimiert, wie z. B. soziale Netzwerke und das semantische Web. Neo4J und Datastax Enterprise Sowohl Graph-Datenbanken als auch Relational-Datenbanken sind die besten Beispiele für Graphdatenbanken.
NewSQL – die Kombination der besten SQL- und NoSQL-Datenbanklösungen
Besonderer Aufmerksamkeit sollte der NewSQL gewidmet werden, eine Klasse relationaler Datenbanken, die die Merkmale sowohl von SQL- als auch von NoSQL-Datenbanken vereint.
- NewSQL-Datenbanken sind darauf ausgelegt, häufig auftretende Probleme von SQL-Datenbanken im Zusammenhang mit der traditionellen Online-Transaktionsverarbeitung zu lösen.
- Aus dem Bereich NoSQL hat NewSQL die Optimierung für die Verarbeitung von Online-Transaktionen, Skalierbarkeit, Flexibilität und eine serverlosen Architektur übernommen.
- Wie relationale Datenbanken sind auch NewSQL-Datenbankstrukturen ACID-konform und konsistent. Sie sind skalierbar und können oft auf Anfrage ohne Beeinträchtigung der Anwendungslogik oder Verletzung des Transaktionsmodells erweitert werden.
NewSQL wurde erst 2011 eingeführt und ist immer noch nicht sehr beliebt. Es bietet nur teilweisen Zugriff auf die umfangreichen SQL-Tools. Flexibilität und eine serverlosen Architektur in Kombination mit hoher Sicherheit und Verfügbarkeit ohne die Notwendigkeit eines redundanten Systems erhöhen die Chancen, dass NewSQL-Datenbanken eine Next-Gen-Lösung für Cloud-Technologien werden.
ClustrixDB, CockroachDB, NuoDB, MemSQL und VoltDB Sie sind die beliebtesten NewSQL-Datenbanken.
Im nächsten Abschnitt besprechen wir die Unterscheidung zwischen Online-Analytischen Verarbeitungsmodellen (OLAP) und Online-Transaktionsverarbeitungsmodellen (OLTP), da Ihre Wahl der Datenbank davon abhängt, ob Sie Ihre Daten analysieren möchten.
Datenverarbeitungsmethoden: OLAP-Systeme vs. OLTP-Systeme
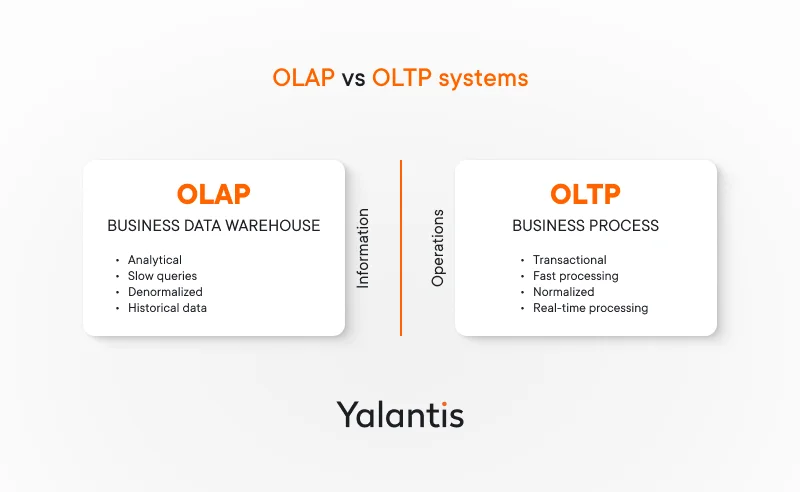
Die Wahl der Datenspeicherlösung kann auch vom Zweck der Datenverarbeitung abhängen. Es gibt zwei gängige Ansätze zur Datenverarbeitung: Online-Analytik und Online-Transaktionsverarbeitung.
- OLTP Erfordert Daten aus relationalen Datenbanken mit ACID-Compliance. OLTP ist dafür verantwortlich Durchführung kritischer Geschäftsaktivitäten in Echtzeit. Beispielsweise wird es in Online-Banking- und Online-Shopping-Systemen eingesetzt, die mehrere Datenbanktransaktionen von mehreren Benutzern erfassen.
- OLAP Systeme konzentrieren sich wiederum auf die Analyse historischer Daten und erfordern die beste Analyse-Datenbank sowie ein großes Datenspeicher-System: Ein Data Warehouse, ein Data Mart oder ein Data Lake, Je nach Art der verarbeiteten Daten.
Die Endnutzer von OLTP-Systemen sind Mitarbeiter, die beispielsweise sicherstellen müssen, dass mehrere Kunden die Unternehmensdienstleistungen gleichzeitig nutzen können. OLAP-Systeme sind für Data-Wissenschaftler und Datenanalysten, um Daten zu analysieren und Erkenntnisse, Berichte und Dashboards zu generieren. Wenn Sie also planen, Datenanalyse in Ihrem Projekt einzusetzen, sollten Sie sich für nicht-relationale Datenbanken sowie darüber hinaus ein Data Warehouse oder ein Data Lake entscheiden.
Es kann auch vorkommen, dass Sie für Ihr Unternehmen sowohl OLTP- als auch OLAP-Systeme benötigen. Eine solche Kombination ist ebenfalls möglich und erweist sich als effizient, um das Potenzial Ihrer Daten zu maximieren.
Wie Sie sehen können, gibt es bei der Auswahl der richtigen Datenbank mehrere Faktoren zu berücksichtigen. In dem nächsten Abschnitt werden die fünf beliebtesten Datenbanken vorgestellt und deren Vor- und Nachteile beleuchtet.
Erfahren Sie, wie das Aufbau eines Enterprise Data Warehouse (EDW) Ihnen bei der Modernisierung Ihres digitalen Transformationsprozesses helfen kann.
Lesen Sie den ArtikelDie 5 besten Datenbanksysteme für Ihre Softwarelösung
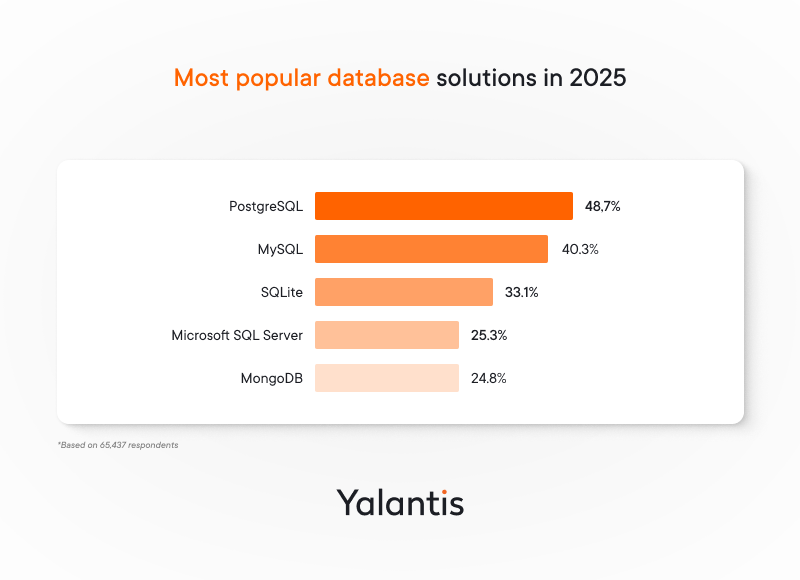
Laut dem Stack Overflow Developer Survey 2024, Von den fünf am häufigsten verwendeten DBMS-Programmen gehören vier zur SQL-Familie:
- PostgreSQL
- MySQL
- SQLite
- Microsoft SQL Server
- MongoDB
Aufgrund der 65.437 erhaltenen Antworten ist es wahrscheinlicher, dass professionelle Entwickler PostgreSQL verwenden (51%), und es ist wahrscheinlicher, dass diejenigen, die lernen, zu programmieren, MySQL verwenden (45%).
Nun wollen wir besprechen, was diese Datenbanken so beliebt macht und wie Sie sie in Ihr Projekt integrieren können.
PostgreSQL
PostgreSQL ist eine objektrelationale Datenbank, was bedeutet, dass sie ähnelt relationalen Datenbanken, die Daten in Form von Objekten anstatt von Spalten und Zeilen darstellen.
Vorteile:
- Bietet eine robuste Funktionspalette, einschließlich erweiterter Indexierung, vollständiger ACID-Compliance und Unterstützung für komplexe Abfragen und Fremdschlüssel.
- Kann sehr erweiterbar sein und benutzerdefinierte Datentypen und Funktionen unterstützen, während gleichzeitig die SQL-Standards strikt eingehalten werden.
- Es verfügt über eine starke und aktive Community, die zuverlässige Updates bereitstellt und eine Fülle an Lernressourcen bietet.
Nachteile:
- Es kann hinsichtlich der Ressourcenintensität gegenüber anderen Datenbanken höher sein und erfordert mehr Speicherplatz und Rechenleistung für eine optimale Leistung.
- Einige seiner Funktionen und Einstellungen sind schwierig zu konfigurieren und zu verwalten, insbesondere für Anfänger.
- Verfügt in der Regel über eine geringere Schreibgeschwindigkeit als andere Datenbanken, was eine Einschränkung für schreibintensive Anwendungen sein kann.
Unternehmen, die PostgreSQL verwenden: Netflix, Uber, Instagram, Spotify, Instacart und viele weitere.
MySQL
MySQL wurde 1995 von Oracle entwickelt und wird von Oracle verwaltet. Es ist eine der am häufigsten verwendeten Datenbankmanagement-Lösungen. Dieses Open-Source-Datenbanksystem verfügt über eine große Nutzerbasis und eine hervorragende Support-Struktur. Es funktioniert gut mit den meisten Bibliotheken und Frameworks und ist kostenlos, bietet jedoch zusätzliche Funktionen gegen eine jährliche Gebühr.
Vorteile:
- Große Leistung und Skalierbarkeit für eine breite Palette kleiner und mittelgroßer Anwendungen, einschließlich Webanwendungen.
- Eine umfassende Reihe von Funktionen wie gespeicherte Prozeduren, Trigger, Ansichten und transaktionsspezifische Unterstützung machen MySQL für komplexe Aufgaben im Datenmanagement geeignet.
- Die große Community unterstützt und verbessert ständig die Datenbankfunktionen und aktualisiert die Dokumentation.
Nachteile:
- Bei großformatigen Datenbanken und komplexen Abfragen kann es zu Leistungseinschränkungen kommen. Wenn Sie planen, Ihr Produkt künftig skalieren zu lassen, könnten Sie möglicherweise Bedarf haben zusätzliche Unterstützungsleistungen, wie MySQL Heatwave oder MySQL NDB Cluster, die teuer sind.
- Begrenzte Funktionalität für fortgeschrittenere Analyse- und Berichtsfunktionen.
- Die Verarbeitung von binären großen Objekten (Blobs), wie z. B. Multimedia-Dateien, kann zu Systembeschränkungen führen.
Unternehmen, die MySQL verwenden: Uber, Facebook, Tesla, YouTube, Netflix, Spotify und Airbnb. Yalantis verwendet diese Datenbank auch für die Datenverwaltung und die Entwicklung.
Möchten Sie sicherstellen, dass Ihre Datenarchitektur skalierbar und sicher ist?
SQLite ist ein Open-Source-Embedded-SQL-Datenbank-Engine. Es erfordert keine separate Server-Prozess und ermöglicht den Zugriff auf die Datenbank mithilfe einer nicht standardmäßigen Variante der SQL-Abfrage-Sprache.
Vorteile:
- SQLite erfordert minimale Einrichtung und Konfiguration, was es einfach macht, es in Anwendungen einzubinden.
- Da es selbstständig funktioniert, enthält es keine Abhängigkeiten, was zu seiner Zuverlässigkeit und Robustheit beiträgt.
- Keine Installation oder Administration erforderlich, was es ideal für Anwendungen macht, die ein unkompliziertes Datenbanksystem erfordern.
Nachteile:
- Unterstützt nur serialisierte Transaktionen, was sie für Umgebungen mit hohen Schreibanforderungen oder mehrbenutzerigem Zugriff weniger geeignet macht.
- Probleme bei der Performance bei umfangreichen Datenoperationen und Transaktionen mit hohem Datenvolumen.
- Lacks verfügt nicht über integrierte Funktionen für vernetzte oder verteilte Datenbankanwendungen.
Unternehmen, die SQLite verwenden: Adobe, Bosch, Dropbox, Firefox, Microsoft und viele weitere. Dies macht es zu einer ausgezeichneten Wahl für Anwendungen, die eine hohe Performance erfordern. Integration von Siri in iOS, Da es eine reibungslose Verarbeitung der lokalen Daten und eine hohe Reaktionsfähigkeit gewährleistet.
Microsoft SQL Server
Microsoft SQL Server ist ein relationales Datenbankmanagement-System, das von Microsoft entwickelt wurde. Es ist darauf ausgelegt, eine Vielzahl von Datenverarbeitungsumgebungen in Unternehmensumgebungen zu unterstützen – von kleinen Einzelmaschinenanwendungen bis hin zu großen Internetanwendungen mit vielen gleichzeitigen Benutzern.
Vorteile:
- Bietet eine breite Palette an integrierten Funktionen, einschließlich fortgeschrittener Analysen, robusten Sicherheitsfunktionen und umfassender Tools für die Datenverwaltung.
- Es bietet eine nahtlose Integration mit anderen Microsoft-Produkten und -Diensten und verbessert die Produktivität für Unternehmen, die bereits das Microsoft-Ökosystem nutzen.
- Bekannt für seine hohe Leistungsfähigkeit in der Transaktionsverarbeitung, der Business Intelligence und der Analytik sowie seine umfangreichen Skalierbarkeitsmöglichkeiten.
Nachteile:
- Die Lizenzgebühren und Betriebskosten können hoch sein, insbesondere für größere Organisationen oder solche, die erweiterte Funktionen benötigen.
- Kann die Systemressourcen beanspruchen, insbesondere bei größeren oder komplexeren Implementierungen.
- Verschiedene Datenmodelle, Funktionen und Konfigurationen erfordern erfahrene Datenbankadministratoren für die Performance-Management-Funktionalität.
Unternehmen, die Microsoft SQL Server verwenden: Walmart, Reddit, Stack Overflow, Cisco, JPMorgan Chase und viele weitere.
MongoDB
MongoDB ist eine der besten Datenbanken für Web-Apps. Es ist auch die Datenbank, die das Technologie-Team von Yalantis in ihren Projekten am häufigsten verwendet.
MongoDB ist eine NoSQL-Datenbank, die alle Daten in BSON-Dokumenten (Binary JSON) speichert. Dank dieser Funktion ist es möglich, Daten zwischen Webanwendungen und Servern in einem menschlich lesbaren Format zu replizieren.
Vorteile:
- Erlaubt eine dynamische und flexible Datenmodell- und Schema-Design, was sie ideal für Anwendungen mit sich entwickelnden mehreren Datenmodellen macht.
- Einfach skalierbar, unterstützt horizontale Skalierung durch die Erstellung von Partitionen (Shards) und eignet sich ideal für die Verwaltung großer Datenmengen.
- Bietet eine hohe Leistung sowohl bei Lesevorgängen als auch bei Schreibvorgängen, insbesondere bei unstrukturierten Daten.
Nachteile:
- Kann erhebliche Mengen an Speicher für die Datenspeicherung und -indizierung beanspruchen.
- Die Transaktionsverwaltung ist trotz der jüngsten Verbesserungen immer noch komplexer als bei traditionellen relationalen Datenbanken.
- Komplexere und weniger intuitive aggregierte Datenabfragen als in SQL-Datenbanken führen möglicherweise zu einer steileren Lernkurve.
Unternehmen, die MongoDB verwenden: Bosch, Cisco, Forbes, Google, eBay und viel mehr.
4 alternative Datenbanklösungen für Ihr Projekt
OracleDB
Oracle-Datenbank, ein in 1977 entwickeltes RDBMS, bleibt das beliebteste Datenbankmanagement-System und die vertrauenswürdigste Lösung auf unserer Liste. Es steht an erster Stelle in der DB-Motoren-Ranking. Lassen Sie uns genauer auf die Gründe für die Popularität von OracleDB eingehen:
Vorteile:
- Es wird von Oracle unterstützt und ist daher eine zuverlässige Datenbank. Entwickler weisen darauf hin, dass die Oracle DB selten ausfällt und regelmäßig aktualisiert wird.
- Es ist gut skalierbar und gilt als die beste Datenbank für große Datensätze. Die Oracle-Datenbank bringt derzeit alle Produkte und Dienstleistungen in die Cloud, was zu mehr Flexibilität führt.
- Es ist sicher und erfüllt streng die modernsten Sicherheitsstandards (einschließlich PCI-Compliance) und bietet eine gute Verschlüsselung sensibler Daten.
- Es verarbeitet Speicher sehr effizient und übernimmt komplexe Aufgaben problemlos. Außerdem verwaltet und organisiert es effektiv eine Vielzahl von Drittanbieter-Tools.
- Es übertrifft andere Lösungen in Bezug auf die Geschwindigkeit des Datenzugriffs über das Netzwerk.
Nachteile:
- Die Lizenzgebühren und Supportkosten für Oracle DB können sehr hoch sein und sind daher für kleinere Organisationen nicht erschwinglich. Eine Prozessorlizenz für die Standard-Edition kostet $17.500 pro Einheit.
- Oracle bietet eine komplizierte Dokumentation und verfügt über keine guten Anleitungen. Obwohl die Kundensupport-Abteilung hilfreich ist, beklagen sich einige Entwickler über lange Reaktionszeiten.
- Oracle DB kann erhebliche Hardware- und Systemressourcen erfordern, was für einige Implementierungen eine Einschränkung darstellen kann.
Anwendungsfälle: Unternehmenanwendungen, Finanzdienstleistungen, E-Commerce
Redis
Redis, kurz für Remote Dictionary Server, ist ein Open-Source-Key-Value-Store, der oft als Zwischenspeicher für die Arbeit mit anderen Datenspeicherlösungen eingesetzt wird.
Vorteile:
- Speichert Daten in der eigenen Speicherinfrastruktur und ermöglicht dadurch extrem schnelle Lese- und Schreiboperationen, was sie für die Zwischenspeicherung häufig verwendeter Daten geeignet macht.
- Unterstützt verschiedene Datentypen wie Strings, Listen und Sets und bietet dadurch Flexibilität bei der Datenmodellierung.
- Es bietet integrierte Unterstützung für Publish/Subscribe-Messaging, die eine Echtzeitkommunikation zwischen Anwendungen ermöglicht.
Nachteile:
- Es ist möglicherweise nicht geeignet für Anwendungsfälle, in denen die Datenbeständigkeit und -persistenz entscheidend ist, da die Daten in der RAM-Speicherung gespeichert werden.
- Es ist möglicherweise keine gute Wahl für große Datensätze, da die Menge an Daten, die Redis verarbeiten kann, durch die verfügbare RAM-Kapazität begrenzt ist.
- Verwendet einen ein-Thread-Event-Loop, der in bestimmten Szenarien, wie bei komplexen Abfragen oder Blockierungsoperationen, die Leistung einschränken kann.
Anwendungsfälle: Caching, Echtzeitdatenanalyse, Sitzungsspeicherung und -abruf
Elasticsearch
Elasticsearch ist ein Open-Source-System zur Such- und Analyseautomatisierung, das auf Apache Lucene basiert. Es wurde entwickelt, um große Datenmengen schnell und in Echtzeit zu speichern, zu suchen und zu analysieren.
Vorteile:
- Besonders gut geeignet für die vollständige Textsuche, ideal für Anwendungen, die eine schnelle und präzise Suchfunktion erfordern.
- Aufgrund seiner horizontalen Skalierbarkeit kann der Cluster mit weiteren Knoten erweitert werden, um die zunehmende Daten- und Abfrageloads aufnehmen zu können.
- Bietet Echtzeit-Indizierung und Suchfunktionen, wodurch es für Anwendungen geeignet ist, die aktuelle Daten benötigen.
Nachteile:
- Die Einrichtung und Konfiguration von Elasticsearch kann komplex sein, insbesondere bei großflächigen Implementierungen.
- Die Ausführung von Elasticsearch erfordert erhebliche CPU-, Speicher- und Speicherplatzressourcen.
- Es ist möglicherweise nicht die beste Wahl für Anwendungen, die hohe Haltbarkeit garantieren müssen.
Anwendungsfälle: Loganalyse, Infrastrukturüberwachung, E-Commerce-Suche
ClickHouse
ClickHouse ist ein Open-Source-Spaltendatenbanksystem, das für Analysen und Data Warehousing entwickelt wurde. Es ist bekannt für seine Geschwindigkeit und Effizienz bei der Arbeit mit großen Datensätzen und ist daher eine beliebte Wahl für analytische Workloads.
Vorteile:
- Eine der schnellsten modernen Datenbanken für analytische Abfragen aufgrund ihrer spaltenförmigen Speicherstruktur und der effizienten Abfrageausführung.
- Bietet eine hervorragende Datenkomprimierung, die es Organisationen ermöglicht, große Datenmengen effizient zu speichern.
- Unterstützt SQL-Abfragen, sodass sie auch für Benutzer geeignet ist, die mit SQL vertraut sind.
Nachteile:
- Sie eignet sich hauptsächlich für analytische Workloads und ist möglicherweise nicht die beste Wahl für transaktionale oder OLTP-Anwendungen.
- Die Einrichtung und Konfiguration von ClickHouse erfordert möglicherweise Fachwissen, insbesondere bei verteilten Implementierungen.
- Die Datenaufnahme kann nicht so schnell sein wie in anderen Systemen, die für die Echtzeit-Verarbeitung großer Datenmengen konzipiert sind.
Anwendungsfälle: Analytik und Reporting, Data Warehousing, IoT-Anwendungen
Suchen Sie ein Datenbankmanagement-System, das Ihren spezifischen Projektanforderungen entspricht?
Yalantis bietet Expertenberatung bei der Auswahl und Implementierung der idealen Datenbanklösungen für Ihre spezifischen Anforderungen.
9 Datenbankmanagementsysteme verglichen
Im Folgenden finden Sie eine detaillierte Übersicht der besten Datenbankmanagementsysteme, die wir zuvor anhand von Datenintegrität, Leistung, den besten Einsatzmöglichkeiten und der Unterstützung für Anfänger beschrieben haben.
|
Datenbank |
Art |
Datenintegrität |
Leistung |
Beste Anwendungsfälle |
Support für Anfänger |
|
PostgreSQL |
Objektrelational (SQL) |
ACID |
Hohe Anforderungen bei häufigen und gleichzeitig stattfindenden Schreiboperationen; erfordert Speicherressourcen, um die Skalierung für mehrere Benutzer zu ermöglichen |
Finanz-Apps, Analyse-Systeme und Plattformen für Gesundheitsdaten |
Moderater Community-Onboarding, hervorragende Dokumentation; erfordert Grundkenntnisse in SQL und DB-Optimierung |
|
MySQL |
Relational (SQL) |
ACID |
Gute allgemeine Leistung bei Apps, die viel zum Lesen benötigt werden; Engpässe bei komplexen Verknüpfungen und großen Datensätzen |
Webanwendungen, CRM, E-Commerce |
Geeignet für Anfänger, vielseitig in Tutorials verwendet, umfangreiche Dokumentation |
|
SQLite |
Embedded SQL |
ACID (begrenzt) |
Mittelmäßiger Performancewert; ideal für lokale, leichte Anwendungen, aber nicht für simultane oder großflächige Datenverarbeitung. |
Mobile Apps, IoT, Embedded Systeme |
Sehr einfach zu bedienen; minimale Einrichtung und einfache API |
|
Microsoft SQL Server |
Relational (SQL) |
ACID |
Hohe Leistung für Enterprise-Grade OLTP und Analysen; ressourcenintensiv in großem Maßstab |
Unternehmensdaten-Systeme, Enterprise-Analytics |
Steiler Lernpfad; GUI-Tools helfen, aber die Installationskomplexität ist hoch |
|
MongoDB |
Dokumentenarchiv (NoSQL) |
BASE (mit optionaler ACID) |
Hohe Leistung bei flexiblen Schemas und unstrukturierten Daten; Indexierung und Speicherverbrauch beeinträchtigen die Schreibgeschwindigkeit |
Inhaltmanagement, mobile Backends, Produktkataloge |
Mittelmäßig; flexibel, aber die Abfrage von Daten erfordert das Erlernen neuer Paradigmen |
|
Orakel |
Mehrmodellesystem (SQL) |
ACID |
Sehr hoher Durchsatz, optimiert für schwere Transaktionssysteme; aufwendige Einrichtung |
Bankenwesen, ERP, Telekommunikation |
Eine Herausforderung für Neulinge; Enterprise-Funktionen und komplexe Einrichtung |
|
Redis |
Key-Value-Speicher (NoSQL) |
BASE |
Extrem schnell für In-Memory-Verfahren; optimal für die Zwischenspeicherung und vorübergehende Daten, nicht für dauerhafte Speicherorte |
Caching, Echtzeit-Chat und Ranglisten-Verfolgung |
Einfach zu starten; die Befehle sind intuitiv und umfassend dokumentiert |
|
Elasticsearch |
Dokumentenarchiv (NoSQL) |
BASE |
Ideal für Volltextsuche und Analysen; langsamer bei großen Verknüpfungen oder Echtzeitaktualisierungen |
Loganalytik-, Überwachung- und Suchsysteme |
Mittelmäßige Schwierigkeit; erfordert das Verständnis von Indexierungs- und Clusterkonfigurationen |
|
ClickHouse |
Kolumnarisch (SQL) |
Teilbas (eventuelle Konsistenz) |
Sehr hohe Performance bei analytischen Abfragen aufgrund der Säulenspeichertechnologie; nicht optimiert für transaktionale Workloads |
Business Intelligence, Reporting und IoT-Analysen |
Erweiterte Version, ideal für erfahrene Ingenieure in Analyse-Umgebungen |
Datenbanken nach Ihren Bedürfnissen kombinieren und anpassen
Die Verwendung mehrerer Datenbanken für ein Projekt, um die Stärken jeder zu nutzen, ist eine häufige praktische Lösung, um spezifische Projektanforderungen zu erfüllen. Entwickler sollten jedoch diese Entscheidung nur nach einer sorgfältigen Analyse und Definition des Technologie-Stacks des Produkts treffen.
Beispielsweise können Sie eine relationalen Datenbank wie MySQL oder PostgreSQL für die Speicherung und Abfrage strukturierter Daten verwenden und gleichzeitig eine NoSQL-Datenbank wie MongoDB für die flexible und skalierbare Speicherung unstrukturierter Daten (medizinische Bilder, E-Mails, Social-Media-Beiträge) integrieren. Diese hybride Lösung ermöglicht es Ihnen, Ihre Datenmanagementstrategie entsprechend den spezifischen Anforderungen unterschiedlicher Datenmodelle Ihrer Anwendung zu optimieren.
Allerdings funktionieren nicht alle Datenbank-Matches nahtlos. Wenn Sie eine Umgebung erstellen möchten, die aus zwei oder mehr Datenbankplattformen besteht, sollten Sie Folgendes berücksichtigen:
- Datenkonsistenz und -integrität. Wenn der Datenmanagementprozess nicht ordnungsgemäß synchronisiert wird, kann dies zu Ungenauigkeiten in mehreren Datenbanken führen. Es ist wichtig, robuste Mechanismen zur Datensicherheit und -konsistenz zu implementieren, wie beispielsweise verteilte Transaktionen oder endgültige Konsistenzmodelle, je nach Anwendungsfall und den jeweiligen Datenbanktechnologien.
- Datenkomplexität und Wartbarkeit. Die Verwendung mehrerer Datenbanken erhöht die Komplexität der Systemarchitektur. Eine sorgfältige Planung und Dokumentation ist erforderlich, um diese Herausforderungen zu bewältigen und sicherzustellen, dass das System handhabbar bleibt und die Entwickler die Interaktionen zwischen den verschiedenen Datenbanken verstehen.
- Systemleistung und Skalierbarkeit. Verschiedene Datenbanken können unterschiedliche Skalierbarkeitseigenschaften aufweisen. Hierbei sind zu berücksichtigen: wie jede Datenbank Lese-/Schreiboperationen durchführt, ihre Skalierbarkeit in Bezug auf Datenvolumen und Abfragenkomplexität sowie die Gesamtauswirkungen auf die Anwendungseffizienz.
- Dateneingabe-Verhaltensmuster. Verschiedene Datenbanken verfügen oft über eigene Abfragen-Sprachen und APIs (SQL für relationale Datenbanken, Cypher für Neo4j, der Abfrage-Sprachcode von MongoDB). Dies bedeutet, dass Ihr Projekt unterschiedliche Datenzugriffsmuster berücksichtigen muss, wie beispielsweise Transaktionen in relationalen Datenbanken oder flexibles Dokumentzugriff in NoSQL-Datenbanken.
- Sicherheit und Compliance. Jedes Datenbanksystem kann eigene Sicherheitsfunktionen und Compliance-Standards haben. Es ist wichtig sicherzustellen, dass alle in dem Projekt verwendeten Datenbanken die erforderlichen Sicherheitsprotokolle einhalten, wie z. B. Datenverschlüsselung, Zugriffskontrollen und Auditing.
Die Wahl der Datenbank für Ihr Projekt hängt von vielen Faktoren ab, einschließlich der Art der Daten, die Sie sammeln und verarbeiten möchten, der Integration mit anderen Tools sowie der Skalierungsstrategie, die Sie verfolgen. Es geht nicht nur um SQL oder NoSQL, wie viele denken.
Und obwohl das richtige Datenmanagement vielleicht nicht das erste Anliegen bei der Optimierung der Benutzererfahrung ist, sollte es es definitiv sein. Wir können Ihnen dabei helfen, die bestmögliche Datenbanklösung für Ihre Web- oder Mobile-Lösungen zu finden. Schreiben Sie uns, wenn Sie uns helfen möchten, die richtige Datenbank für Ihre Bedürfnisse auszuwählen.
Erfahren Sie, in welchen Datentechnologien wir uns gut auskennen
Wir helfen Ihnen dabei, eine flexible und skalierbare App mit einer sicheren Datenarchitektur zu erstellen.
FAQ
Welche Datenbanklösung ist für mobile Apps mit variabler Nutzerzahl am zuverlässigsten?
Es ist empfehlenswert, auf NoSQL-Datenbanken zu setzen, da diese eine hohe Skalierbarkeit, Flexibilität und die Möglichkeit bieten, große Mengen an unstrukturierten Daten zu verarbeiten. SQL-Datenbanken können eine gute Wahl sein, wenn Ihre App komplexe Abfragen und Transaktionsintegrität erfordert, haben jedoch oft Performanceprobleme bei großen Datenmengen.
Wie groß ist der ROI-Vorteil zwischen SQL- und NoSQL-Datenbanken?
SQL-Datenbanken Sie haben oft höhere Anfangskosten aufgrund von Infrastruktur- und Wartungskosten, bieten jedoch langfristige Renditen durch Datengenauigkeit, Compliance und ausgereifte Ökosysteme. Sie verringern Risiken in Branchen, in denen Fehler kostspielig sind (z. B. im Gesundheitswesen und in der Bankenbranche).
NoSQL-Datenbanken Sie können dank geringerer Anfangskosten, schnelleren Entwicklungszyklen und einfacher Skalierbarkeit schnelleren ROI für hochwachstumsstarke, umfangreiche Inhalte oder weniger regulierte Apps erzielen. In der Praxis hängt der ROI letztendlich davon ab, wie gut die Datenbank den Anforderungen Ihrer App hinsichtlich Leistung, Komplexität und Wachstum entspricht – und nicht nur vom Datenbanktyp.
Wie beeinflusst die Auswahl der Datenbank die Markteinführungszeit eines Produkts?
Ihre Datenbank beeinflusst die Geschwindigkeit, mit der Sie Ihr Produkt entwickeln, testen und skalieren können. NoSQL-Datenbanken Sie ermöglichen eine schnellere Iteration während der Entwicklung aufgrund ihrer Schemaflexibilität. Sie eignen sich ideal für MVP-Entwicklungen, sich ändernde Anforderungen und agile Teams. SQL-Datenbanken Es braucht mehr Zeit, um strenge und komplexe Datenmodelle zu implementieren und zu kontrollieren, doch sie reduzieren die Risiken im weiteren Verlauf, indem sie von Anfang an Konsistenz und Integrität gewährleisten.
Die Wahl einer Datenbank, die zu Ihrer aktuellen Entwicklungsgeschwindigkeit und zukünftigen Skalierungsanforderungen passt, kann den Weg zur Markteinführung erheblich verkürzen und kostspielige Nacharbeit später vermeiden helfen.
Über den Autor