Sobald Sie einen geeigneten Weg gefunden haben, Ihre Daten zu sammeln, zu speichern, zu verwalten, zu transformieren, zu analysieren und anschließend zu nutzen (z. B. ein Data Lake), können Sie viele Ihrer internen Abläufe verbessern. Zum Beispiel werden die globalen Trends von 2024 KPMG-Umfrage Von 2.450 Führungskräften bewerteten 89 Prozent die Daten- und Analyselösungen als den wichtigsten Faktor für die Profitabilität im Technologiebereich. Die Mehrheit (89 Prozent%) berichtete über einen positiven Einfluss von Initiativen zur Nutzung von Daten und Analysen auf die Ergebnisentwicklung des Unternehmens.
Neue Möglichkeiten in der Datenanalyse ermöglichen es Unternehmen, mehr Umsatz zu generieren, bessere strategische Entscheidungen zu treffen und ihren Kunden spannende Geschichten zu erzählen. Um alle ihre Datenressourcen an einem einzigen Ort zu konsolidieren, implementieren erfolgreiche Unternehmen Data Warehouses, Data Lakehouses und Data Lakes. In diesem Blogbeitrag gehen wir ausführlich auf das Konzept von Data Lakes ein.
Wir besprechen die Vorteile eines Data Lakes für Ihr Unternehmen, erklären die Architektur und die Einsatzmöglichkeiten von Data Lakes und stellen Ihnen eine Tabelle zur Verfügung, die mehrere beliebte Tools vergleicht, um Ihnen zu helfen, den besten Data Lake-Anbieter anhand Ihres Budgets, der Funktionalität und Ihrer Integrationspräferenzen auszuwählen. Wir vergleichen die Data Lakes außerdem kurz mit Data Warehouses, um Ihnen einen allgemeinen Überblick darüber zu geben, wie Data Lakes sich von anderen Lösungen unterscheiden.
Was ist ein Data Lake und wie funktioniert es?
Ein Data Lake ist ein zentraler Datenspeicher, der alle Arten von Daten – strukturierten, unstrukturierten und semistrukturierten – zusammenführen und eine einfache Datenabfrage sowie die Weiterverwendung für fortgeschrittene Datenanalyselösungen ermöglicht. Mit Hilfe eines Data Lakes können Unternehmen die großen Datenströme aus internen und externen Quellen besser verwalten und ein umfassendes Verständnis der Geschäftslage aufrechterhalten. Es ist eine viel bessere Option als das Speichern von Daten in gesonderten Datenbanken, die in verschiedenen Abteilungen verteilt sind.
Wie funktioniert ein Data Lake? Im Vergleich zu Data Warehouses können Data Lakes viel größere Datenmengen (und verschiedene Datentypen) speichern. Tatsächlich entstand der Bedarf an Data Lakes aufgrund der begrenzten Kapazitäten eines Data Warehouses.
Um in einen Data Lake aufgenommen zu werden, muss die Daten nicht transformiert werden und sie können in einem Rohformat gespeichert werden, was die Geschwindigkeit der Datenaufnahme im Vergleich zu einer relationalen Datenbank erheblich erhöht. Unternehmen-Datenbanken. Während Data Warehouses auf einem Extract-Transform-Load- (ETL-)Motor basieren, verwenden Data Lakes das Extract-Load-Transform-Modell (ELT), da sie Rohdaten nur auf Anfrage transformieren, nicht jedoch unmittelbar nach der Datenextraktion wie Data Warehouses.
Warum und wann sollte man einen Data Lake verwenden?
Mit einem Data Lake können Sie alle Daten zusammen speichern und dadurch die Datenspeicherkosten senken sowie neue Analysefunktionen ermöglichen, die ein Data Warehouse nicht unterstützen kann. Allerdings können beide Arten von Datenspeichersystemen vorteilhaft sein, da Data Warehouses eine bequemere Datenstruktur für Business Intelligence und historische Datenanalysen bieten.
Ein Data Lake kann die richtige Option für Sie sein, wenn Ihre Geschäftsziele Folgendes umfassen:
Verbesserung der Echtzeit-Datenaggregation aus verschiedenen Quellen. Wenn Ihr Unternehmen über viele Quellen eingehender Daten verfügt, wie z. B. IoT-Sensoren und -Geräte, Kundendaten, einschließlich Bewertungen oder Umfragen, Social Media und Unternehmenssysteme, kann die Implementierung eines Data Lakes eine praktikable Option sein (z. B. ein Data Lake für Kundendaten). Zudem ist ein Data Lake äußerst skalierbar (da er viele Daten verarbeiten kann) und kann für Low-Latency-Abfragen und Datenabruf optimiert werden. Darüber hinaus ermöglicht die Implementierung eines Data Lakes die Kombination aller wichtigen Geschäftsdaten in einem einzigen Speicherort und hilft bei der Durchführung einer besseren Ursachenanalyse, um schnell auf cross-unternehmensweite Probleme aufmerksam zu werden.
Die Bereitstellung von Big Data-Verarbeitung und -Analysen. Data Lakes speichern alle Arten von strukturierten, unstrukturierten und semistrukturierten Daten und können problemlos mit fortschrittlichen Analysetools und maschinellen Lernverfahren integriert werden, sodass Data Scientists effiziente Deep-Data-Analysen durchführen können. Wenn Ihnen die Implementierung fortschrittlicher Datenanalysen jedoch kompliziert erscheint, sollten Sie Yalantis umfassende Funktionen in Betracht ziehen. Datenwissenschaftliche Dienstleistungen um sicherzustellen, dass dieser Prozess reibungslos abläuft und für Ihr Unternehmen von Vorteil ist.
Effiziente Nutzung von Machine-Learning-Algorithmen. Die meisten Anbieter von Data Lakes erwähnen, dass Data Lakes besonders nützlich für Data Scientists, Data Engineers und AI-Ingenieure für die Datenexploration und das Modelltraining sein können. Dies liegt hauptsächlich daran, dass Data Lakes Zugang zu umfassenden und komplexen Big-Data-Datasets bieten, die für das Training und die Entwicklung präziser und effektiver maschineller Lernalgorithmen ausreichend umfangreich und komplex sind (Anwendungsfälle für maschinelles LernenAußerdem verfügen Datenseen nicht über vordefinierte Schemata (die hauptsächlich zur Organisation von Daten in relationalen Datenbanken und Data Warehouses verwendet werden) und bieten mehr Flexibilität.
Nahtlose und kostengünstige Integration in eine Cloud-Umgebung. Der Übergang Ihrer IT-Infrastruktur von der On-Premise-Plattform in die Cloud kann auch die Verlagerung des größten Teils Ihrer proprietären Daten in einen Data Lake umfassen. Die meisten Cloud-Serviceanbieter wie Amazon bieten kostengünstige und skalierbare Lösungen. Die Instandhaltung eines Data Lakes vor Ort kann aufgrund von Hardwareausfällen beispielsweise schwierig sein, da ein Data Lake große Datensätze verarbeitet und eine hohe Rechenleistung benötigt.
Domain-agnostische Daten-Lake-Integrationsmöglichkeiten
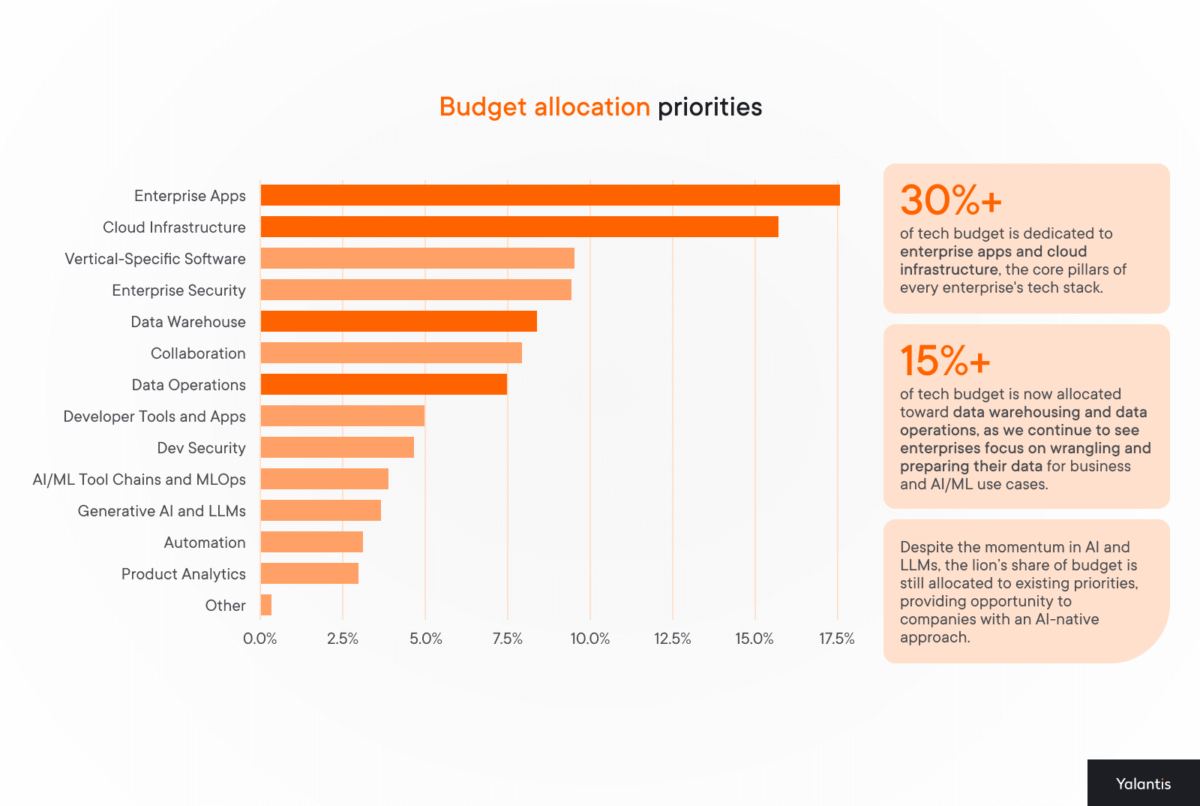
Für ihre Bericht über die Ausgaben für Cloud-Software, Battery Ventures hat 100 Chief Experience Officers (CXOs) in den Finanzdienstleistungen, der Technologie, im Gesundheitswesen und in der Fertigung befragt. Im Folgenden finden Sie eine Tabelle aus diesem Bericht, die die wichtigsten Prioritäten der Unternehmen im Bereich Data Management im Jahr 2024 aufzeigt. Wir sehen, dass Data Warehousing und Data Operations mehr als 15 Prozent des Tech-Budgets der befragten Organisationen einnehmen. Wenn Sie eine effiziente Data Storage-Lösung implementieren, sind alle anderen Aspekte der Dateninfrastruktur, wie z. B. Data Governance-Prozesse und Datenvisualisierungsmöglichkeiten (Datenvisualisierungsdienste), Datenanwendungen und die Echtzeit-Datenverwaltung ergeben sich.
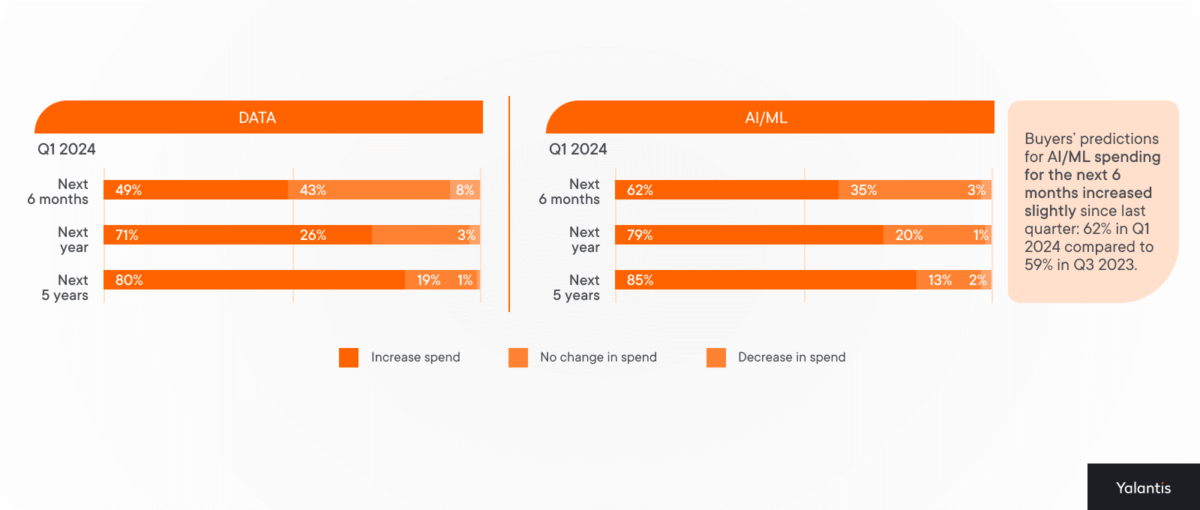
Die Investitionen in Daten werden voraussichtlich ebenfalls steigen; 80% der befragten CXO-Manager planen, in den nächsten fünf Jahren mehr auf Datenprozesse zu investieren.
Wenn Sie Ihre Daten so nutzen möchten, dass sie mehr Erkenntnisse liefern als derzeit der Fall ist, kann eine Investition in einen Data Lake vorteilhaft sein.
Daten-Lake-Architektur
Die Implementierung eines Data Lakes erfordert die Anbringung von sechs Schlüsselkomponenten. Zusammen bilden sie die konventionelle Architektur eines Data Lakes. Lassen Sie uns diese kurz zusammenfassen:
- Datenquellen. Ihr Data Lake kann strukturierte, unstrukturierte und halbstrukturiert Daten aus internen und externen Quellen abrufen. Gängige Quellen sind CRM-Systeme, ERP-Systeme, Social Media, IoT-Geräte und relationalen Datenbanken.
- Datenaufbereitung. Dies sind die Extrahierung und das Laden von Prozessen, die die erstellten Daten aufnehmen und in den Data Lake integrieren. Die Daten können je nach Bedarf in Sätzen oder in Echtzeit über APIs und Datenintegrationsplattformen importiert werden.
- Datenspeicherung und -verarbeitung. Die Rohdaten landen schließlich in der sogenannten Landezone des Data Lakes. Anschließend werden sie in einem separaten Bereich transformiert und in den Bereich der verfeinerten Daten übertragen.
- Analytisches Umfeld. Auch als analytische Sandbox bekannt, ermöglicht diese Ebene die Erforschung, Entdeckung und Nutzung von Daten für maschinelles Lernen und Datenanalyse. Sie ist von der Datenspeicherung getrennt, um eine Abnahme der Datenqualität zu verhindern.
- Verbrauch von Daten. Diese Ebene stellt Daten und Erkenntnisse auf benutzerfreundliche Weise bereit und liefert diese an Business-Intelligence-Tools wie Power BI und Tableau.
- Governance und Sicherheit. Diese umfassende Ebene definiert und implementiert die Regeln für den Datenzugriff, -austausch, -sicherheit und -qualität. Sie umfasst außerdem Überwachungswerkzeuge und Datenmanagement.
Hinweis: Dies ist eine allgemeine Architektur für Datenlagenspeicher, die möglicherweise angepasst werden muss, um sie an die spezifischen Anforderungen Ihres Datenlagenspeichers anzupassen. Um für eine hohe ROI-Ausbeute zu sorgen, sollten Sie beim Entwurf des Projekts über die richtige Datenexpertise verfügen und unterschiedliche Arten von Datenlagenspeichersystemen bewältigen können.
Welche Herausforderungen löst ein Data Lake?
Jedes Unternehmen kämpft in irgendeiner Form mit der Datenverwaltung und der Datenqualität. Hier sind die fünf Herausforderungen, die Data Lakes bestens bewältigen können:
- Datensilos. Diese Herausforderung nimmt zu, seit 2023 sind sieben Punkte hinzugekommen, laut Dataversity. Data Lakes können Rohdaten aus verschiedenen Quellen zentralisieren, von E-Mails und Social Media bis hin zu internen relationalen Datenbanken – sie dienen im Wesentlichen als einzige Quelle der Wahrheit.
- Datenvielfalt. Traditionelle Datenbanken und sogar Data Warehouses sind hervorragend bei der Aggregation strukturierter Daten, können aber nicht mit unstrukturierten Daten umgehen. Dennoch wird geschätzt, dass 80% bis 90% Alle Unternehmensdaten sind unstrukturiert. Data Lakes können alle Datentypen verarbeiten und ermöglichen eine Datenstrategie für alle Datentypen (die derzeit nur bei 16 Prozent der Organisationen implementiert ist).
- Kosten für den Speicher. Wenn Ihre Datenmenge auf Petabyte ansteigen, können Data Warehouses und andere Speicherlösungen zu teuer werden. Data Lakes bieten eine kostengünstigere Alternative, sofern sie optimiert für Cloud-Speichersysteme konzipiert sind.
- Skalierbarkeit. Mit zunehmender Menge und Vielfalt von Daten werden Datenprobleme ein erheblicher Engpass für die fortgeschrittene Analyse. So stellt beispielsweise die Datenvorbereitung eine Herausforderung dar. Nummer eins Hürde für KI-Projekte. Data Lakes ermöglichen es Analyse-Tools, große Datenmengen zu verarbeiten, dank einer verbesserten Performance in Verbindung mit elastischer Skalierung.
- Zugriff in Echtzeit. Andere Datenrepositories erfordern Transformationen, bevor die Daten in diese importiert werden können. Dies stellt eine potenzielle Einschränkung für die Echtzeit-Datenübertragung dar. Datenteiche unterstützen stattdessen das Schema-on-Read-Verfahren, das bedeutet, dass die Daten bei der Abfrage transformiert werden.
Vorteile von Data Lakes
Nachdem wir die Gründe für die Einführung eines Data Lakes behandelt haben, sollten wir uns mit den Vorteilen der Implementierung befassen. Hier sind einige häufige und ungewöhnliche Vorteile eines Data Lakes:
Laufzeitdatenhaltung
Bei der Verwendung eines Data Lakes gehen keine Datensätze verloren oder werden übersehen. Diese Art von Datenrepository ermöglicht es Ihnen, alle Daten zu speichern, die Ihre Organisation für die weitere Nutzung im Rahmen einer umfassenden Datenanalyse erzeugt. Mit einem Data Lake müssen Sie nicht sofort alle Einsatzmöglichkeiten Ihrer Daten kennen, sondern können sie einfach für spätere Datenanalysen speichern. Dienstleistung für die Implementierung von Daten und Analysen Hilft dabei, sicherzustellen, dass Ihr Data Lake für eine nahtlose Integration und effiziente Datenabrufe optimiert ist und somit jederzeit für eine eingehende Analyse bereitsteht.
Flexibilität und Skalierbarkeit
Wenn Sie mehr Softwarelösungen und Geräte für eine effizientere Servicebereitstellung oder eine bessere Geschäftsprozessverwaltung erwerben, bietet Ihnen ein Data Lake mit seiner enormen Speicherkapazität umfassende Unterstützung. Da die Regeln für die Datenspeicherung im Vergleich zu Data Warehouses weniger streng sind, bieten die Vorteile von Data Lakes mehr Flexibilität sowie einfache Datenabfragen und -abrufe.
Verbesserter Kundenservice
Die Erhebung verschiedener Kundendaten, wie Kaufpräferenzen, digitales Verhalten, Präsenz und Aktivitätsniveau auf Social-Media-Plattformen sowie Feedback zu Ihrem Unternehmen oder Ihren Dienstleistungen, kann Ihnen dabei helfen, personalisierte Dienstleistungen, Empfehlungen und Produkte im Rahmen des Datenanalysetransports zu entwickeln und so die Kundenzufriedenheit erheblich zu steigern.
Weitreiche Datenanalyse- und Forschungsfähigkeiten
Die Speicherung und Verarbeitung großer Datenmengen kann bisher unbekannte Geschäftsdaten enthüllen und Ihnen dabei helfen, eingehende Marketing- und Unternehmensanalysen durchzuführen. Auf diese Weise und mit Unterstützung von Big Data-Unternehmen, So können Sie Ihre Produkte und Dienstleistungen besser an die aktuellen Bedürfnisse der Kunden anpassen.
Verringerte Betriebskosten und Investitionskosten
Zu den vielen Vorteilen eines Data Lakes gehört insbesondere die Möglichkeit, große und vielfältige Datensätze in einem einzigen Speicherort zu zentralisieren und einen selbstständigen Datenzugriff zu ermöglichen. Durch die Implementierung eines einzigen Data Lakes können Sie somit Energie sparen, die Anwerbung zusätzlicher Data Engineerings entfallen und zusätzliche Speicherlösungen zur Unterstützung des wachsenden Datenflusses im Unternehmen geschaffen werden.
Verbesserte Geschäftskontinuität
Ein weiterer Vorteil eines Data Lakes besteht in der Möglichkeit, ihn als einheitliches Speicherkonzept zu implementieren, um die Bereitstellung Ihrer Dienste zu beschleunigen und die korrekte Geschäftsbetriebsunsynchronität zu gewährleisten. Beispielsweise:, Das Grand River Hospital implementierte ein Data Lake auf AWS Und sie gelang es, fast drei Terabyte Patientendaten zu migrieren. Dank dieser Migration benötigten sie keine 27 verschiedene Gesundheitsanwendungen mehr. Das Data Lake ermöglichte dem Krankenhaus außerdem, seine Daten effizient und wirtschaftlich zu nutzen.
Die Vorteile von Data Lakes sind nicht auf die oben beschriebenen Aspekte beschränkt, da jede Organisation einzigartig ist. Um den größtmöglichen Nutzen zu erzielen, sollten Sie eine maßgeschneiderte Data Lake-Lösung in Betracht ziehen, die zu Ihrer Geschäftspraxis passt und alle Ihre Anforderungen erfüllt. In diesem Abschnitt werden wir die Einsatzfälle besprechen, in denen ein Data Lake eine absolute Notwendigkeit darstellt.
Anwendungsfälle für Data Lakes mit Beispielen
Die Implementierung eines Data Lakes ist weder neu noch progressiv, aber je besser diese werden, desto mehr Anwendungen ergeben sich für sie. Lassen Sie uns die Anwendungsfälle für Data Lakes besprechen, um zu sehen, wie Sie Data Lake-Lösungen effizient in verschiedenen Geschäftsszenarien nutzen können.
Always-On Business Services
Die Echtzeit-Dateninjektion ermöglicht es Data Lakes, jederzeit und auf Anfrage Daten aus allen Unternehmensdatenbeständen bereitzustellen. Zum Beispiel müssen missionkritische Softwarelösungen wie Banksoftware und Software für klinische Entscheidungsfindung rund um die Uhr funktionieren, damit Benutzer Finanztransaktionen und -operationen ohne Unterbrechung durchführen können.
Beispielsweise können Data Lakes Echtzeit-Betrugserkennung in Finanzen und Bankwesen ermöglichen rund um die Uhr. Oder sie können die Daten bereitstellen, die für die Echtzeit-Erkennung von Cyberbedrohungen und -vorfällen erforderlich sind.
360-Grad-Überblick über Kunden
Die Bereitstellung eines Data Lakes kann dazu beitragen, alle verfügbaren Kundendaten in einem einzigen Speicherort zusammenzufassen und eine umfassende Verfolgung Ihrer Kundendaten zu ermöglichen, um Kunden zeitgerechte Services anzubieten und die Kundenlebensdauer (CLV) zu steigern.
Die Vorteile von Data Lakes beschränken sich nicht auf die konventionelle CX-Personalisierung. Data Lakes ermöglichen auch die Verarbeitung natürlicher Sprache zur Echtzeit-Sentiment-Analyse, die Ihnen dabei helfen kann, CX-Probleme sofort zu erkennen, wenn diese auftreten.
Zum Beispiel entschied sich der deutsche Online-Händler Zalando, auf ein Data Lake umzusteigen, um Kundendaten nicht mehr in veralteten Data-Warehouse-Systemen und verteilten Datenbanken im gesamten Unternehmen zu speichern und so vereinfachte Datenabfragen für ihre Business-Analysten und Data Scientists zu ermöglichen.
Risikoüberwachung in Echtzeit
Um gesetzlichen Bestimmungen zu entsprechen, müssen Unternehmen in verschiedenen Branchen ihre Praktiken bei der Datenspeicherung und -verarbeitung ständig überwachen. Mit einem Data Lake ist die Überwachung der Einhaltung von Vorschriften wesentlich einfacher, da man große Mengen funktionsübergreifender Daten gleichzeitig in einem Überblick darstellen kann. Die Überprüfung von Daten, die in verschiedenen Datenbanken und Data Warehouses verwaltet werden, kann zeitaufwändig sein und regelmäßige Compliance-Kontrollen verlängern.
Neben der Vereinfachung der Einhaltung von Vorschriften können Data Lakes außerdem Daten aus mehreren Quellen konsolidieren, die für das Risikomanagement relevant sind. Dies kann bei Risikobewertungen für Kredit- und Versicherungsvermittlung, der Bearbeitung von Versicherungsansprüchen sowie der Echtzeit-Erkennung von Betrug und Finanzkriminalität von Nutzen sein.
IoT-Ökosystemmanagement
Data Lakes sind auch von Vorteil, wenn Sie ein großes IoT-Ökosystem haben, das regelmäßig viele Daten generiert. Diese Daten sind oft unstrukturiert und können für fortgeschrittene Analysen weiterverarbeitet werden. Ein Data Lake kann diese Daten einfach sammeln und speichern, sodass Sie sie jederzeit nutzen können. Zum Beispiel nutzt der IoT-Geräteanbieter Samsara ein Data Lake, um ausreichende Zuverlässigkeit und Skalierbarkeit für die Abfrage von Daten und die Durchführung umfangreicher Datenanalysen zu gewährleisten.
Die gesammelten IoT-Sensordaten können beispielsweise die vorausschauende Instandhaltung von Anlagen über einen industriellen Data Lake ermöglichen und Ausfallzeiten verhindern. Genau das ist unser Anspruch. Lösung für ein Logistikdatenspeicher-System Ich habe für ein Produktionsunternehmen gearbeitet. In der Energie- und Versorgungsbranche kann IoT-Daten wiederum zur Vorhersage und Anpassung der Energiebedarf und -angebot genutzt werden.
Da wir bereits die Vorteile eines Data Lakes, Anwendungsfälle für Data Lake-Lösungen und Gründe für die Implementierung eines Data Lakes kennengelernt haben, können wir nun mit dem Vergleich häufiger Beispiele für Data Lakes beginnen, um Ihnen bei der Entscheidungsfindung zu helfen, indem wir die wichtigsten Merkmale jedes Data Lakes analysieren.
Erstellung eines Data Lakes: Überblick
Um eine Data-Lake-Lösung zu entwickeln, müssen Sie eine umfassende Datenarchitektur entwerfen, wobei die Datenquellen und -typen berücksichtigt werden. Eine geeignete Datenarchitektur ist entscheidend, um eine nahtlose Datenaggregation, -speicherung und -übertragung mithilfe verschiedener Technologien sicherzustellen. Die Wahl der Technologien hängt maßgeblich von den Fähigkeiten und dem Fachwissen Ihres technischen Teams sowie Ihren geschäftlichen Anforderungen ab.
Darüber hinaus verfügt ein Data Lake über einen separaten Speicher- und Abrufprozess für verschiedene Speicherklassen:
Hot Data, das wiederholt verwendet und regelmäßig abgerufen wird
Kaltes Datenmaterial, das gelegentlich verwendet wird
Archivierte Daten, die nicht mehr verwendet werden und nur für seltene Überprüfungen erforderlich sind
Lassen Sie uns untersuchen, wie man einen Data Lake erstellt.
Vergleich der beliebtesten Datenlagplattformen
In der folgenden Tabelle vergleichen wir fünf beliebte Anbieter von Data Lakes hinsichtlich der Preise, der Funktionalität und der Installationsschwierigkeit. Wir haben diese Tabelle auf der Grundlage der Informationen aus den Websites der jeweiligen Anbieter sowie der G2-Plattform erstellt, die Tausende von echten Nutzerbewertungen enthält.
|
Lieferant |
Preise |
Hauptmerkmale |
Probleme bei der Implementierung |
|
Amazon Simple Storage Services (S3) |
AWS S3 bietet neun verschiedene Speicherklassen und eine kostenlose Testversion (5 GB Standard-Speicherplatz in S3). Der Standardplan umfasst 50 TB Daten pro Monat zum Preis von $0,023 pro GB. Der Preis variiert je nach ausgewählter Region. |
|
Hoch |
|
Azure Data Lake Store |
Freie Testversion ($200 GB) und separate Preise für Premium-, Hot-, Cool-, Cold- und Archivdatenspeicher (die ersten 51 TB an Hot-Daten kosten $0,021 pro GB; die Preise variieren je nach Region). |
|
Mittelmäßig |
|
Google Cloud Storage |
Der Preis variiert je nach Region und Speicherart (Standard-/Nearline-/Coldline-/Archive-/Anywhere-Cache); kostenlose Testversionen sind für neue Produkte und Kunden verfügbar ($300 kostenlose Gutschriften). Die kostenlose Ebene ist für mehr als 20 Cloud-Services verfügbar. Der Preisbereich für Standardspeicher beträgt $0,020 bis $0,023 (US) / $0,025 (EU) / $0,035 (Brasilien) pro GB pro Monat. |
|
Mittelmäßig |
|
Snowflake Data Lake |
30-tägige kostenlose Testversion ($400 GB kostenlose Nutzung) für alle Produkte. Es liegen keine offenen Preiskennzahlen für die Data Lake-Lösung vor. |
|
Mittelmäßig |
|
IBM Cloud Object Storage |
Freie Testversionen (25 GB Speicherplatz pro Monat; $200 kostenlose Gutschriften für 30 Tage) und mehr als 40 kostenlose Produkte; individuelle Zahlungspläne. Die kostenlose Testversion ist verfügbar (5 GB/Monat). Die Standardpläne für Hot Data liegen im Durchschnitt bei $0,0219 pro GB pro Monat. |
|
Mittelmäßig |
Kosten. Die Einrichtung eines Data Lakes kann kostengünstiger sein als die Implementierung eines Data Warehouses, basierend auf unserer Erfahrung als Anbieter von Datenmanagement-Lösungen. Datenbank-Unternehmen. Zum Beispiel berechnet Snowflake für eine Data-Warehouse-Lösung in den USA $40 pro Terabyte pro Monat – das entspricht $0,04 pro Gigabyte. Doch mit einem Data-Warehouse erhalten Sie nur begrenzte Möglichkeiten, insbesondere wenn Ihr Ziel die Einführung neuer Produkte ist. Big Data-Analytik.
Funktionen. Jedes der in der obigen Tabelle aufgeführten Datenlagenexemplare zeichnet sich durch besondere Merkmale aus, die ihn von den Konkurrenten abheben. Ihre Aufgabe ist es, einen Anbieter mit einem Funktionsumfang zu wählen, der für Ihr Geschäftsmodell relevant ist. IBM bietet eine völlig neue Speicherklasse namens Smart Data Storage an, um Ihnen mehr Flexibilität bei der Datenverteilung zu bieten. Azure legt besonderen Wert auf erweiterte Skalierbarkeit und die Erlangung von Sicherheitszertifizierungen, um Unternehmen in verschiedenen Branchen bedienen zu können.
Umsetzung. Nach Feedback von Nutzern auf der G2-Plattform erzielten Amazon S3 und IBM Cloud Object Storage im Vergleich zu allen anderen Data Lakes die niedrigsten Punktzahlen für die Bedienfreundlichkeit (je 8,6 und 8,1 Punkte). Bei anderen Anbietern zeigen Kundenbewertungen auf G2, dass konkurrierende Lösungen mäßig aufwendig zu konfigurieren sind, wobei die Punktzahlen zwischen 9,3 (Azure Data Lake Store), 8,9 (Google Cloud Storage) und 8,9 (Snowflake) variieren. Viele renommierte Data Warehouse-Anbieter wie Snowflake haben begonnen, Data Lake-Services anzubieten, um auf dem Markt bestehen zu bleiben und ihren Kunden eine einfache Migration zu bieten. Wenn Sie also bereits über ein Snowflake- oder ein Amazon-Data Warehouse verfügen, könnte es kostengünstig und zeitsparender sein, eine Snowflake-Data Lake zu implementieren.
Lassen Sie uns von den Beispielen für Data-Lake-Systemen zu einer praktischen Übersicht über die Vorgehensweise bei der Vorbereitung auf eine reibungslose Implementierung eines Data-Lake-Systems übergehen.
6 Schritte zur erfolgreichen Implementierung eines Data Lakes
Im Folgenden stellen wir sechs wichtige Schritte zur Integration von Data Lakes vor, die diesen Weg für Sie einfacher und weniger disruptiv gestalten können.
Schritt 1. Definieren Sie Geschäftsziele. Erfahren Sie, warum Sie ein Data Lake benötigen, welche Arten von Daten Sie speichern möchten und was Sie dank der Implementierung eines Data Lakes erreichen möchten. Sie sollten außerdem die Zustimmung der Stakeholder für diese Lösung einholen und sicherstellen, dass Geschäfts- und technische Teams auf der gleichen Seite stehen.
Schritt 2. Wählen Sie eine Speicherlösung aus. Wählen Sie eine Speicherlösung, die Ihren Anforderungen zur Entwicklung Ihres Data-Lake entspricht. Viele Organisationen entscheiden sich für cloudbasierte Objektspeicherservices wie AWS S3, Azure Data Lake Storage oder Google Cloud Storage. Ihre Wahl kann sich von den gängigen Varianten unterscheiden, die wir in der vorherigen Sektion besprochen haben. Außerdem ist es wichtig, sicherzustellen, dass das Softwareunternehmen, das für Sie ein Data-Lake einrichtet, Erfahrung mit dem Anbieter hat, mit dem Sie Interesse haben.
Schritt 3. Entwerfen einer Datenarchitektur. Die Datenarchitektur sollte die Praktiken der Datenaufnahme und Datenverwaltung berücksichtigen. Die Prozesse zur Datenaufnahme sind entscheidend für die Übertragung von Daten aus verschiedenen Quellen in den Data Lake. Dies kann Batch- oder Echtzeit-Datenaufnahmen umfassen. Ihr Data Architect muss außerdem Richtlinien für die Datenverwaltung festlegen, einschließlich Qualitätsstandards für Daten, Richtlinien zur Datenspeicherdauer und Zugriffskontrollen (Rahmenwerk für die Datenverwaltungsrichtlinien).
Schritt 4. Datenverarbeitung organisieren. Wählen Sie Datenverarbeitungswerkzeuge und -frameworks für die Datentransformation, -reinigung und -analyse. Mit deren Hilfe können Sie einen reibungslosen Prozess der Big Data-Analytik sicherstellen. Häufig verwendete Frameworks sind Apache Spark, Apache Hadoop und serverlose Cloud-basierte Dienste.
Schritt 5. Stellen Sie eine ausreichende Sicherheit sicher. Sicherheitsmaßnahmen wie Verschlüsselung und regelmäßige Überwachung sind entscheidend, um Ihren Data Lake vor unbefugtem Zugriff und böswilligen Angriffen zu schützen. Zum Beispiel bieten die AWS-Funktionen zur Verwaltung von Data Lakes Zugriffskontrolllisten und Zugriffshistorien, um Sie über alle Aktivitäten in Ihrem Data Lake auf dem Laufenden zu halten.
Schritt 6. Effiziente Datenkatalogisierung und -erforschung ermöglichen. Die Erstellung eines Datenkatalogs erleichtert Wissenschaftlern und Ingenieuren in der Datenanalyse die Abfrage und Analyse der Daten in Ihrem Data Lake. Sie sollten außerdem die Einrichtung von Metadatenmanagementverfahren in Betracht ziehen, um relevante Informationen zu Ihren Datensätzen zu speichern.
Schlussfolgerungen
Data Lakes sind eine ideale Lösung zur Speicherung, Verwaltung, Analyse und Auswertung umfangreicher Datenbestände, die strukturierte, unstrukturierte und semi-strukturiere Datenformate kombinieren. Doch ihre beispiellose Flexibilität ist gleichzeitig auch der Hauptgrund dafür, dass die Verwaltung von Data Lakes langfristig recht komplex sein kann.
Wenn ein Data Lake für Sie noch ein neues Konzept ist, können die oben genannten Empfehlungen hilfreich sein. Wenn Sie jedoch die Situation mit einem bestehenden Data Lake verbessern möchten, der nicht mehr Ihren Anforderungen entspricht, sollten Sie eine Beratung bei uns in Erwägung ziehen. Datenengineering-Unternehmen Um alle Engpässe zu identifizieren und entsprechende Lösungen zu entwickeln.
Wir helfen Ihnen gerne dabei, Ihre Datenumgebung gründlich auf eine effiziente Implementierung eines Data Lakes vorzubereiten und eine individuelle und moderne Data Lake-Lösung zu entwerfen, die Ihren spezifischen Geschäftsbedürfnissen und -anforderungen entspricht.
FAQ
Ist Cloud-Speicher für ein Data-Lake notwendig?
Technisch gesehen muss man sein Data Lake nicht in der Cloud betreiben, doch Cloud-basierte Implementierungen bieten eine Reihe von Vorteilen gegenüber lokalen Speicheranlagen. Dazu gehören die Möglichkeit, Daten auf Abruf zu skalieren, unbegrenzte Skalierbarkeit, Kosteneffizienz und die Integration mit cloudbasierten KI-/ML- und anderen Diensten.
Wie lange dauert die Implementierung eines Data Lakes?
Die Implementierungskomplexität hängt von mehreren Faktoren ab, wie z. B. der Anzahl der Datenquellen, der Vielfalt und der Größe der Daten, sowie den Sicherheits- und Complianceanforderungen. Ihre Datenreife und der Status Ihrer aktuellen Dateninfrastruktur spielen ebenfalls eine Rolle. Nehmen Sie gerne Kontakt mit unseren Experten auf, um zu besprechen, wie schnell wir Ihr Data Lake in Betrieb nehmen können.
Was ist der Unterschied zwischen einem Data Lake und einem Warehouse?
In bestimmten Szenarien ist ein Data Lake besser als ein Data Warehouse, da es mehr Flexibilität und Skalierbarkeit für die Speicherung und Analyse verschiedener Datentypen bietet, einschließlich strukturierten und unstrukturierten Daten. Im Gegensatz zu Data Warehouses können Data Lakes große Mengen an Rohdaten verarbeiten, ohne dass eine Vorab-Datenmodellierung und Schema-Design erforderlich ist. Dadurch können Organisationen Daten aus verschiedenen Quellen sammeln und speichern und später entscheiden, wie sie diese strukturieren und analysieren sollen.
Kann es für kleine Unternehmen von einem Data Lake profitieren?
Ja. Es ist ein weit verbreitetes Missverständnis, dass Data Lakes nur für große Unternehmen geeignet sind. Diese Datenrepositories können auch für kleine und mittlere Unternehmen von Vorteil sein, ihre Implementierung sollte jedoch den spezifischen Daten- und Analyselücken der Organisation entsprechen und die verfügbaren Rechenressourcen berücksichtigen.
Mit welchen Data-Lake-Services haben Sie die meisten Erfahrung?
Wir bieten Data-Lake-Services an, um Unternehmen dabei zu helfen, das Potenzial ihrer Big Data zu nutzen, Echtzeitanalysen zu ermöglichen und Datensilos zu überwinden. Was die verwendeten Technologien betrifft, arbeiten wir mit Amazon S3, Azure Data Lake Storage, Google Cloud Storage und Snowflake Data Lake zusammen. Wir verwenden außerdem Apache Kafka/AWS Kinesis für Echtzeit-Streaming und Apache Flume und AWS Glue für Batch-Injektionen.
Ist ein Data Lake für kleine und mittelständische Unternehmen geeignet?
Es hängt von dem Datenbestand ab, mit dem das Unternehmen arbeitet. Unternehmen, die auf Daten setzen, wie beispielsweise Start-ups in der KI/ML-Branche, können beispielsweise die Vorteile von Data Lakes wie Datenexploration und Forschungsfunktionen nutzen. Sie können auch ein Data Lake implementieren, wenn Sie Big Data Analytics für die Echtzeit-Betrugserkennung oder die Massenpersonalisierung implementieren möchten.
Über den Autor