In den letzten Jahren haben wir immer wieder das gleiche Muster beobachtet. integrierter Projekt kommen öfter wieder. Die Anfragen, die uns die Kunden zukommen lassen, lauten so:
“Wir brauchen eine Kamera, die Insekten zählt, ohne dass Videos irgendwohin gesendet werden müssen.”
“Wir brauchen einen Sensor am Motor, der uns warnt, wenn sich die Vibrationsmuster ändern.”
“Wir müssen abnormalen Geräuschen in Maschinen auf die Spur kommen, selbst wenn die Verbindungsqualität unzuverlässig ist.”
Verschiedene Branchen, unterschiedliche Geräte. Aber alle diese Anforderungen haben eine einzige Sache gemeinsam: die Ausführung von ML-Modellen direkt auf Hardware mit geringen Rechenressourcen.
Genau darum geht es bei tinyML für Edge-IoT.
In diesem Artikel gehen wir auf die Frage ein, warum der Ansatz von TinyML immer beliebter wird und was für Voraussetzungen erforderlich sind, um TinyML-Systeme in der Produktion zu entwickeln.
TL;DR: TinyML für ultrakurze AI-Aufgaben
Edge AI, tinyML und die Effizienz, die sie mit sich bringt
Edge AI/ML bedeutet, Machine-Learning-Modelle direkt auf Geräten (Kameras, Sensoren oder Maschinen) zu betreiben, anstatt Rohdaten in die Cloud zu senden. TinyML befindet sich in diesem Bereich. Es handelt sich um die Verwendung von Algorithmen, die auf einem kleinen Computer ausgeführt werden können. ML-Modelle auf ressourcenbeschränkter Hardware ausführen, Wie Mikrocontroller (MCU) und Low-Power- IoT Sensoren.
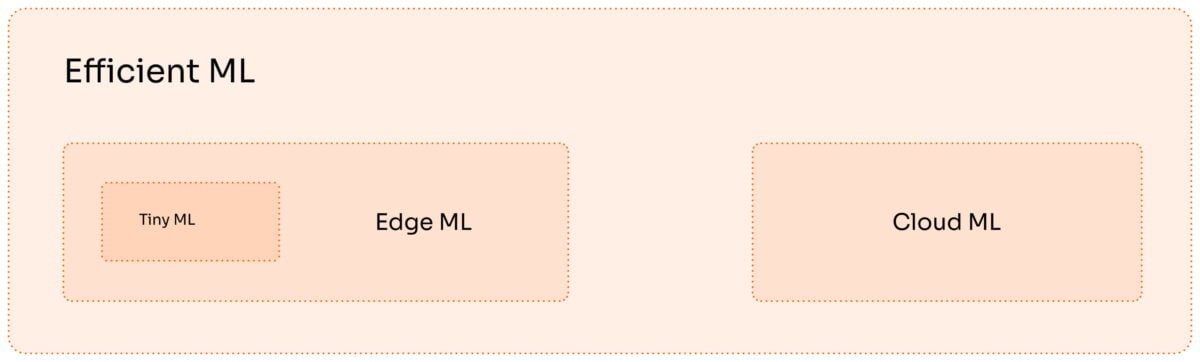
Da Cloud- und leistungsstarke Edge-Computing-Systeme ist immer teurer geworden, Die Verknüpfung von maschineller Intelligenz mit kleinen Geräten macht sie wirtschaftlich attraktiv. tinyML bietet noch mehr Effizienz hinsichtlich Kosten, Leistung und Latenzzeit.
Anstatt Daten in die Cloud zu streamen, verarbeitet ein TinyML-Modell sie lokal auf dem Gerät, in der Nähe des Sensors, oft mit nur wenige hundert Kilobyte Speicher verfügbar. Dies reduziert den Energieverbrauch, vermeidet ständige Verbindungen und ermöglicht viel schnellere Reaktionen. Da die Daten nicht vom Gerät ausgetauscht werden müssen, kann dieser Ansatz auch die Privatsphäre in sensiblen Umgebungen verbessern.
“Vor nicht allzu langer Zeit musste die meisten ML-Verarbeitung im Cloud-Bereich stattfinden, da die Edge-Geräte einfach nicht über die nötige Leistung verfügten. Mit Edge AI und TinyML können wir nun nützliche, qualitativ hochwertige Logik direkt auf dem Gerät ausführen – und zwar schnell.”
– Mykhailo Maidan, CTO bei Yalantis
TinyML-Anwendungen sind am nützlichsten, wenn Entscheidungen sofort und vor Ort getroffen werden müssen und wenn die Abhängigkeit von Gateways oder Cloud-Rundenverläufen zu langsam, teuer oder unzuverlässig wäre.
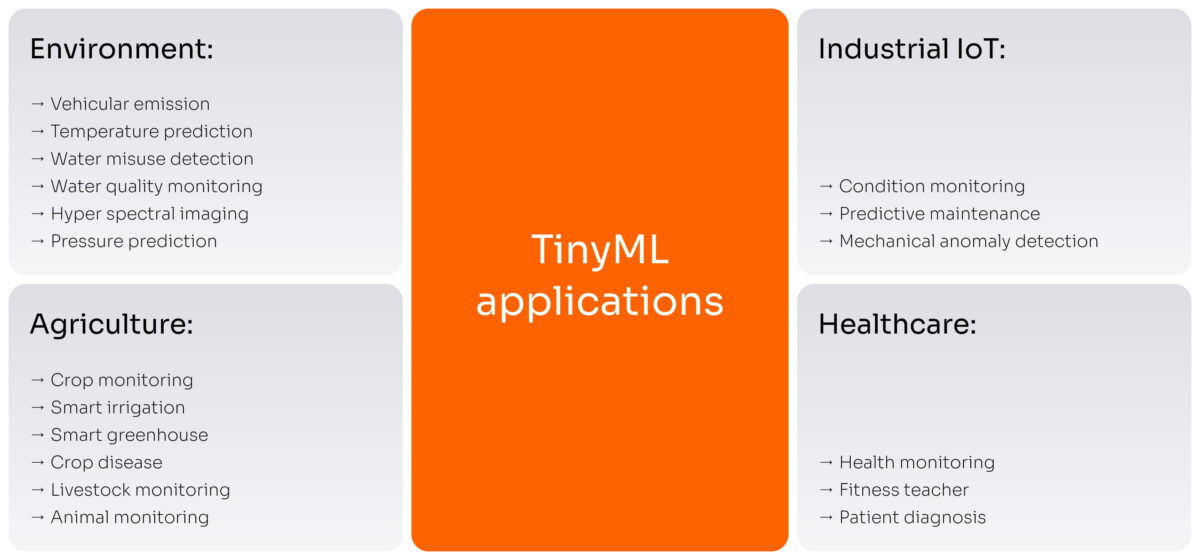
In der Praxis umfasst dies Anwendungsfälle wie:
- IoT-Sensoren erkennen frühe Anzeichen von Ausfall der Geräte für die vorausschauende Instandhaltung
- Umwelt- und Landwirtschaftssensoren, die die Bedingungen direkt im Feld analysieren
- Tragebare Geräte zur Überwachung von Signalen in der Gesundheitsversorgung
- Kameras mit geringer Leistung melden lokale Aktivitäten oder Änderungen
Im Rahmen von Industrie-IoT, Gesundheitswesen, Landwirtschaft, Smart Home und Umweltüberwachung ermöglicht TinyML die Integration grundlegender Intelligenz in Geräte, die zuvor auf einfache regelsbasierte Logik beschränkt waren – ohne die zusätzlichen Kosten einer Cloud-Infrastruktur.
Engineering-Herausforderungen, die mit TinyML einhergehen
Die Effizienz von TinyML-Embedded-Systemen hat einen Preis. Die Verwendung von tinyML für IoT-Geräte und andere Geräte mit geringer Leistungsaufnahme bedeutet, unter strengen physikalischen Einschränkungen zu arbeiten:
- Begrenzte Flash-Speicherkapazität: nur Zehntausende KB bis wenige MB
- Minimale RAM-Speichergröße: Kilobyte statt Gigabyte
- Begrenzte Rechenleistung: Ab 100 bis 1000 MHz ohne GPU.
- Kleine Leistungsbudget: Mikrowatt oder Milliwatt. Geräte sind oft batteriebetrieben oder benötigen Energie aus der Umgebung.
- Begrenzte oder keine Systemsoftwareunterstützung: Häufig ohne Betriebssystem
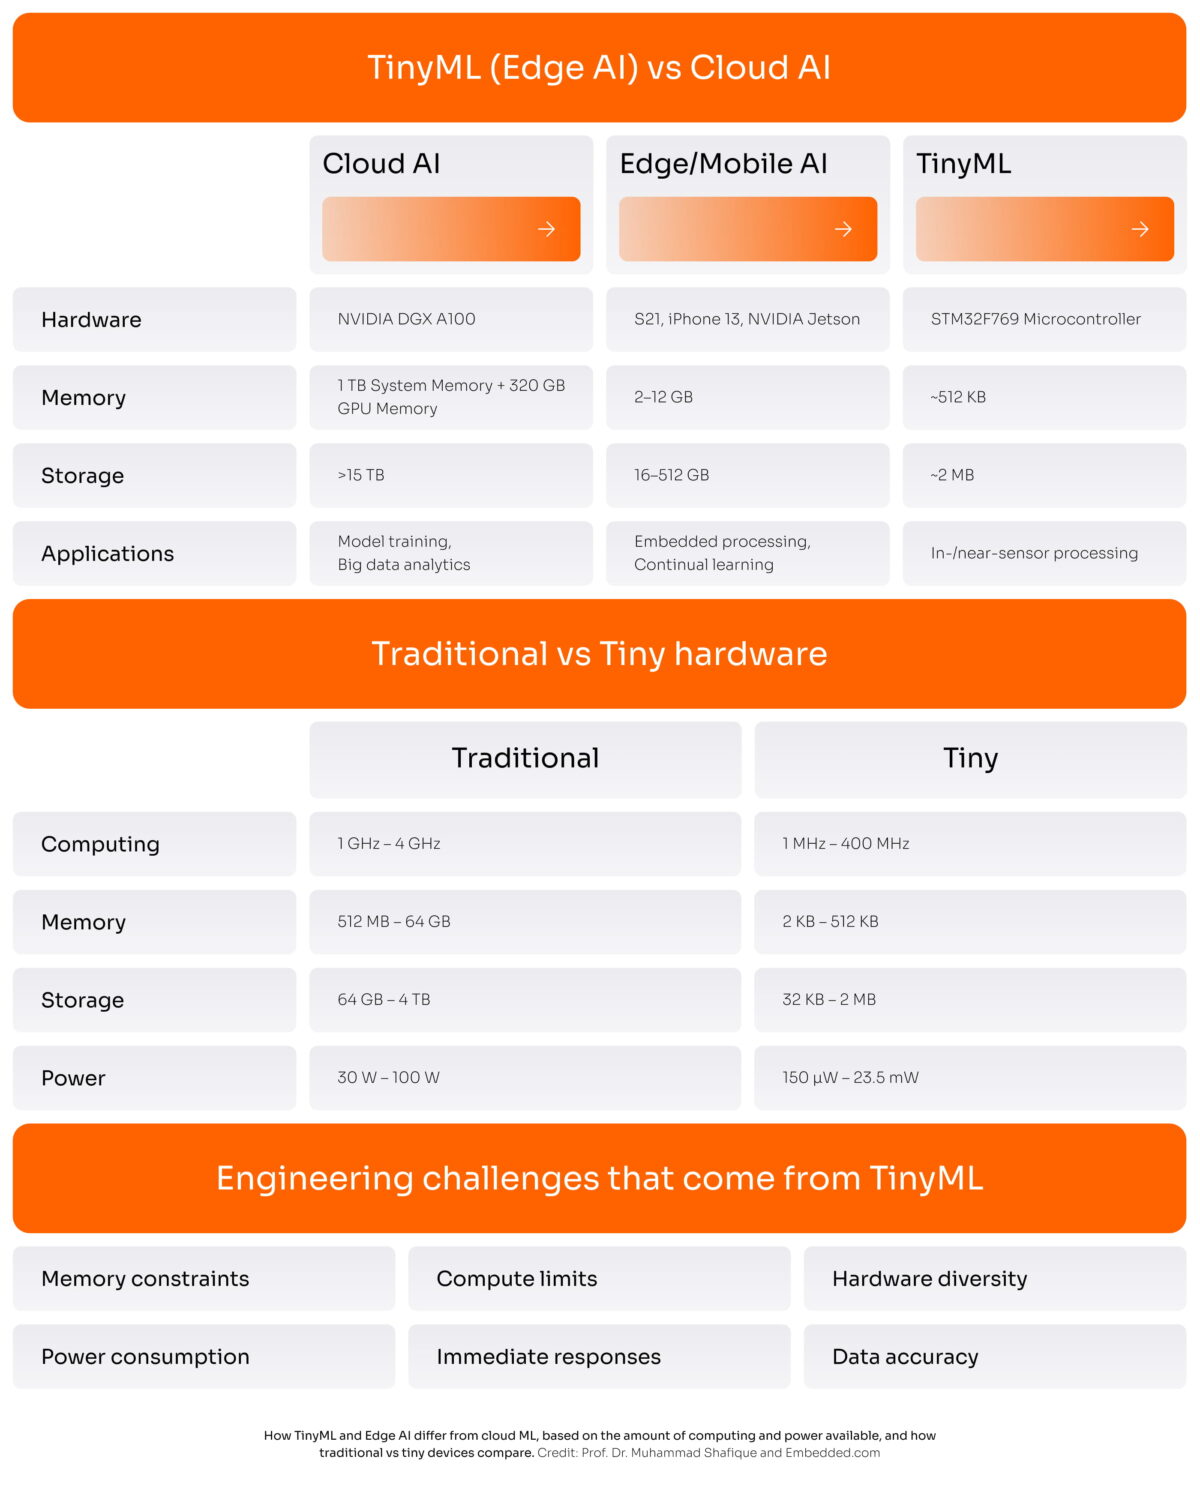
Diese Einschränkungen sind keine Ausnahmefälle, sondern die Grundlage von TinyML. Deshalb müssen bei TinyML-Projekten ständige technische Kompromisse eingehalten werden. Man muss die Balance zwischen Genauigkeit, Latenzzeit, Stromverbrauch und Zuverlässigkeit auf Hardware finden, die nie für intensive Berechnungen entwickelt wurde.
Welche technischen Herausforderungen entstehen durch die Einschränkungen von Mikrocontrollers und IoT-Geräten:
- Modelle müssen so gestaltet sein, dass die Speicherleistung zuerst berücksichtigt wird
- Der Stromverbrauch wird zu einem Produktanforderung
- Berechnungsbegrenzungen beschränken die Modellkomplexität
- Verhalten in Echtzeit muss vorhersehbar sein
- Die Vielfalt der Hardware erschwert die Implementierung
- Die Datenqualität wird entscheidend
Modelle müssen so gestaltet sein, dass die Speicherleistung zuerst berücksichtigt wird
Da nur wenige Kilobyte RAM zur Verfügung stehen, ist die Modellgröße eine harten Einschränkung, die Ingenieure nicht später optimieren können. Wenn ein Modell nicht in die Speicherkapazität des Geräts passt, läuft es einfach nicht. Ingenieure müssen nicht nur das Modell selbst berücksichtigen, sondern auch die Speicherressourcen, die es während der Auswertung benötigt. Dazu gehören temporäre Daten und Zwischenergebnisse.
Dies ist am deutlichsten bei Anwendungsfällen wie der vorausschauenden Instandhaltung zu beobachten. Ein Beispiel: batteriebetriebene Vibrationssensoren, die abnormale Muster lokal erkennen. Das TinyML-Modell muss vollständig in die Speicher des MCU passen, ohne Platz für Firmware und Sensorlogik zu verlassen. Andernfalls führt die Schlussfolgerung vor Ort zu einem Fehler oder das System wird instabil. Dies schließt Standardmodellarchitekturen aus und zwingt Teams dazu, Modelle speziell für die jeweilige Hardware zu vereinfachen oder neu zu gestalten.
Der Stromverbrauch wird zu einem Produktanforderung
In TinyML-Anwendungen setzen die Leistungsanforderungen harte Grenzen für die Möglichkeiten des Geräts. Es wird häufig erwartet, dass TinyML-Geräte monatelang oder jahrelang ohne Wartung funktionieren. Wenn das Gerät seine erwartete Lebensdauer nicht erreicht, ist die ML-Funktion nicht mehr sinnvoll, unabhängig von der Modellleistung.
Ein Beispiel: Fernüberwachte Sensoren, die Ereignisse wie Bewegung, Geräusche oder Grenzwerte klassifizieren und nur Warnmeldungen senden. Da diese Geräte mit kleinen Batterien oder durch Energieerzeugung arbeiten, müssen die Teams die Häufigkeit der Auswertungen genau begrenzen, die Modelle vereinfachen oder das System neu gestalten, sodass die ML nur dann ausgelöst wird, wenn dies erforderlich ist. Andernfalls erfüllt das Gerät seine erwartete Lebensdauer im Feld nicht.
Berechnungsbegrenzungen beschränken die Modellkomplexität
Mikrocontroller bieten nur einen Bruchteil der Rechenleistung, die auf typischen Edge-AI-Geräten verfügbar ist. Dies bestimmt, welche Modellarchitekturen überhaupt sinnvoll sind, und nicht nur, wie schnell Modelle laufen.
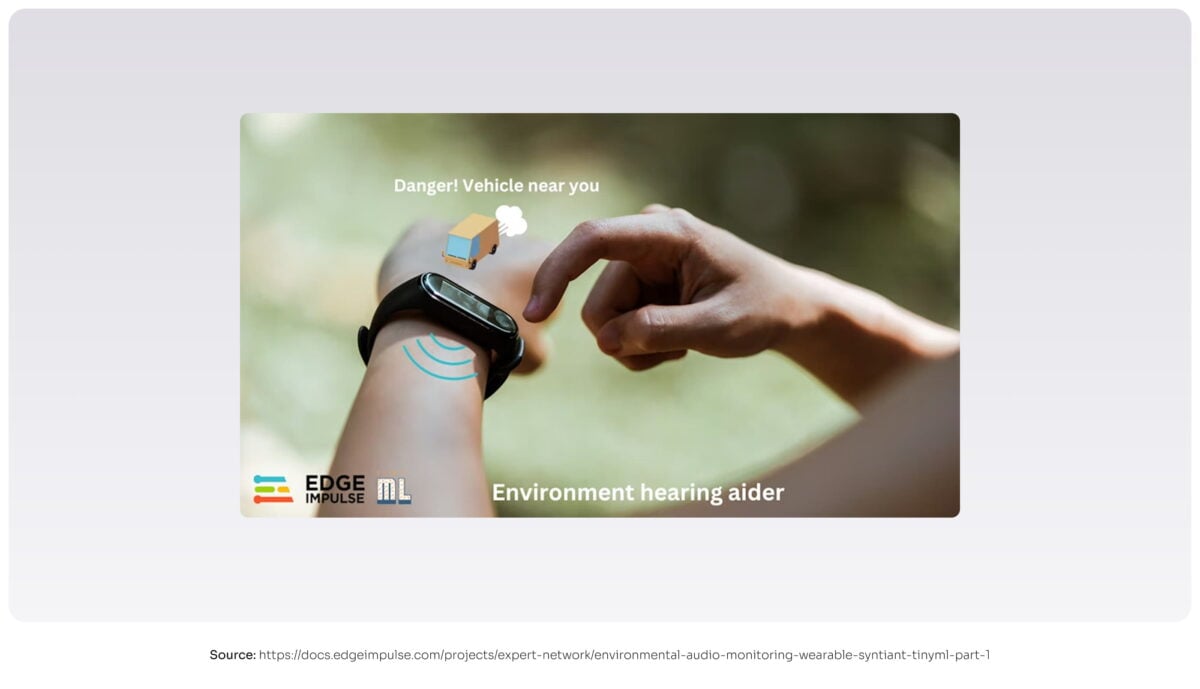
Wir sehen dies am häufigsten in Tragebare Geräte, Beispielsweise solche, die Audio- oder Umweltsignale in Echtzeit analysieren, wie Hörgeräte. Diese Systeme müssen Geräusche oder Ereignisse sofort erkennen, während sie auf Hardware mit extrem begrenzter Rechenleistung und strengen Stromlimits arbeiten. In diesem Kontext sind standardmäßige Deep-Modelle unpraktikabel.
Stattdessen setzen die Teams auf leichte Modellarchitekturen, vereinfachte Verarbeitungspipeline und sorgfältige Feature-Extraktion, um die Auswertung schnell und vorhersehbar zu halten. Andernfalls wird die Erkennung für den realen Einsatz zu langsam oder unzuverlässig, was dem Zweck intelligenter Geräte im Tragen auf dem Körper entgegensteht.
Verhalten in Echtzeit muss vorhersehbar sein
Viele TinyML-Systeme arbeiten in Echtzeit-Umgebungen, in denen verzögerte Antworten nicht akzeptabel sind. Dies ist beispielsweise entscheidend für Sicherheitsmodule in der Nähe von Industrieanlagen, die die Anwesenheit in Sperrzonen erkennen. Alarme müssen sofort und zuverlässig auf dem Gerät selbst ausgelöst werden. Dies zwingt die Teams, Modelle und Pipelines mit eng festgelegten Ausführungszeiten zu entwerfen, die Eingabegrößen steuern und die Zeitgenauigkeit direkt auf der Zielhardware zu validieren. Wenn die Zeitgenauigkeit der Ausrechnungen variiert, wird das System in der realen Betriebsumgebung unsicher.
Die Vielfalt der Hardware erschwert die Implementierung
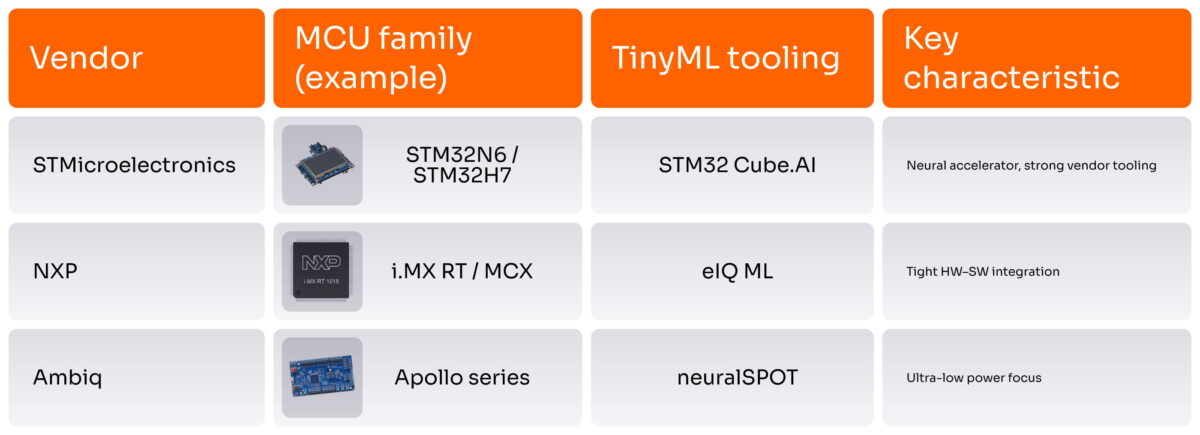
TinyML-Lösungen setzen oft auf vendor-spezifische Stack-Lösungen wie STM32 mit Cube.AI, NXP-MCU mit eIQ oder ähnliche KI-orientierte Plattformen. Obwohl diese Ökosysteme ML auf dem Gerät ermöglichen, haben sie jeweils ihre eigenen Toolketten, Modellkonvertierungsabläufe und Laufzeitbeschränkungen. Ein Modell, das auf einer Plattform effizient läuft, erfordert möglicherweise Anpassungen auf einer anderen Plattform.
Dies wird besonders deutlich in Produktionsumgebungen wie der Einsatz von Predictive Maintenance über mehrere Standorte hinweg. Wenn verschiedene Fabriken unterschiedliche MCU-Familien verwenden, die für TinyML konzipiert sind, müssen Teams oft die Modelle neu kalibrieren, die Speicherzuweisung anpassen und die Firmware-Integration für jedes Ziel anpassen. Im Laufe der Zeit nimmt die Bereitstellungs- und Wartungsaufwand mit jeder unterstützten Hardwareplattform zu.
Die Datenqualität wird noch wichtiger
Wenn das reale Leben sich von den Trainingsdaten sogar nur ein wenig unterscheidet – beispielsweise, weil ein Sensor anders montiert ist oder die Wetterverhältnisse sich ändern – können ML-Modelle beginnen, falsche Vorhersagen zu treffen.
Standardmodelle können diese Variationen bewältigen. Kleinere ML-Modelle können dies nicht.
Das ist oft der Fall bei landwirtschaftlichen Sensoren, die im Feld eingesetzt werden, um Aktivitäten oder Bedingungen zu überwachen. Modelle, die auf sauberen Labordaten trainiert wurden, versagen oft, sobald sie mit Wetter-, Gelände- und Installationsunterschieden konfrontiert werden. Daher müssen Teams Daten aus realen Einsatzsituationen sammeln, Modelle für spezifische Bedingungen neu trainieren und die Leistung auf der Zielhardware validieren. Andernfalls sinkt die Genauigkeit in der Produktion stark.
Was verlangt TinyML also von der Engineering-Ansatz?
Bei TinyML sind Entscheidungen in Bezug auf Speicher, Leistung, Rechenleistung und Daten eng miteinander verknüpft, und die Optimierung einer dieser Parameter geht oftmals auf Kosten der anderen.
In der Praxis bedeutet dies, dass erfolgreiche TinyML-Projekte weniger von einzelnen Techniken abhängen und vielmehr davon, wie das Projekt von Anfang an angegangen wird.
Auf Grundlage unserer Erfahrung im Entwickeln von produktionsfähigen Firmware-Komponenten Und bei Edge-ML-Systemen machen ein paar Prinzipien einen großen Unterschied.
Wie wir die Annäherung an TinyML-Projekte empfehlen
Im vergangenen Jahr haben wir einen kontinuierlichen Anstieg der Anzahl der TinyML-Projekte beobachtet. Folgende Grundsätze gelten dabei als maßgeblich.
Erhalten Sie Trainingsdaten aus einer realen Umgebung
Bevor Sie TinyML-Modelle oder -Frameworks auswählen, müssen Sie so viel Daten aus der realen Umgebung sammeln wie möglich. Wenn Ihr System beispielsweise dazu bestimmt ist, Insekten mithilfe einer Kamera zu erkennen oder zu zählen, Erhalten Sie Trainingsdaten von genau dieser Kamera und der entsprechenden Bereitstellungsanordnung, Diese Daten, einschließlich ihrer Montageposition, der Entfernung zum Ziel, der Lichtverhältnisse und des typischen Hintergrunds, weisen oft nicht die Lichtverhältnisse, die Winkel und den Hintergrundrauschen in der realen Umgebung wieder. Dies gilt insbesondere für Bilder, die in kontrollierten Bedingungen oder aus öffentlichen Datensätzen gesammelt wurden.
Verwenden Sie keine Allzweck-Hardware
Die Leistung, die Kosten und die Machbarkeit von TinyML hängen stark von der Hardwareauswahl ab. Allzweck-MCU-Module sind oft ineffizient, während KI-fähige Chips mit Accelerators immer häufiger verfügbar sind – und wesentlich besser für TinyML-Anwendungen geeignet sind.
Da die Nutzung von ML auf Low-Power-Geräten wächst, entwickeln immer mehr Chiphersteller Mikrokontroller, die speziell für ML auf dem Gerät konzipiert sind. Ein Beispiel hierfür ist STMicroelectronics, das das STM32N6-Chip mit einem dedizierten neuronalen Beschleuniger eingeführt hat, um TinyML-Modelle direkt auf dem Gerät auszuführen. Diese Chips können ML-Aufgaben in der Hardware ausführen und so die Auswertung schneller, energieeffizienter und kostengünstiger machen.
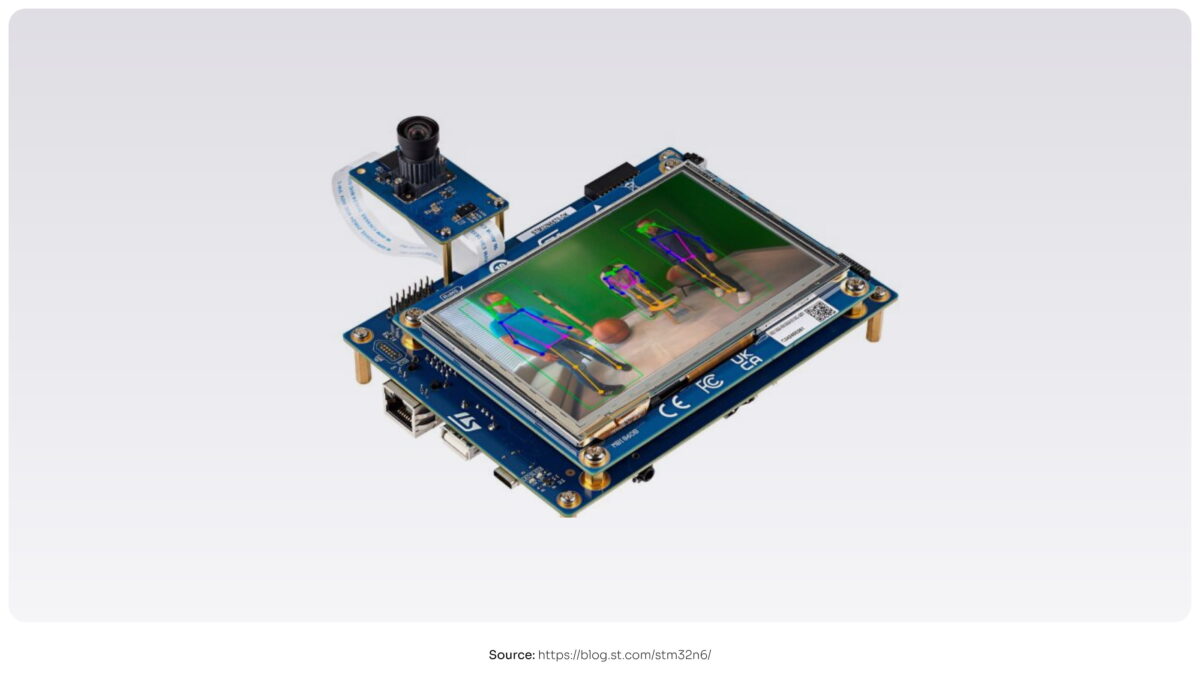
“Mehr und mehr Chip-Hersteller, wie STM und NXP, fügen dedizierte Hardware-Beschleuniger für ML hinzu. Sie sind günstiger, schneller und effizienter, und das sollten die Teams nutzen.”
– Mykhailo Maidan, CTO bei Yalantis
Vertrauen Sie auf bewährte Werkzeuge
Bei Geräten mit geringer Leistung führen Instabilität, mangelnde Dokumentation oder eine schwache Hardware-Integration schnell zu Problemen bei der Bereitstellung und Wartung. Deshalb empfehlen wir Teams, Werkzeuge zu wählen, die gut unterstützt, vorhersehbar und eng an die Zielhardware angepasst sind.
In der Praxis bedeutet dies, dass man ein einzelnes “allgemeines” TinyML-Framework meidet und stattdessen Werkzeuge auswählt, die auf der Zielhardware und der Art der zu implementierenden Workloads basieren.
-
Beginnen Sie mit benutzerdefinierten Tools des Herstellers für die Bereitstellung
Für eingebettete Systeme mit TinyML empfehlen wir, mit den von den jeweiligen Herstellern bereitgestellten Toolchains zu beginnen.
Beispielsweise: bei der Arbeit mit Hardware auf STM32-Basis, Wir verwenden und empfehlen die STMicroelectronics STM32Cube.AI. Plattformen von NXP, Wir setzen auf die eIQ® AI Software-Entwicklungsumgebung.
Diese Toolchains wurden speziell für ihre Chips entwickelt. Sie erleichtern die Integration von Modellen in die Speicherarchitektur, die Nutzung verfügbarer Hardware-Beschleuniger sowie die Erfüllung von Leistungs- und Latenzgrenzen. Nach unserer Erfahrung reduziert dies das Risiko im Vergleich zur Bereitstellung von TinyML-Modellen allein über ein hardwareunabhängiges ML-Framework.
-
Verwenden Sie Allzweck-Frameworks für gut unterstützte Aufgaben
Wir verwenden oft TensorFlow Lite (Google’s Open-Source-ML-Framework), insbesondere für Bildklassifizierungs- und Objekterkennungsaufgaben, wo das Ökosystem reif und gut unterstützt ist. TFLite bietet eine solide Grundlage für das Training, die Modelloptimierung und die Konvertierung und funktioniert gut bei visionstechnischen Workloads auf eingeschränkten Geräten.
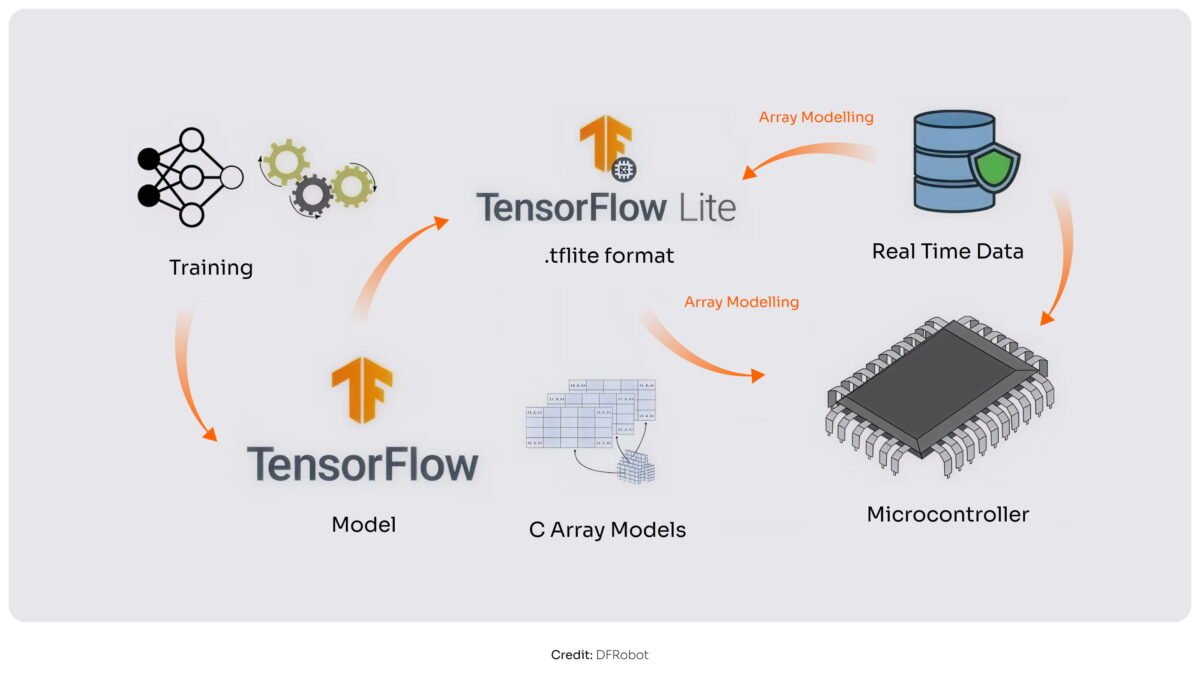
In der Praxis wird TFLite verwendet, um das Modell zu trainieren, zu konvertieren und zu verarbeiten; der letzte Schritt, das Modell auf ein Gerät zu implementieren, wird jedoch von den Tools des Chipherstellers durchgeführt. Die meisten Produktionsimplementierungen von TinyML basieren heute auf Mikrocontrollern mit dem Arm Cortex-M-Prozessor. Anbieter wie STMicroelectronics und NXP bieten Werkzeuge an, mit denen TFLite-Modelle in ihre Hardware-Ökosysteme integriert werden können.
Andere leichte Bibliotheken wie uTensor, kann auch rentabel sein. Es wurde für die schnelle Prototyping- und Forschungsarbeit entwickelt und ergänzt die eher produktionsorientierte TFLite.
- Verwenden Sie End-to-End-ML-Plattformen, um kleine ML-Anwendungsfälle zu validieren
Die Nutzung von Plattformen wie Edge Impulse kann in den frühen Phasen von TinyML-Projekten sehr effektiv sein. Sie vereinfachen die Datenerhebung von Sensoren und werden oft empfohlen, wenn Teams schnell Daten sammeln, Modelle prototypen und prüfen müssen, ob ein TinyML-Ansatz überhaupt machbar ist. Vor der Markteinführung müssen Sie jedoch noch die Zuverlässigkeit der resultierenden Modelle auf die jeweilige Hardware prüfen., Erfüllt die Leistungs- und Zeitstimmungsanforderungen und kann über die Lebensdauer des Geräts gewartet und aktualisiert werden:
- Passen die generierten Modelle in Flash und RAM?
- Läuft die Abbildung innerhalb der Zeitlimits des tatsächlichen MCU?
- Kann das Gerät seine erwartete Lebensdauer dennoch erreichen?
Denken Sie über selektive Einsatzfälle nach
Letztendlich ist TinyML eine Die geeignetste Vorgehensweise für spezifische, kritische Aufgaben. Es bietet den größten Mehrwert, wenn Entscheidungen lokal getroffen werden müssen. Zum Beispiel, wenn niedrige Latenzzeit, geringer Stromverbrauch oder offline-Betrieb unerlässlich sind. In vielen Fällen kombiniert die effektivste Konfiguration traditionelle Embedded-Logik mit einer kleinen, gut beschriebenen ML-Komponente. Dadurch bleiben die Systeme einfacher, zuverlässiger und einfacher zu warten.
TinyML fungiert oft als Katalysator. Ein kleines ML-Modell kann Ereignisse filtern, relevante Muster erkennen oder nur dann eine intensivere Verarbeitung auslösen, wenn dies erforderlich ist, wodurch unnötige Rechenaufwand und Datenübertragungen reduziert werden.
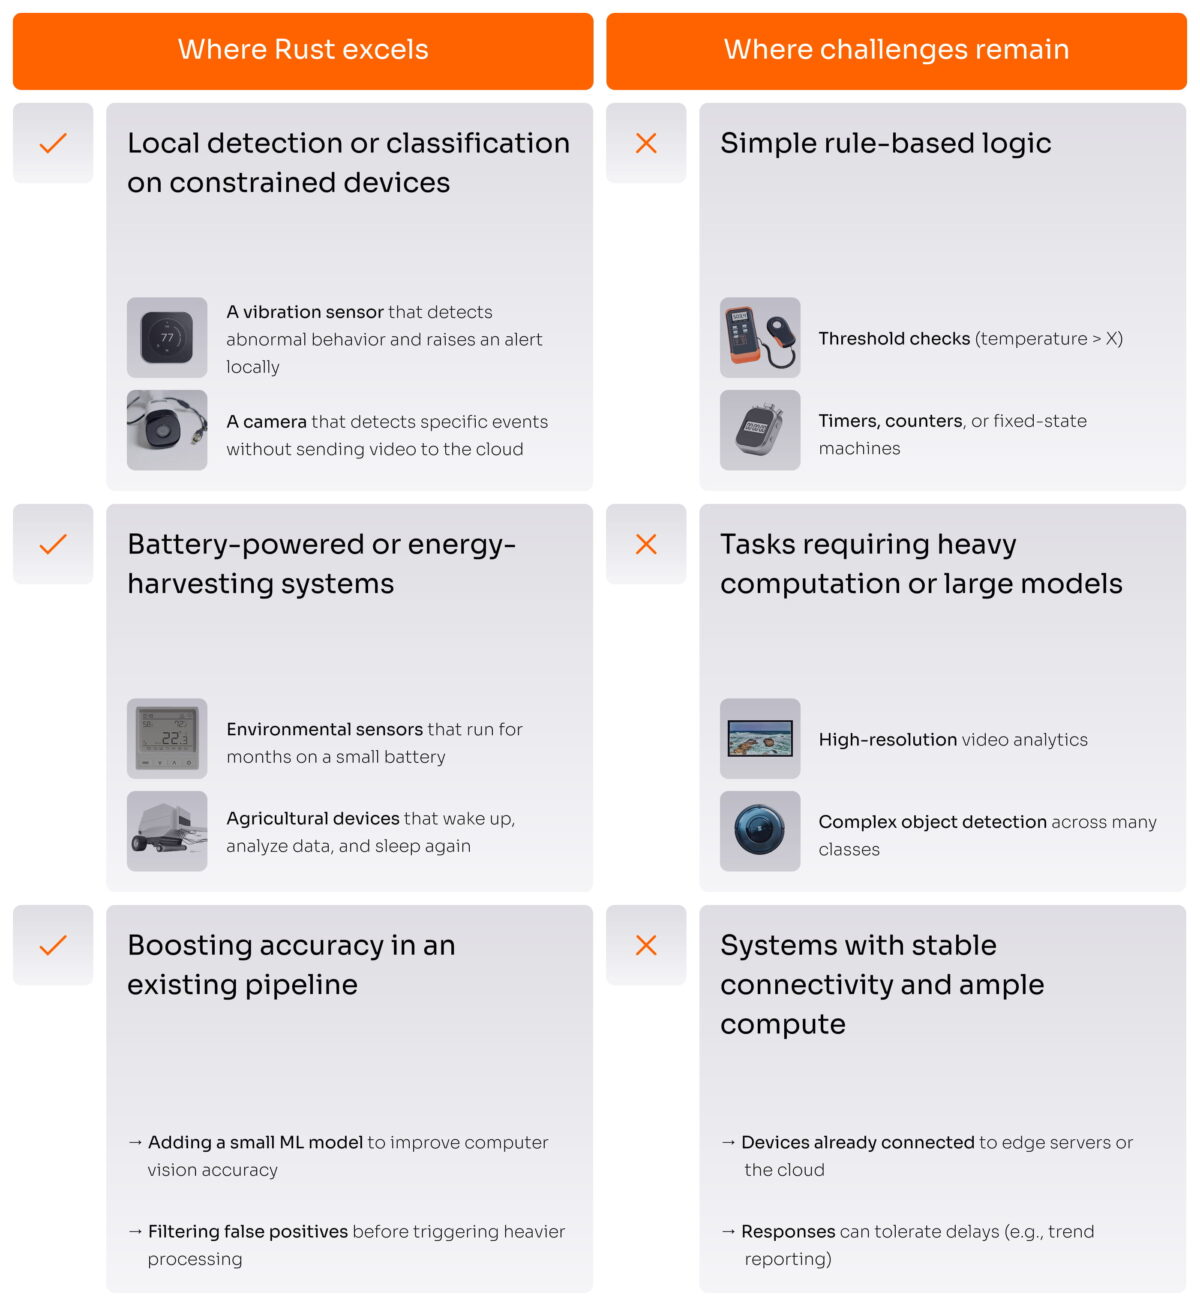
Wir sehen oft, dass die selektive Nutzung von TinyML sich positiv auswirkt. Computer Vision Projekte. Das Hinzufügen eines leichten ML-Modells zu einem bestehenden Vision-Pipeline kann die Genauigkeit verbessern, ohne das gesamte System neu zu gestalten. In einigen Fällen konnten wir beobachten, dass gezielte ML-Verbesserungen die Erkennungsgenauigkeit von rund 80% auf 90% oder mehr erhöhen – vorausgesetzt, das Modell wurde auf echten Daten trainiert und an die verfügbaren Hardware angepasst. Bei der Objekterkennung kann dies die Verwendung von Modellen wie YOLO beinhalten, jedoch nur, wenn die Hardware und die Einschränkungen dies zulassen.
Sind TinyML-Anwendungen für Sie interessant?
Denken Sie daran, ein kleines ML-Projekt zu starten, wenn die meisten dieser Punkte zutreffen:
- Das Gerät muss Entscheidungen lokal treffen, ohne auf die Cloud angewiesen zu sein.
- Die Latenz ist wichtig (die Antworten müssen sofort erfolgen)
- Das System arbeitet mit einer Batterie oder nutzt die Energie aus der Umgebung und muss den Stromverbrauch minimieren.
- Die Verbindungsqualität ist begrenzt, teuer oder unzuverlässig
- Sie müssen Ereignisse klassifizieren, erkennen oder filtern, anstatt alle Rohdaten zu verarbeiten.
- Sie verbessern oder erweitern eine bestehende Pipeline (z. B. indem Sie die Genauigkeit erhöhen oder falsche positive Ergebnisse reduzieren).
- Sie haben Zugang zu realen Daten aus dem tatsächlichen Gerät und der tatsächlichen Umgebung
Die Zukunft von Edge AI ist klein (und sie ist bereits da)
Wie sieht das aus? ML-Modelle können nun auf Sub-Milliwatt-Mikrocontrollern ausgeführt werden, was die KI von einer Cloud-basierten Funktion zu einer integrierten Funktion in Sensoren und alltäglichen Produkten macht.
Anstatt Rohdaten stromaufwärts zu senden, können Edge-Geräte Muster erkennen, Signale filtern und lokal reagieren. Dies ermöglicht schnelleren Reaktionszeit, geringeren Stromverbrauch und Systeme, die selbst ohne ständige Verbindung funktionieren können.
Bei Yalantis helfen wir unseren Kunden bereits dabei, diese Systeme zu entwickeln – indem wir Embedded Engineering, TinyML und Edge-AI kombinieren, um die richtigen Use Cases mit dem richtigen Hardware- und Tooling zu realisieren. Willst du mitmachen?
Über den Autor