Einmal, während eines Einführungsmeetings auf dem Gelände eines Kunden, beobachteten unsere Ingenieure, wie ein Wartungsteam drei Stunden damit verbrachte, ein perfekt funktionierendes Getriebe auseinanderzunehmen.
Die Wartungsplanung besagte, dass der Service bei 10.000 Betriebsstunden erfolgen sollte, also wurden die Schraubendreher ausgeholt. Zwei Techniker, $1.200 für Arbeitszeit und $800 für Ersatzteile, die nicht ersetzt werden mussten. Die Getriebeeinheit hatte noch gut 3.000 Betriebsstunden zu bieten.
In der Zwischenzeit war ein Fördermotor fünfzig Meter entfernt überhitzt und zeigte ungewöhnliche Vibrationsmuster, die jeder vernünftige Sensor hätte aufgegriffen. Zwei Tage später fiel dieser Motor katastrophal aus. Die Produktion blieb für achtzehn Stunden stillstehen.
Das passiert täglich in Anlagen in ganz Nordamerika und Europa. Wir verschwenden Geld, indem wir Komponenten austauschen, die noch funktionieren, während wir gleichzeitig die eigentlichen Probleme übersehen, die wirklich wichtig sind. Das Problem liegt nicht darin, dass die Instandhaltungsteams nicht geschickt oder engagiert sind. Das Problem liegt darin, dass wir sie zwingen, Entscheidungen zu treffen, ohne die notwendigen Informationen. Traditionelle Instandhaltung funktioniert blind, indem sie entweder auf festen Kalendern oder bei Krisen reagiert – beide ignorieren die Botschaften, die das Equipment selbst vermitteln möchte.
Vorhersagende Instandhaltungsprogramme bieten diese Alternative. Durch die Echtzeitüberwachung der Geräte-Zustandsüberwachung und die Nutzung von Daten zur Vorhersage von Ausfällen, bevor diese auftreten, können Unternehmen Reparaturen planen, wenn dies wirtschaftlich sinnvoll ist, anstatt wenn eine Krise dies erfordert. Die Beweislage für diesen Ansatz ist zunehmend überzeugend. Eine Studie des MIT, die Lastkraftwagenflotten überwacht hat, ergab, dass Prädiktive Instandhaltung verringerte die Gesamtkosten der Instandhaltung Jährlich zwischen $240 und $480 pro Fahrzeug, wodurch 85 Prozent aller erzielbaren Kosteneinsparungen durch eine bessere Entscheidungsfindung erzielt werden.
Dieser Artikel bietet einen praktischen Rahmen für den Start eines Predictive-Maintenance-Programms – von der ersten Evaluierung bis hin zur vollständigen Implementierung. Die Hinweise basieren auf realen Einsatzprojekten in Bereichen wie Fertigung, Logistik und Industrie, in denen predictive Ansätze reaktive Brandbekämpfung durch systematische, datengestützte Wartungsstrategien ersetzt haben.
Was ist ein Fleet Predictive Maintenance-Programm?
A Prädiktive Instandhaltung Das Programm nutzt die Echtzeitdaten der Geräte, um sich auf Entwicklungsstörungen zu konzentrieren und zu prognostizieren, wann Fehler auftreten. Im Gegensatz zur vorbeugenden Instandhaltung, die unabhängig von der tatsächlichen Geräteverfassung nach festen Zeitplänen durchgeführt wird, reagieren die vorausschauenden Programme auf die Daten, die über jedes einzelne Asset bekannt sind.
Das Kerngrundprinzip beinhaltet kontinuierliche Überwachung. Sensoren erfassen Vibrationen, Temperaturänderungen, Druckschwankungen, Ölqualität und Dutzende weiterer Parameter, die die Geräteleistung anzeigen. Wenn Messwerte außerhalb des normalen Betriebsbereichs liegen, signalisiert das System mögliche Probleme. Maschinelles Lernen-Modelle analysieren diese Muster, um die verbleibende Nutzungsdauer abzuschätzen und die optimale Interventionszeit zu empfehlen.
Stellen Sie sich eine Flotte von Lkw für die Zustellung vor. Traditionelle vorbeugende Instandhaltung Die Getriebeölwechselintervalle können je nach Bedarf bei 50.000 Meilen erfolgen. Ein vorausschauender Ansatz überwacht die Ölqualität direkt anhand von Sensoren, die Verschmutzung und Abnutzung erkennen. Wenn die Daten zeigen, dass das Öl über die akzeptablen Grenzwerte hinausverfallen ist, sendet das System eine Wartungserklärung aus. Der Lkw wird entsprechend der tatsächlichen Notwendigkeit gewartet, anstatt anhand von beliebig festgelegten Kilometerstand.
Kernkomponenten eines Predictive-Maintenance-Programms
Bevor wir uns eingehend mit dem aufgebauten Prozess der vorausschauenden Instandhaltung befassen, sollten wir deren notwendigen Komponenten verstehen und natürlich den tatsächlichen Status (oder die Existenz) dieser Komponenten überprüfen, bevor ein Pilotprogramm gestartet wird.
Datenakkumulationsinfrastruktur
Die Grundlage jeder Prognosesoftware erfordert Sensoren, die Daten über den Zustand der Geräte erfassen. Moderne industrielle Anlagen sind oft mit integrierten Sensoren ausgestattet, die Dutzende Parameter überwachen. Bei älteren Anlagen bietet die Nachrüstung mit externen Sensoren die notwendigen Datenströme. Das Schlüsselprinzip besteht darin, zu identifizieren, welche Messungen tatsächlich Fehler vorhersagen, anstatt lediglich Störungen zu erzeugen.
IoT und Sensornetzwerke
Das Industrielle Internet der Dinge hat die Kosten und Komplexität der Sensorinstallationen drastisch reduziert. Drahtlose Sensoren eliminieren die Notwendigkeit teurer Verkabelung. Akkubetriebene Geräte können jahrelang ohne Wartung funktionieren. Standardisierte Kommunikationsprotokolle ermöglichen die Kombination von Sensoren verschiedener Hersteller. Diese Zugänglichkeit hat es möglich gemacht, umfassende Geräteüberwachung auch für mittelständische Betriebe wirtschaftlich machbar zu machen.
Analytische Plattform
Rohsensordaten bedeuten nichts ohne Interpretation. Die Analyse-Schicht verarbeitet den Streaming-Datenstrom, identifiziert Anomalien und generiert Vorhersagen für Ausfälle. Dies kombiniert typischerweise statistische Analysen mit maschinellen Lernmodellen, die darauf trainiert sind, Muster zu erkennen, die vor bestimmten Ausfallmodi auftreten.
Cloud versus Edge Computing
Die Verarbeitung von Sensordaten erfordert Rechenressourcen. Cloud-Plattformen bieten unbegrenzte Skalierbarkeit und zentralisierten Management, sind jedoch von einer zuverlässigen Konnektivität abhängig und führen zu Latenzzeiten. Edge-Computing-Geräte verarbeiten Daten lokal an oder in der Nähe der Geräte, was eine schnellere Reaktionszeit ermöglicht und die Bandbreitenauslastung reduziert. Hybridarchitekturen bieten oft den optimalsten Ansatz, wobei Edge-Geräte die Echtzeitüberwachung und sofortige Warnmeldungen verarbeiten, während Cloud-Systeme tiefergehende Analysen durchführen und die gesamte Flotte optimieren.
Integrationssysteme
Prädiktive Erkenntnisse bieten Wert nur dann, wenn sie mit bestehenden Workflows verbunden werden. Wartungsauftragssysteme, Ersatzteilbestandslisten und Zeitplanungstools müssen automatisch Benachrichtigungen und Empfehlungen erhalten. Techniker benötigen Prognosen in Formaten, die ihre täglichen Entscheidungen unterstützen und nicht die Notwendigkeit erfordern, separate Dashboards zu überprüfen.
Organisationsprozesse
Technologie allein reicht nicht aus, um ein Programm erfolgreich zu machen. Teams benötigen klare Protokolle für die Reaktion auf Warnmeldungen, die Bewertung von Empfehlungen und die Dokumentation der Ergebnisse. Die Rückkopplung zwischen Vorhersagen und tatsächlichen Ergebnissen ermöglicht eine kontinuierliche Verbesserung der Modellgenauigkeit.
Ist Ihre Dateninfrastruktur bereit für die vorausschauende Instandhaltung?
Lassen Sie uns Ihre Sensoren, Netzwerke und Systeme analysieren, um ein erfolgreiches Programm zu entwickeln.
Vorteile der Implementierung eines Predictive-Maintenance-Programms
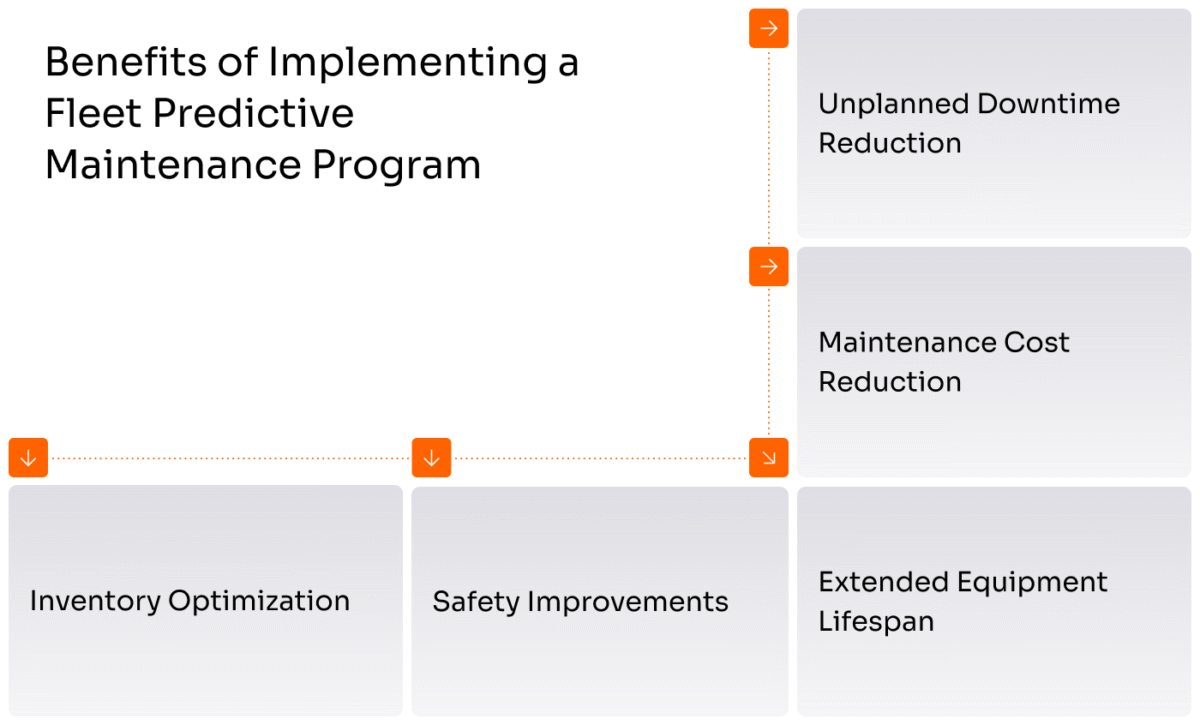
Die wirtschaftliche Argumentation für die vorausschauende Instandhaltung geht weit über die Vermeidung von katastrophalen Ausfällen hinaus. Untersuchungen in verschiedenen Branchen haben spezifische, messbare Verbesserungen dokumentiert, die sich direkt auf das Ergebnis auswirken.
Unvorhergesehene Ausfälle stellen die sichtbarste Kostenform dar, die durch vorausschauende Wartungspläne abgedeckt werden. Wenn eine Produktionslinie unerwartet ausfällt, umfassen die direkten Kosten die Kosten für Notfallreparaturen, die schnellere Lieferung von Ersatzteilen und die verlorene Produktion. Die indirekten Kosten übersteigen diese direkten Ausgaben oft. Hersteller verpassen Lieferverpflichtungen und zahlen Strafgebühren. Die Lagerhaltung verliert im Hochsaisonzeitraum an Durchsatz. Flottenbetreiber verlieren Fahrer und enttäuschen Kunden. Studien zeigen, dass vorausschauende Instandhaltung die Betriebsdauer von Anlagen um 10 bis 20 Prozent steigern kann, indem einfach solche unvorhergesehenen Ausfälle verhindert werden.
Bei vorausschauenden Ansätzen sinken die Instandhaltungskosten selbst. Techniker ersetzen nur dann Komponenten, die noch ordnungsgemäß funktionieren, weil sie einen geplanten Wartungsintervall erreicht haben. Außerdem vermeiden sie die teuren Notfalldienstgebühren. In einer Studie von MIT Trucking wurde festgestellt, dass vorausschauende Ansätze unnötige Reparaturen deutlich weniger reduzieren als Störungen verhindern. Techniker, die über präzise Zustandsdaten verfügen, überschätzen das Störrisiko nicht mehr und führen keine kostspieligen Eingriffe an Geräten durch, die keine sofortige Aufmerksamkeit erfordern. Die Gesamtkosten für Instandhaltung reduzieren sich im Vergleich zu reaktiven und präventiven Strategien um 15 bis 30 Prozent.
Die Lebensdauer der Ausrüstung verlängert sich, wenn Probleme früh erkannt werden. Ein Lager, das bereits erste Anzeichen von Verschleiß aufweist, kann während der regelmäßigen Wartung ausgetauscht werden. Ignorieren Sie die Warnung und das Lager führt zu Schäden an der Welle, dem Gehäuse und den umliegenden Komponenten. Eine ursprünglich $500-Euro Reparatur wird zu einer $5.000-Euro-Neubauaufgabe. Predictive Monitoring ermöglicht die Behebung kleiner Probleme, bevor sie zu größeren Schäden führen. Anlagen laufen 20 Prozent länger, wenn sie gemäß der tatsächlichen Zustandsparameter gewartet werden.
Die Sicherheitsverbesserungen gehen mit den operativen und finanziellen Vorteilen einher. Ausfälle der Ausrüstung in Industrieanlagen stellen Arbeitern Gefahren dar. Ein defekter Förderband in einem Lager, ein überhitzter Motor in einer Fabrik oder ein Bremsproblem in einem Nutzfahrzeug stellen alle Risiken dar, die über die wirtschaftlichen Schäden hinausgehen. Die frühzeitige Erkennung dieser Probleme schützt sowohl die Mitarbeiter als auch das Unternehmen vor den Folgen von Sicherheitsvorfällen.
Mit vorausschauenden Daten wird das Bestandsmanagement strategischer. Anstatt Teile vor unvorhersehbaren Ausfällen zu lagern, können Wartungsteams Komponenten bestellen, wenn Prognosen eine bevorstehende Nachfrage anzeigen. Dadurch wird das betriebliche Kapital, das in den Beständen an Ersatzteilen verbleibt, um 20 bis 50 Prozent reduziert, während gleichzeitig die Verfügbarkeit der Teile bei Serviceanforderungen tatsächlich verbessert wird.
Schritte zum Start eines Predictive-Maintenance-Programms
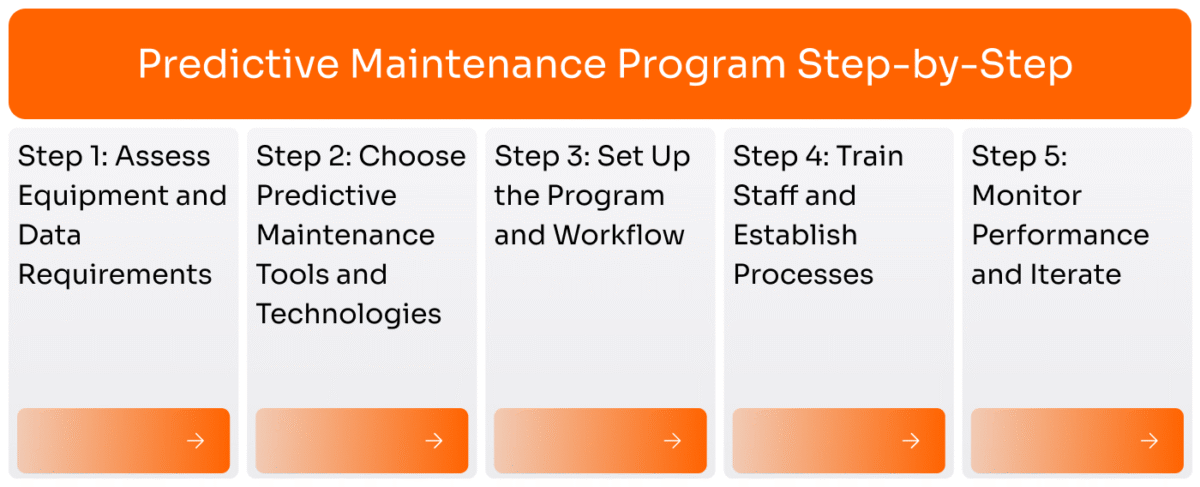
Die Einführung eines Predictive-Maintenance-Programms erfordert eine systematische Planung, anstatt lediglich Sensoren zu installieren und darauf zu hoffen, dass daraus Erkenntnisse gewonnen werden können. Organisationen, die die Implementierung als strukturiertes Projekt betrachten, erzielen schneller Ergebnisse und vermeiden häufige Fehler.
Schritt 1: Ausrüstung und Datenanforderungen bewerten
Beginnen Sie damit, festzustellen, welche Assets für die Abläufe am wichtigsten sind. Nicht jedes Gerät lohnt sich in der Investition in vorausschauende Überwachung. Fokussieren Sie sich auf die Assets, bei denen ein unerwarteter Ausfall erhebliche Folgen hat – sei es durch Produktionsausfälle, Sicherheitsrisiken oder Reparaturkosten.
Für jedes kritische Anlageobjekt dokumentieren Sie die Hauptausfallarten. Produktionsanlagen können aufgrund von Verschleiß der Lager, Überhitzung der Motoren oder hydraulischen Lecks ausfallen. Flottenfahrzeuge leiden unter Motorenschäden, Getriebeproblemen und einer Verschlechterung des Bremssystems. Ein Verständnis dafür, was normalerweise fehlschlägt, unterstützt die Auswahl der Sensoren und die Modellentwicklung.
Bewerten Sie bestehende Datenspeicherquellen, bevor Sie neue Hardware installieren. Moderne Geräte verfügen oft über integrierte Diagnosesysteme und Sensoren, die relevante Daten generieren. Industrielle Steuerungssysteme, Fahrzeug-Telematik und Plattformen für die Anlagenverwaltung von Unternehmen können bereits Informationen erfassen, die für eine prädiktive Analyse nützlich sind. Die Überprüfung dieser bestehenden Datenspeicherinfrastruktur verhindert die Doppelnutzung von Funktionen und zeigt Lücken auf, die neue Sensoren erfordern.
Schritt 2: Wählen Sie „Vorhersagebasierte Wartungswerkzeuge und -technologien“
Der Technologie-Stack für die vorausschauende Instandhaltung umfasst drei Hauptbereiche: Sensoren zur Datenerfassung, Plattformen zur Datenverarbeitung und Analyse sowie Integrationswerkzeuge, die Vorhersagen mit den Instandhaltungsprozessen verbinden.
Die Sensorauswahl hängt von den spezifischen Störzuständen ab, die überwacht werden sollen. Vibrationssensoren erkennen Probleme mit Lagern und Motorenunbalancen. Temperatursensoren erkennen Überhitzung in elektrischen Systemen und Reibung in mechanischen Komponenten. Ölanalyse-Sensoren überwachen die Verschlechterung der Flüssigkeiten. Drucksensoren erkennen Leckagen und Systemineffizienzen. Das Ziel besteht darin, Sensoren einzusetzen, die frühzeitig Warnsignale für die schwerwiegendsten Störzustände liefern.
Analytische Plattformen reichen von einfacher statistischer Überwachung bis hin zu anspruchsvollen maschinellen Lernsystemen. Frühe Programme beginnen oft mit schwellenbasierenden Warnmeldungen, die ausgelöst werden, wenn Messwerte den normalen Werten übersteigen. Weiterentwickelte Implementierungen verwenden maschinelle Lernmodelle, die komplexe Muster über mehrere Sensoren erkennen und spezifische Ausfallarten mit einem geschätzten Zeitpunkt vorhersehen.
Überlegen Sie, ob Sie die Analysefunktionen intern entwickeln oder mit spezialisierten Anbietern zusammenarbeiten sollten. Die Entwicklung von maschinellen Lernmodellen erfordert Datenwissenschaftskompetenz und umfangreiche historische Daten für die Schulung. Viele Organisationen verfügen zunächst über weder die Ressourcen noch die Fachkenntnisse. externe Anbieter bieten vorgefertigte Modelle und Branchenexpertise, die die Implementierung beschleunigen, insbesondere bei häufig verwendeten Anlagearten wie Industrielasern, HVAC-Systemen oder Fahrzeugmotoren.
Schritt 3: Programm und Workflow einrichten
Ein erfolgreicher Prozess für die vorausschauende Instandhaltung erfordert die Koordination der Datenerhebung, die Implementierung von Modellen und die Bereitstellung von Warnmeldungen. Sensoren benötigen eine zuverlässige Verbindung, um Daten an Analyseplattformen zu übermitteln. Cloud-basierte Systeme bieten Skalierbarkeit und Fernzugriff, erfordern jedoch die Beachtung von Sicherheits- und Bandbreitenanforderungen. Edge-Computing-Ansätze verarbeiten Daten lokal und reduzieren so die Übertragungsanforderungen und verbessern die Reaktionszeiten.
Definition klarer Workflows für die Alarmverarbeitung. Wenn das System einen Ausfall prognostiziert, wer erhält die Benachrichtigung? Wie bestimmt der Bewertungsprozess, ob sofort gehandelt werden soll oder die Intervention während der geplanten Ausfallzeitplanung geplant wird? Wie dokumentieren Techniker ihre Reaktion und die tatsächliche Gerätezustandsermittlung? Diese Protokolle verhindern, dass Warnmeldungen ignoriert werden, und sorgen dafür, dass das System aus dem Feedback lernen kann.
Die Integration mit bestehenden Systemen bestimmt, ob Prognosen zu Maßnahmen führen oder übersehen werden. Die automatische Erstellung von Arbeitsaufträgen im Wartungsmanagement-System, die Reservierung von Ersatzteilen im Bestandsmanagement-System und die Anpassungen der Zeitpläne im Betriebskalender erhöhen alle die Reaktionsraten. Je einfacher es den Teams gelingt, auf Prognosen zu reagieren, desto mehr Wert bringt das Programm.
Schritt 4: Schulung des Personals und Einführung von Prozessen
Instandhaltungstechniker bringen jahrzehntelange Erfahrung mit der Analyse des Geräteeinbaus durch Schall, Vibrationen, Temperatur und Leistung mit ein. Vorhersagende Systeme ergänzen diese Expertise und ersetzen sie nicht. Effektive Schulungen helfen den Technikern dabei, zu verstehen, was die Sensoren messen, wie Algorithmen Vorhersagen generieren und wann sie dem System und nicht ihrem eigenen Urteilsvermögen vertrauen sollten.
Erklären Sie die Hintergründe der Prognosen und behandeln Sie das System nicht mehr als eine schwarze Box. Wenn eine Warnung auf Verschleiß der Lagerungen hinweist, zeigen Sie den Technikern die Frequenzmuster der Vibrationen an, die die Warnung ausgelöst haben. Wenn das Modell einen Kühlmittelleck vorhergesagt, zeigen Sie die Temperaturentwicklungen und Druckwerte an, die die Diagnose bestätigen. Diese Transparenz schafft Vertrauen und hilft den Technikern, eine bessere Rückmeldung über die Prognosegenauigkeit zu geben.
Erstellen Sie Dokumentation, die eine konsistente Ausführung unterstützt. Checklisten für die Reaktion auf bestimmte Alarmtypen gewährleisten eine gründliche Untersuchung. Vorlagen für Zustandsberichte erfassen Beobachtungen, die die Modellbildung verbessern. Standardprozesse für die Eskalation ungewisser Situationen verhindern sowohl übermäßige Reaktionen als auch gefährliche Vernachlässigung.
Schritt 5: Leistungsüberwachung und Iteration
Vorausschauende Instandhaltungsprogramme verbessern sich durch kontinuierliche Weiterentwicklung auf Grundlage der tatsächlichen Ergebnisse. Verfolgen Sie, wie oft die Prognosen Fehler richtig identifizierten, wie viele falsche Alarme auftraten und wie viel Vorausschauung das System bereitstellte. Diese Leistungsdaten dienen als Orientierungshilfe für Anpassungen bei der Sensorauswahl, den Warngrenzwerten und den Modellparametern.
Dokumente zeigen auf, dass Fehler ohne Vorhersage auftraten. Dies sind Lücken in der Überwachungsmethode. Analysen können fehlende Sensoren, unzureichende Datenqualität oder nicht noch modellierte Ausfallmodi aufzeigen. Jede Überraschung bietet Informationen zur Verbesserung des Programms.
Ebenso sollten falsche Alarme untersucht werden, bei denen Vorhersagen Inspektionen zur Folge hatten, aber keine Probleme aufdeckten. Hohe Falschalarminzahlen schwächen das Vertrauen und verschwenden Wartungsressourcen. Durch Abstimmung der Alarmschwellen und Verbesserung der Modelle zur Unterscheidung normaler Abweichungen von tatsächlicher Degradation werden diese Störungen reduziert, während die Erkennung echter Probleme weiterhin gewährleistet bleibt.
Von der Datenerfassung bis zur Workflow-Integration.
Wir entwickeln die ganzheitliche Analyseplattform, die Sie benötigen, um Ausfallzeiten bei der Ausrüstung zu prognostizieren und zu verhindern.
Erstellung eines Predictive-Maintenance-Plans
Ein formeller Wartungsplan bildet die Grundlage, die Technologiefähigkeiten in eine konsistente operative Praxis umwandelt. Der Plan sollte mehrere wichtige Elemente umfassen, die die tägliche Durchführung leiten.
Überwachungshäufigkeit
Verschiedene Ausrüstungstypen und Ausfallmodi erfordern unterschiedliche Überwachungsschnitte. Kritische Sicherheitssysteme benötigen möglicherweise kontinuierliche Echtzeitüberwachung mit sofortigen Warnmeldungen. Andere Anlagen können stündlich oder täglich überprüft werden. Die Überwachungshäufigkeit sollte der Geschwindigkeit entsprechen, mit der Probleme typischerweise auftreten. Lagerausfälle zeigen oft bereits Tage oder Wochen vor sich selbst Warnzeichen. Elektrische Ausfälle können viel schneller fortschreiten.
Wichtige Leistungsindikatoren
Erstellen Sie Kennzahlen, die sowohl die technische als auch die geschäftliche Leistung messen. Technische KPIs umfassen die Wahrscheinlichkeit der Vorhersagung, die Fehlerwahrscheinlichkeit und die durchschnittliche Wartezeit bis zu einer Störung. Geschäftliche Kennzahlen messen die Instandhaltungskosten pro Anlage, die Häufigkeit planloser Ausfallzeiten und das Verhältnis zwischen Reparatur und Ersatz. Eine regelmäßige Überprüfung dieser Indikatoren führt zu Programmausbauarbeiten und zeigt den Stakeholdern den Nutzen.
Reportingstruktur
Definieren Sie, wie Informationen in der Organisation fließen. Tagesaktuelle Berichte können aktuelle Warnmeldungen und geplanten Maßnahmen aufzeigen. Wochenliche Zusammenfassungen liefern den Instandhaltungsexperten Trendanalysen und Daten zur Ressourcenplanung. Monatliche Executive-Berichte quantifizieren Kosteneinsparungen, Lieferschneidigkeiten und den Fortschritt bei der Erreichung strategischer Ziele. Eine klare Berichtsumstrukturierung und ein standardisiertes Vorhersagemanagementformat für Warnmeldungen und Zusammenfassungen halten alle Beteiligten auf dem Laufenden und sorgen für eine Abstimmung.
Teamrollen und Verantwortlichkeiten
Erfolgreiche Programme erfordern die Zusammenarbeit zwischen Wartungsingenieuren, die sich mit den Geräten auskennen, Datenanalysten, die Sensinformation interpretieren, und Betriebsleiters, die Wartungsbedarfe im Einklang mit den Produktionsplänen ausrichten. Dokumentieren Sie, wer die Systemwarnmeldungen überwacht, wer Eingriffsbefehle genehmigt, wer die eigentliche Wartungsarbeit durchführt und wer die Ergebnisse zur kontinuierlichen Verbesserung analysiert. Eine klare Rollenverteilung verhindert Verzögerungen und gewährleistet die Rechenschaftspflicht.
Eschalierungsverfahren
Nicht jede Vorhersage erfordert sofortige Maßnahmen, doch einige erfordern eine schnelle Reaktion. Definieren Sie Kriterien für den Ausbau von Risikosituationen. Ausrüstung, die Anzeichen für einen drohenden katastrophalen Ausfall zeigt, benötigt eine andere Behandlung als eine allmähliche Abnutzung, die auf eine geplante Wartung warten kann. Klar definierte Eskalationspfade gewährleisten, dass kritische Situationen angemessene Aufmerksamkeit erhalten, ohne dass dies um die Routineprobleme unnötig dringlich wird.
Wie man die Wirksamkeit eines Predictive-Maintenance-Programms misst
Um den Wert eines Programms zu demonstrieren, müssen bestimmte Kennzahlen erfasst werden, die sowohl die operativen Verbesserungen als auch die finanziellen Ergebnisse abbilden. Mehrere Messgrößen geben einen Einblick darüber, wie gut der prädiktive Ansatz funktioniert.
Durchschnittliche Zeit zwischen Ausfällen
Diese Kennzahl zeigt an, wie lange die Ausrüstung zwischen den Ausfallereignissen läuft. Effektive vorausschauende Instandhaltung sollte diese Laufzeit verlängern, da Probleme erkannt und behoben werden, bevor sie zu Ausfällen führen. Durch die Vergleiche zwischen vor- und nachprogrammierter MTBF-Berechnung wird klarer Nachweis für die Verbesserung der Zuverlässigkeit gegeben.
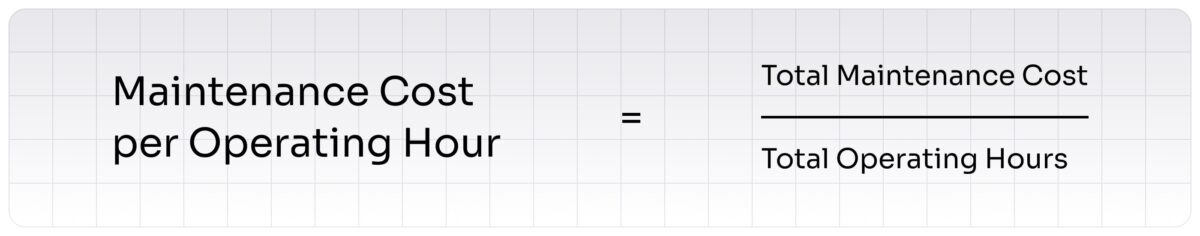
Instandhaltungskosten pro Betriebsstunde
Die Gesamtausgaben für Instandhaltung geteilt durch die Betriebsdauer der Geräte offenbaren Effizienztrends. Vorhersagende Programme sollten diese Kennzahl senken, indem unnötige vorbeugende Instandsetzungen vermieden und kostspielige Notfallreparaturen vermieden werden. Diese Kennzahl kann separat für Arbeitskräfte, Ersatzteile und externe Dienstleistungen überwacht werden, um zu ermitteln, wo Einsparungen erzielt werden können.
Verhältnis zwischen geplanter und nicht geplanter Instandhaltung
Der Anteil der Wartungsarbeiten, die planmäßig statt aufgrund von Ausfällen durchgeführt werden, zeigt die Reife des Programms an. In frühen Programmen kann es zu 60% geplanten und 40% unplanierten Arbeiten kommen. Reife vorausschauende Programme erreichen oft eine Planungssicherheit von 90% oder höher, da vorausschauende Planung durch Prognosen ermöglicht wird.
Vorhersagungsgüte
Überwachen Sie, welcher Prozentsatz der Fehlerraten bei der Inspektion von Geräten durch Techniker als richtig bewertet wird. Verfolgen Sie sowohl falsche Positivmeldungen (Vorhersagen von Problemen, die nicht existierten) als auch falsche Negativmeldungen (Fehler, die ohne Vorhersage auftraten). Zielgerichtete Genauigkeit von über 70% für die meisten industriellen Anwendungen, mit einer Verbesserung im Laufe der Zeit, da die Modelle aus mehr Daten lernen.
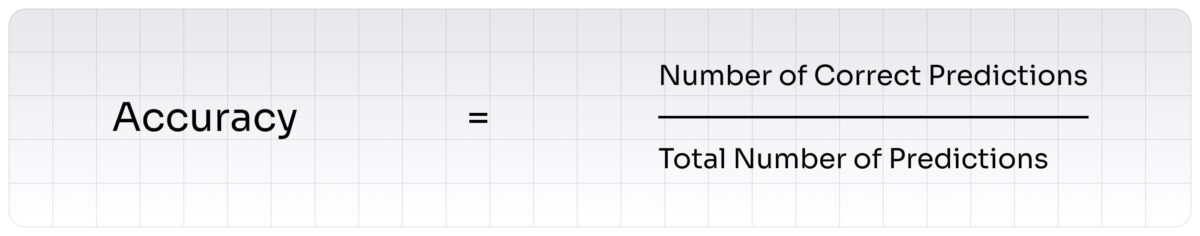
Hinweis: In der vorausschauenden Instandhaltung können “korrekte Vorhersagen” in folgende Kategorien unterteilt werden:
True Positives (TP): Das System konnte einen Fehler, der tatsächlich auftrat, richtig vorhersagen.
True Negatives (TN): Das System konnte einen Fehler nicht vorhersehen und es kam auch keine zu.
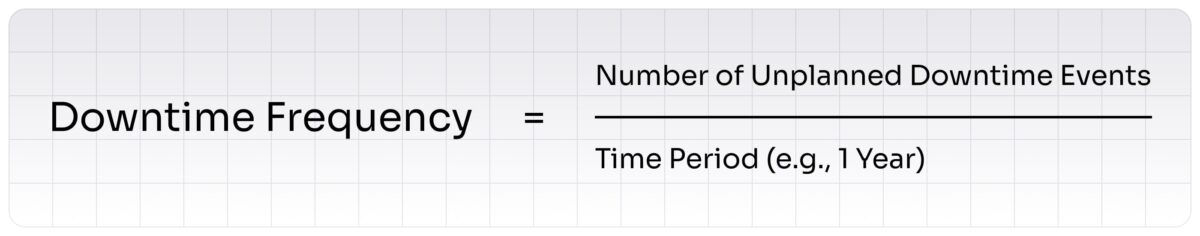
Frequenz planloser Ausfallzeiten
Mit diesem Messwert wird ermittelt, wie häufig unerwartete Ausfälle auftreten, was einen direkten Indikator dafür ist, wie gut das Prognoseprogramm funktioniert.
Wichtige Herausforderungen und Überlegungen vor Investitionen in die Vorhersagewartung
Organisationen, die Predictive Maintenance implementieren, stellen vor Mehrere häufige Hindernisse Dies kann Programme lahmlegen, wenn es nicht proaktiv angegangen wird.
Vorhersagende Modelle benötigen saubere und konsistente Daten, um präzise Prognosen zu erstellen. Sensorfehler, Kommunikationsunterbrechungen und Kalibrierungsabweichungen verfälschen alle Datenströme. Organisationen stellen oft fest, dass 30% bis 40 Prozent der Implementierungsarbeit der Aufrechterhaltung der Datenqualität dient, anstatt an der Entwicklung von Modellen zu arbeiten. Stellen Sie angemessene Ressourcen für die Dateninfrastruktur bereit und implementieren Sie Überwachungssysteme, um Probleme schnell zu erkennen.
Darüber hinaus verfügen die meisten Unternehmen über unterschiedlichste Geräteparks verschiedener Hersteller, die aus verschiedenen Altersgruppen und Technologielinien bestehen. Die Schaffung einer einheitlichen Überwachungslösung, die diese Heterogenität berücksichtigt, ist eine Herausforderung. Alte Geräte verfügen möglicherweise nicht über Sensoren. Eigenentwickelte Kommunikationsprotokolle verhindern den Datenzugriff. Die Investition in eine umfassende Integration ist erheblich und man muss akzeptieren, dass die vollständige Abdeckung Jahre dauern kann.
Erfahrene Wartungsingenieure sehen vorausschauende Systeme manchmal als Bedrohung ihrer Expertise oder als Fragezeichen für ihr Urteilsvermögen. Techniker berichten, dass die Tools ihnen geholfen haben, unnötige Arbeiten zu vermeiden (die häufigste Quelle von Einsparungen), anstatt Probleme zu erkennen, die sie sonst hätten übersehen. Betrachten Sie vorausschauende Systeme als Entscheidungsunterstützung, die erfahrene Techniker effektiver machen als eine Ersatztechnologie.
Außerdem gibt es einen weiteren Haken. Maschinelle Lernmodelle benötigen für die Trainingsphase historische Daten zu Fehlern, aber die meisten Organisationen verfügen über keine ausreichenden Aufzeichnungen über Muster von Fehlern und vorangegangenen Zuständen. Dies führt zu einem Startschwierigkeitsproblem, bei dem Programme keine präzisen Prognosen erstellen können, bis sie ausreichend betriebliche Daten gesammelt haben. Die Einführung einfacherer, schwellenbasierter Überwachung in Verbindung mit der Erstellung eines Datensatzes für komplexere Modelle bietet während der Lernphase einen Mehrwert.
Komplexere Prognoseprogramme erfordern erhebliche Investitionen in Sensoren, Softwareplattformen, Integrationsarbeiten und Schulungen. Kleinere und mittlere Unternehmen mögen Schwierigkeiten haben, die Kosten zu rechtfertigen, ohne klare ROI-Prognosen. Deshalb lohnt es sich, mit einem fokussierten Pilotprojekt auf die kritischsten Assets zu setzen, bevor man auf eine vollständige Implementierung ausweitet.
Ein erfolgreiches PdM-Programm geht über Software hinaus.
Wir helfen Ihnen dabei, die Strategie zu entwickeln, um die Qualität der Daten, die Integration und die organisatorischen Veränderungen anzugehen.
Einführung eines Pilotprogramms für vorausschauende Flottenwartung
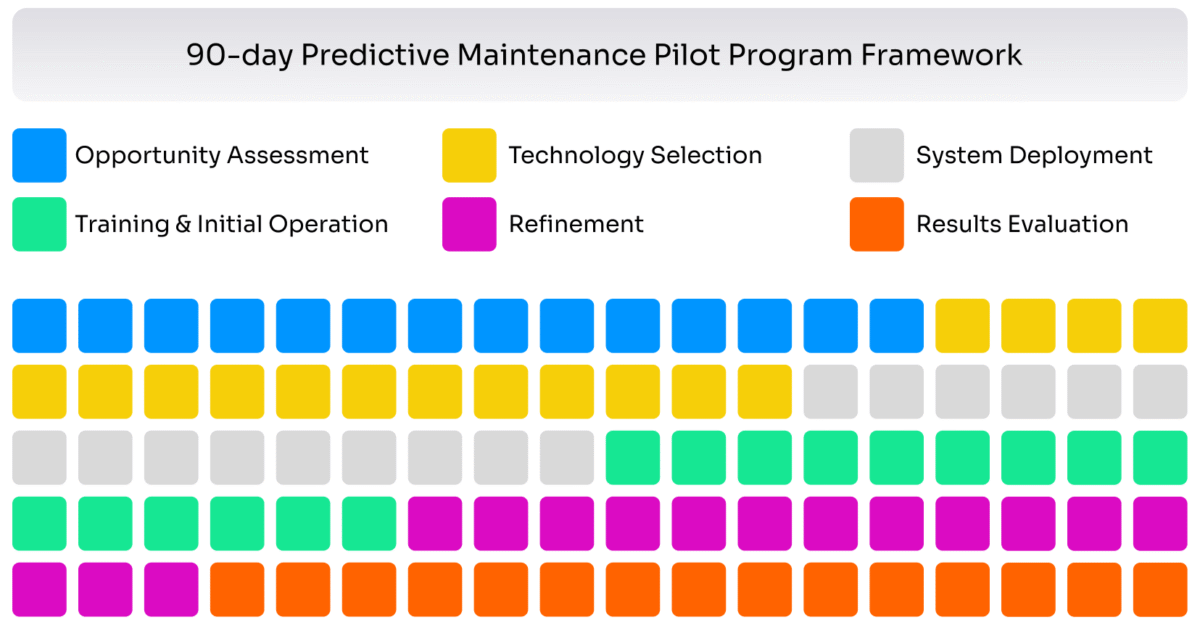
Das folgende 90-tägige Framework verdeutlicht, wie ein Logistikunternehmen einen Pilotprojekt für die vorausschauende Instandhaltung für Flotten von Nutzfahrzeugen starten könnte. Dieses konkrete Beispiel zeigt, wie die oben diskutierten Konzepte in praktische Maßnahmen umgesetzt werden können.
Tag 1-14: Chancenanalyse
Der Instandhaltungsvorstand identifiziert 50 Lkw mit den höchsten Betriebskosten als Pilotkandidaten. Eine Analyse der Instandhaltungsprotokolle zeigt, dass motorbedingte Ausfälle 40% der nicht geplanten Ausfälle verantwortlich sind und die höchsten Reparaturkosten verursachen. Das Team dokumentiert spezifische Ausfallarten: Kühlmittelleckagen, Ölverfall, Lagerverschleiß und Probleme mit der Zylinderkopfabdeckung. Es bestätigt, dass die Lkw bereits Sensordaten über Bordnetztechnik sammeln, dies jedoch niemand systematisch analysiert.
Tag 15-30: Technologieauswahl
Das Unternehmen bewertet, ob es analytische Funktionen intern entwickeln oder mit einem spezialisierten Anbieter für vorausschauende Instandhaltung zusammenarbeiten soll. Aufgrund der begrenzten Datenwissenschaftsressourcen und der Notwendigkeit schnellem Ergebnises erreicht es die Entscheidung für einen Anbieter, der vordefinierte Modelle für Motoren von Nutzfahrzeugen anbietet. Die Plattform des Anbieters ist direkt mit dem bestehenden Telematiksystem verbunden und integriert sich mit der aktuellen Instandhaltungssystemsoftware. Die Preise basieren auf einem monatlichen Preismodell pro Fahrzeug, das die Kosten an die Programmgröße anpasst.
Tag 31-45: Systembereitstellung
Techniker aktivieren erweiterte Datenerfassung auf Pilotfahrzeugen und erfassen detaillierte Sensordaten der Motoren, einschließlich Temperaturen, Drücken, Vibrationen und Fluidbedingungen. Der Anbieter konfiguriert Warngrenzwertgrenzen basierend auf den Fahrzeugspezifikationen und historischen Daten. Integrationsteams verbinden die Prognoseplattform mit dem Arbeitsauftrags-System, sodass Warnmeldungen automatisch Inspektionsaufgaben erstellen. Sie etablieren einen täglichen Überprüfungsprozess, bei dem der Instandhaltungssupervisor die Prognosen überprüft, weitere Maßnahmen festlegt und die Ergebnisse dokumentiert.
Tag 46-60: Training und erste Operation
Alle Techniker absolvieren eine Schulung zur Reaktion auf vorausschauende Warnmeldungen. Der Anbieter erläutert, welche Sensormuster spezifische Probleme anzeigen und wie die Konfidenzniveaus die Dringlichkeit der Reaktion steuern sollten. In den ersten zwei Wochen behandelt das Team alle Warnmeldungen als Inspektionsempfehlungen und nicht als verpflichtende Maßnahmen, wodurch das Vertrauen in das System aufgebaut wird, ohne dass sofortige Maßnahmen erzwungen werden müssen. Die Techniker geben Rückmeldung zur Vorhersagungsgüte und schlagen Grenzwerteanpassungen vor.
Tag 61-75: Verfeinerung
Eine Analyse der ersten 30 Betriebstage zeigt, dass die Vorhersagen für Kühlmittelleckage eine Genauigkeit von 85 Prozent erreichen, während Warnmeldungen für Lagerverschleiß nur eine Genauigkeit von 45 Prozent aufweisen und häufig falsche Ergebnisse ergeben. Das Team arbeitet mit dem Hersteller zusammen, um die Grenzwerte für die Lagerüberwachung neu kalibrieren zu lassen. Es stellt fest, dass lokale Betriebsbedingungen (häufige Stopp-und-Start-Situationen auf urbanen Lieferrouten) Vibraptionsmuster erzeugen, die das Modell falsch interpretiert. Durch Anpassung an diese Umstände wird die Leistung verbessert. Dokumentationsprozesse werden anhand der Rückmeldung der Techniker optimiert.
Tag 76-90: Ergebnisbewertung
Das Pilotprogramm zeigt messbare Verbesserungen. Die unplanmäßige Ausfallzeit wurde um 12 Prozent reduziert, da Probleme bereits vor den eigentlichen Ausfällen erkannt wurden. Die Instandhaltungskosten pro Fahrzeug gingen monatlich um $180 zurück, bedingt durch weniger Notfallanrufe und eine bessere Teileplanung. Das Team dokumentierte fünf Fälle, in denen die Prognosen Probleme aufdeckten, die Techniker mithilfe herkömmlicher Inspektionsmethoden möglicherweise hätten übersehen. Basierend auf diesen Ergebnissen genehmigt die Geschäftsführung die Erweiterung der Flotte auf insgesamt 500 Fahrzeuge innerhalb der nächsten sechs Monate.
Diese Pilotstrategie folgt dem Engagementmodell, das viele erfolgreiche Programme verwenden: Erst nach einer erprobten Testphase in überschaubaren Maßstäben wird eine umfassendere Implementierung in das gesamte Unternehmen überführt. Die fokussierte Ausrichtung ermöglicht eine schnelle Umsetzung und liefert gleichzeitig die notwendigen Beweise, um eine umfassendere Investition zu rechtfertigen.
Fazit
Vorhersagende Instandhaltungsprogramme stellen einen grundlegenden Wandel gegenüber dem Versprechen, dass die Ausrüstung bis zum geplanten Servicewartungsintervall selbstständig funktioniert, dar. Die Technologie, die diesen Wandel ermöglicht, hat sich rasant weiterentwickelt. Sensoren kosten heute einen Bruchteil der Kosten, die sie vor einem Jahrzehnt waren. Cloud-Plattformen bieten unbegrenzte Analysekapazitäten. Maschinelles Lernen erkennt subtile Ausfallmuster, die von Menschen nicht wahrgenommen werden können. Diese Fähigkeiten kombinieren sich zu dokumentierten Einsparungen, die Investitionen in Branchen von der Fertigung über die Logistik bis hin zur Energieerzeugung rechtfertigen.
Erfolg erfordert mehr als die Implementierung von Technologien. Organisationen müssen Vorhersagen in bestehende Workflows integrieren, Teams schulen, um Warnmeldungen zu interpretieren und darauf zu reagieren, die Datenqualität aufrechterhalten und Modelle kontinuierlich anhand der Ergebnisse in der Praxis verbessern. Die Unternehmen, die die stärksten Renditen erzielen, behandeln predictive Maintenance als ein systematisches Programm und integrieren es in ihre Kernprozesse. Businessmodell für vorausschauende Instandhaltung, Stattdessen als ein einmaliges Projekt.
Für Unternehmen, die bereit sind, mit einem fokussierten Pilotprojekt auf hochwertige Vermögenswerte zu setzen, bietet dies den sichersten Weg. Beweisen Sie, dass das Konzept in Ihrer spezifischen Betriebsumgebung funktioniert, bevor Sie es umfassender ausbauen. Nutzen Sie die Ergebnisse des Pilotprojekts, um die Technologieauswahl zu optimieren, die Teamfähigkeiten zu entwickeln und das organisatorische Selbstvertrauen zu stärken. Das oben beschriebene 90-tägige Framework bietet eine Vorlage, die sich für die meisten Branchen und Gerätetypen anpassen lässt.
Die Frage, vor die sich Wartungsleiter heute stellen, dreht sich nicht darum, ob präventive Ansätze angewendet werden sollen, sondern vielmehr darum, wie schnell der Übergang erfolgen kann. Die Ausrüstung veraltet immer weiter. Fehler treten immer wieder auf. Die Kosten steigen. Jede weitere investierte Zeit in die Planung bedeutet einen weiteren Tag, in dem Probleme bezahlt werden müssen, die hätte verhindert werden können.
Seid Sie bereit, zu erkunden, wie predictive Maintenance Ihre Instandhaltungskosten senken und die Zuverlässigkeit Ihrer Anlagen verbessern könnte? Yalantis hat Logistik-, Fertigungs- und Industrieunternehmen dabei geholfen, erfolgreiche predictive Programs einzuführen. Vereinbaren Sie einen Termin für eine Beratung, um Ihre spezifische Situation zu besprechen und einen maßgeschneiderten Implementierungsplan zu erhalten.
FAQ
Welche Daten sind für einen Predictive-Maintenance-Pilot erforderlich?
Ein erfolgreicher Pilot erfordert mindestens mehrere Monate mit Daten aus der normalen Betriebsbereitschaft der Geräte, einschließlich Sensormessungen, Fehlercodes und Wartungsaufzeichnungen. Die wertvollsten Daten erfassen das Geräteverhalten sowohl vor als auch nach Ausfällen. Bei Flottenfahrzeugen liefern die Bordtelematiksysteme in der Regel 80-90 Prozent der notwendigen Daten. Bei Produktionsanlagen kann eine Nachrüstung zusätzlicher Sensoren erforderlich sein, um kritische Parameter wie Vibrationen, Temperatur und Druck zu überwachen. Historische Wartungsaufzeichnungen, die die Typen von Ausfällen, Symptomen und Korrekturmaßnahmen dokumentieren, helfen dabei, Modelle zu trainieren, um Warnmuster zu erkennen.
Wie lange sollte ein Pilotprogramm in der Regel dauern, bevor Ergebnisse sichtbar werden?
Die meisten Piloten zeigen innerhalb von 60-90 Tagen erste Ergebnisse, benötigen jedoch 4-6 Monate für statistisch signifikante Ergebnisse. Die Zeitspanne hängt von den Ausfallraten der Ausrüstung und den Betriebzyklen ab. Anlagen, die monatlich ausfallen, liefern schnelleres Feedback als Ausrüstung, die jährlich ausfällt. Frühindikatorien wie die Vorhersagtrechnungen und die Reaktionsraten an Warnmeldungen werden innerhalb weniger Wochen sichtbar. Kosteneinsparungen und Verbesserungen der Zuverlässigkeit erfordern längere Zeiträume, um aussagekräftige Daten zu sammeln. Planen Sie Pilotprojekte mindestens über einen vollständigen Wartungszyklus hinweg durchzuführen, um saisonale Schwankungen und unterschiedliche Betriebsumgebungen zu erfassen.
Wie viel kostet die Implementierung eines Predictive-Maintenance-Programms?
Die Kosten variieren stark je nach Assettyp, Flottengröße und bestehender Infrastruktur. Eine grundlegende Pilotphase zur Überwachung von 25-50 kritischen Assets erfordert in der Regel $50.000-$150.000 für Sensoren, Software, Integration und Beratungsunterstützung. Implementierungen in Unternehmen mit Hunderten oder Tausenden von Assets können mit $500.000-$2.000.000 eine umfassende Abdeckung ermöglichen.
Wie kann die Wirksamkeit eines Predictive-Maintenance-Programms gemessen werden?
Die Messung der Effektivität sollte sowohl führende Indikatoren (Vorhersagungsgenauigkeit, Reaktionszeit bei Alarmen, Fehlalarmschwelle) als auch nachgelagerte Indikatoren (Mieteinnahmen, Instandhaltungskosten, Ausfallhäufigkeit) berücksichtigen. Vergleiche die Messwerte vor und nach der Implementierung, um Verbesserungen quantifizieren zu können. Die wichtigsten Messgrößen sind die durchschnittliche Ausfallzeit, die Instandhaltungskosten pro Betriebsstunde, das Verhältnis zwischen geplanter und unplanmäßiger Instandhaltung sowie die Gesamtkosten der Instandhaltung. Finanzkennzahlen sollten die vermeidbaren Kosten aus vermeideten Ausfällen, die reduzierten Kosten für Notdienste, die optimierte Teilebestandsführung und die verlängerte Lebensdauer der Geräte umfassen. Die meisten Organisationen sehen innerhalb von sechs Monaten messbare Verbesserungen, erreichen aber den maximalen Wert erst nach 18-24 Monaten, da die Modelle sich weiterentwickeln und die Teams Prozesse optimieren.
Wie kann ich einen erfolgreichen Pilotprojekt in eine umfassende Strategie für die vorausschauende Instandhaltung umwandeln?
Die Skala basiert auf den Erkenntnissen aus dem Pilotprojekt und zielt nicht darauf ab, den Ansatz umfassend zu übernehmen. Identifizieren Sie, welche Gerätearten die stärkste Vorhersagungsgüte und den höchsten ROI aufweisen. Erweitern Sie zunächst die Abdeckung auf ähnliche Assets, bevor Sie anspruchsvollere Anwendungen angehen. Standardisieren Sie die Dateninfrastruktur, die Warnworkflows und die Berichtsformate, um operative Großmaßstäbe zu ermöglichen. Entwickeln Sie interne Expertise durch Schulungen und Einstellung von Mitarbeitern statt weiterhin auf externe Anbieter angewiesen zu sein. Integrieren Sie Prognosefunktionen in strategische Entscheidungen zur Anlagenverwaltung, einschließlich der Auswahl von Geräten, der Altersplanung und der Vertragsverhandlungen für Serviceleistungen. Reife Programme entwickeln sich aus der Vermeidung von Ausfällen hin zu einer Optimierung der Gesamtkosten im gesamten Anlagenportfolio.
Über den Autor