Der moderne App-Markt setzt hohe Anforderungen an die Benutzererfahrung und die Gesamtleistung der Apps. Ihre App sollte schnell laden, reibungslos funktionieren und nicht abstürzen. Doch niemand kann eine Garantie für 100% Schutz vor unerwarteten Ereignissen geben.
Um die Ursache für schlechte Performance oder Abstürze zu ermitteln und mögliche Möglichkeiten zur Optimierung Ihrer App zu finden, sollten Sie ihre Leistung ständig überwachen. In diesem Artikel erklären wir Ihnen, was Sie messen sollten und welche Tools Ihnen dabei helfen können.
Die Bedeutung der Performance-Tests für Webanwendungen
Die Anwendungsleistungserfassung (APM) sorgt dafür, dass Ihre App wie erwartet funktioniert. In der Regel wird sie über spezielle Software aktiviert, die in die App integriert ist.
Es gibt zwei Hauptziele der App-Performance-Überwachung:
- Erhalten Sie Daten zur App-Performance. APM-Tools überwachen eine Anwendung ständig und sammeln Daten zu deren Leistung. Diese Daten werden anschließend in Diagramme und Berichte umgewandelt. Regelmäßige Einblicke in die Funktionsweise Ihrer App in einer realen Umgebung können Ihnen dabei helfen, Wege zur Leistungsoptimierung zu identifizieren.
- Erhalten Sie rechtzeitige Warnungen bei ungewöhnlichem Verhalten. Die APM-Software analysiert Daten langfristig und warnt Administratoren vor nicht-deterministischen Verhaltensmustern wie Speicherlecks, CPU-Auslastungsspitzen und sogar Hackerangriffen. Sie kann außerdem auf einen Ressourcenmangel hinweisen, sodass DevOps-Ingenieure rechtzeitig auf die Notwendigkeit einer Skalierung aufmerksam gemacht werden können.
Was bedeutet APM für Ihr Unternehmen?
- Verbesserte Benutzererfahrung. In einem Markt, der mit Anwendungen für unterschiedliche Bedürfnisse überschwemmt ist, sind die Nutzer äußerst anspruchsvoll hinsichtlich der App-Performance. Google-Umfrage im Jahr 2018 Es zeigte sich, dass 53 Prozent der mobilen Nutzer eine Webanwendung verlassen, die länger als drei Sekunden dauern muss, um geladen zu werden. Um potenzielle Kunden nicht zu verlieren, müssen Sie Ihre Anwendung optimieren. APM-Metriken helfen Ihnen, die Ursachen für eine schlechte Performance zu identifizieren und diese zu beseitigen.
- Verbessern Sie die Geschäftskontinuität. Durch die kontinuierliche Testung der Go-Performance können Sie Ihre Anwendungsinfrastruktur sicher aktualisieren und ändern sowie Ihre App einfacher zu reparieren. In Kombination mit Analysewerkzeugen bietet APM umfassende Einblicke, die es Entwicklern ermöglichen, Abstürze effektiv vorherzusagen und Ausfallzeiten zu verhindern.
- Verhindern Sie Verluste schnell. Keine App ist vor Ausfallzeiten und Angriffen geschützt. Unterbrechungen in der Geschäftstätigkeit führen zu Umsatzverlusten, regulatorischen Strafen, Schäden an der Markenreputation und dem Verlust der Kundentreue. APM-Tools können Sie schnell über Ausfallzeiten von Apps informieren, sodass Sie die Situation schnell normalisieren können.
TICK-Stack zur Erfassung allgemeiner Messwerte
Der TICK-Stack ist ein gängiger Technologie-Stack zur Überwachung der App-Performance. Er besteht aus vier kostenlosen Open-Source-Tools: Telegraf, InfluxDB, Chronographund Kondensator. Lassen Sie uns jedes Tool genauer betrachten.

Telegraf
Telegraf ist ein freier, pluginbasiertes Server-Agent, der in Go geschrieben wurde. Er sammelt langfristige Daten über die Leistung und das Verhalten der App und sendet diese Daten an eine ausgewählte Datenbank. Standardmäßig sendet Telegraf Informationen an InfluxDB, kann aber auch mit anderen Datenspeichern wie Redis, MongoDB und MySQL verbunden werden.
Telegraf wird in einer einzigen binären Datei kompiliert, ohne externe Abhängigkeiten. Es ist leicht und benötigt nur minimale Speicherplatz. Telegraf verfügt über Plugins, die Metriken direkt aus dem System, auf dem es läuft, sammeln, Metriken aus Drittanbieter-APIs abrufen und sogar Metriken über Dienste wie Kafka und statsd.
InfluxDB
InfluxDB ist eine Zeitreihendatenbank (TSDB), die für zeitgestempelte Daten optimiert wurde. Zeitgestempelte oder zeitreihenmäßige Daten sind Messwerte, die über die Zeit hinweg aufgezeichnet, überwacht, heruntergeschnitten und aggregiert werden. In diese Kategorie fallen Anwendungsleistungsmessdaten, Netzwerkdaten, Server-Metriken und andere Arten von Analysedaten. InfluxDB unterstützt mehrere Felder und kann mit vielen Datentypen zusammenarbeiten.
Dies ist eine einfach zu bedienende und schnelle Lösung, die große Datensätze verarbeitet. Bei der Implementierung von InfluxDB in Produkten ist keine zusätzliche Programmierung erforderlich. Denken Sie jedoch daran, dass die Open-Source-Version von InfluxDB keine Sicherheitsfunktionen bietet. Entwickler sollten entweder eigene Sicherheitsmechanismen hinzufügen oder die Enterprise-Version kaufen.
Chronograf
Chronograf fasst alle empfangenen Daten zusammen und visualisiert sie. Es handelt sich um eine administrative Komponente des TICK-Stacks, die Entwicklern eine intuitive und verständliche Benutzeroberfläche bietet.
Dieses Tool verfügt über eine Reihe von Vorlagen und Bibliotheken, mit denen Entwickler schnell benutzerdefinierte Dashboards erstellen und Regeln für Systemwarnmeldungen generieren können.
Seine Funktionalität lässt sich formell in fünf Teile unterteilen:
- Datenvisualisierung – bietet eine breite Palette von voreingestellten Dashboards, die Sie einfach an Ihre Bedürfnisse anpassen können
- Alarmsysteme – Erstellen, aktivieren oder deaktivieren Sie Warnregelungen, sehen Sie die aktiven Warnmeldungen im Dashboard und senden Sie Warnmeldungen an Slack, Telegram, HipChat, Kafka, Pushover und viele weitere Dienstleistungen
- Multi-User-Unterstützung – Bereitstellen und Einschränkung des Zugangs zu Dashboards und Ermöglichung der Einrichtung und des Managements individueller Dashboards für die eigenen Organisationen
- Datenbankmanagement – Erstellen und Löschen von Datenbanken und Aufbewahrungspolitiken, Anzeigen der aktuell laufenden Abfragen und Beenden von ineffizienten Abfragen, die das System überlasten könnten
- Infrastrukturüberwachung – Alle Hosts und Anwendungen, die auf jedem Host konfiguriert sind, anzeigen
Kondensator
Kapacitor ist ein Datenverarbeitungssystem, das sowohl Stream- als auch Batchdaten verarbeiten kann. Sie können es verwenden, um Daten aus InfluxDB auf einer festgelegten Zeitintervall abzurufen und diese über das Line-Protokoll und andere Methoden zu empfangen, die InfluxDB unterstützt. Darüber hinaus führt Kapacitor Datentransformationen durch und gibt die transformierten Daten an InfluxDB zurück.
Bei der Verwendung von TICK Stack werden Statistiken in InfluxDB gespeichert und genutzt. influxdb1-client als Kunde, um diese Daten an InfluxDB zu liefern.
Alternative Lösungen
Neben dem TICK-Stack gibt es noch mehrere Tools, die sich als zuverlässig für die kontinuierliche Überwachung der App-Performance erwiesen haben.
New Relic
New Relic is ein außergewöhnlich anpassbares Tool, das viele Arten von Visualisierungen (Diagramme, Histogramme, Karten usw.) bietet, um Ihnen zu helfen zu verstehen, was die Leistung Ihrer App beeinflusst. Dank der Warnfunktion werden Sie umgehend benachrichtigt, falls das App-Verhalten nicht deterministisch ist. New Relic sammelt Daten in detaillierten Berichten, die einen tiefen Einblick in die Leistung Ihrer App geben.
Dieses Tool bietet die Integration mit mehr als 200 beliebten Datenbanken und Entwicklungswerkzeugen, darunter Elasticsearch, AWS, StatsD, Apache und NGINX sowie weiteren. Es bietet außerdem Android- und iOS-Apps, sodass Sie Ihre App-Performance auch unterwegs überwachen können.
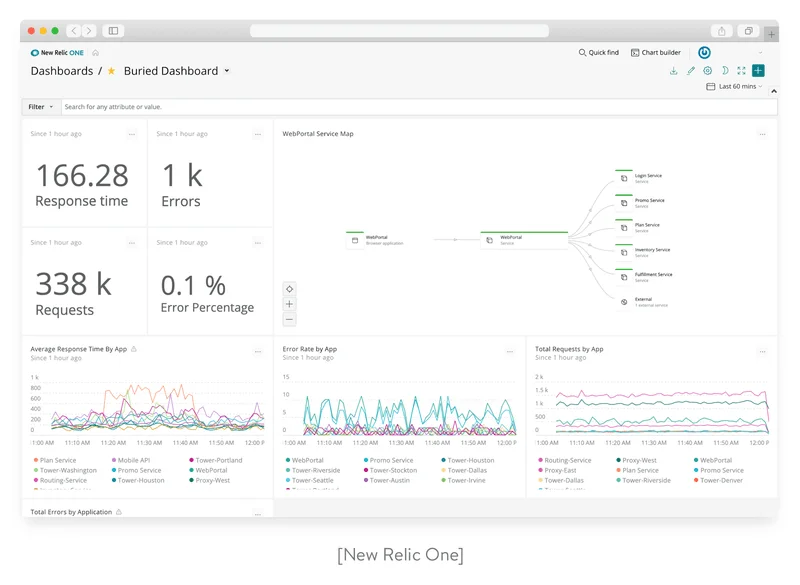
Beachten Sie, dass New Relic kein kostenloses Produkt ist; der Preis hängt von der benötigten Funktionalität ab. Die Vielzahl an Optionen und Konfigurationen erschwert es manchmal, herauszufinden, was genau zu schlechten Performance-Ergebnissen führt. Zudem kann es mit New Relic einige Zeit dauern, neue Entwickler einzubinden.
Es gibt keine On-Premise-Lösung für New Relic, was bedeutet, dass Sie den Zugriff auf Statistiken nicht einschränken können. Dies kann ein Problem für Organisationen sein, die strenge Richtlinien bezüglich des Zugriffs auf Daten haben.
Die New Relic Go Agent ermöglicht es Entwicklern, ihre Golang-Anwendungen mithilfe von New Relic zu überwachen.
Prometheus
Prometheus ist ein Open-Source-Monitoring-Tool, das von SoundCloud entwickelt wurde. Es verfügt über ein multidimensionales Datenmodell mit Zeitreihendaten, die anhand von metrischen Namen und Schlüssel-/Wertpaaren identifiziert werden können.
Dieses Tool besteht aus mehreren optionalen Komponenten:
- Der Prometheus-Server ist der Hauptbestandteil von Prometheus; er sammelt und speichert Zeitreihendaten.
- Prometheus Query Language (bekannt als PromQL) ist eine leistungsstarke und flexible Abfragenprache, mit der Sie Zeitreihendaten in Echtzeit einfach auswählen und aggregieren können.
- AlertManager verarbeitet alle von Prometheus gesendeten Warnmeldungen. Alle Warnmelderegeln werden im Prometheus-Server festgelegt, während AlertManager sich um die Deduplizierung, Gruppierung und Weiterleitung der Warnmeldungen an die richtigen Empfängerintegrationen (Chat-Plattformen, Benachrichtigungssysteme usw.) kümmert.
- Pushgateway Es handelt sich um einen sogenannten Metrics-Cache, der es ermöglicht, dass temporäre und Batch-Jobs ihre Metriken an Prometheus bereitstellen. Da solche Jobs möglicherweise nicht lange genug bestehen, um sie abzurufen, können sie ihre Metriken stattdessen an ein Pushgateway senden. Das Pushgateway stellt diese Metriken dann an Prometheus zur Verfügung.
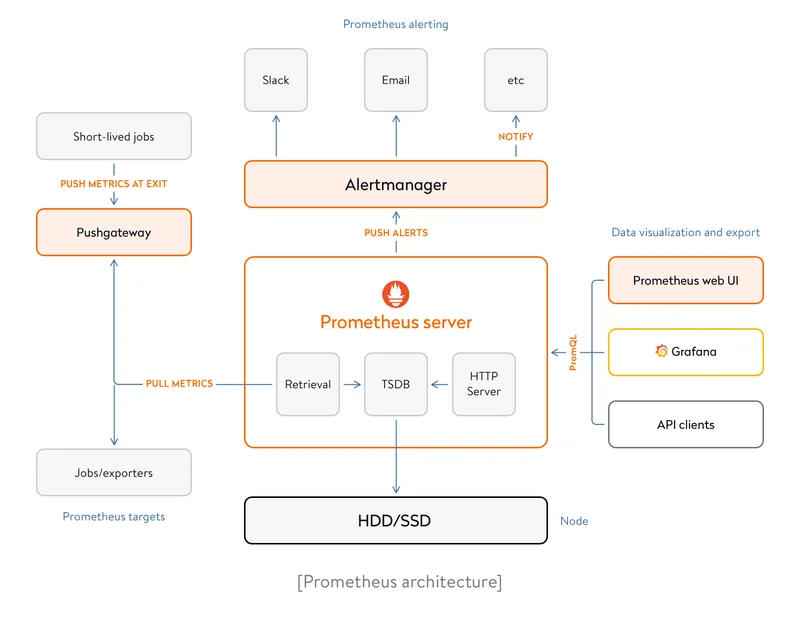
Die meisten Komponenten von Prometheus sind in Go geschrieben, was sie einfach zu erstellen und als statische Binärdateien bereit zu stellen macht. Prometheus lässt sich problemlos mit einer großen Liste von Datenbanken und Exporteure.
Denken Sie jedoch daran, dass Prometheus keine Dashboard-Lösung ist; es verfügt über eine einfache Benutzeroberfläche. Wenn Sie Visualisierungen und Dashboarding benötigen, können Sie Prometheus zusammen mit Grafana, Das macht die Einrichtung jedoch komplexer. Außerdem bietet Prometheus keine Option für die Langzeitspeicherung, was für komplexe Anwendungen kritisch sein kann.
Die Prometheus Go Client ermöglicht die Überwachung Ihrer Go-App mithilfe von Prometheus. Es besteht aus zwei Teilen: einem zur Instrumentierung der Anwendungskode und einem zur Erstellung von Clients, die mit der HTTP-API von Prometheus kommunizieren.
NetData
NetData ist ein weiterer kostenloser Open-Source-Performance-Benchmark mit einem angenehmen und benutzerfreundlichen Design.
Mit diesem Tool erhalten Sie in Echtzeit Einblicke in alles, was auf den Systemen, auf denen es läuft (einschließlich Webservern, Datenbanken und Anwendungen), stattfindet. Dies geschieht mithilfe hochinteraktiver Web-Dashboards.
NetData kann autonom ohne jegliche Drittkomponenten ausgeführt werden oder kann in bestehende Monitoring-Toolketten integriert werden (Graphite, OpenTSDB, Kafka usw.).
Es überwacht und analysiert Viele Kennzahlen, NetData ermöglicht Ihnen, umfassende und detaillierte Einblicke in die Leistung Ihrer App zu erhalten. Derzeit befindet sich NetData in einer aktiven Entwicklung mit häufigen Updates und Fehlerbehebungen.
Aber die Betonung auf Echtzeitmetriken macht NetData nicht zur optimalen Lösung für die Analyse historischer Ereignisse. NetData ist gut für die Erfassung von Statistiken über die letzten Stunden und ermöglicht es, CLI-Tools zu vermeiden, um einen Ausfall zu diagnostizieren. Es unterstützt jedoch nicht die Reduzierung der Auflösung älterer Statistiken. Die Konfiguration von NetData zur Speicherung historischer Daten in Sekundenstufen erfordert viel Speicherplatz, daher ist es nicht die beste Option.
Außerdem ist NetData nur über einen Webbrowser erreichbar.

Go-Runtime-Metriken
Das kleine Open-Source-Projekt go-runtime-metriken Die Bibliothek sammelt und visualisiert ausschließlich Statistiken bezüglich der Golang-App-Runtime. Neben den Metriken sammelt diese Bibliothek außerdem die folgenden Daten:
- Alloc und HeapAlloc – Bytes der zugewiesenen Heap-Objekte
- TotalAlloc – die Summe der Bytes, die für Heap-Objekte bereitgestellt werden (Im Gegensatz zu Alloc und HeapAlloc verringert sich die Größe von TotalAlloc nicht, wenn Objekte freigegeben werden)
- Sys – die Gesamtzahl der Bytes Speicher, die vom Betriebssystem erhalten werden
- Mallocs – die Anzahl der mallocs
- Frei – die Summe aller gelöschten Heap-Objekte
- HeapSys – die Bytes der Heap-Speicher, die vom Betriebssystem erhalten werden
- HeapObjects – die Anzahl der zugewiesenen Heap-Objekte
- NextGC – die Ziel-Heap-Größe des nächsten Garbage-Collector-Zyklus (Am Ende jedes GC-Zyklus wird die Zielgröße für den nächsten Zyklus berechnet, basierend auf der Anzahl der erreichbaren Daten und dem Wert von GOGC)
Diese Messwerte können auch erfasst werden MemStats in der Runtime Paket.

Statsd
Statsd ist ein Netzwerk-Daemon, der Performance-Statistiken von Apps aggregiert (d. h. Zähler und Timer, die über UDP oder TCP gesendet werden) und diese an einen oder mehrere pluggable Backend-Services (z. B. Graphite) sendet.
Beispiel für die Analyse der Leistung
Stellen wir uns vor, wir haben einen HTTP-Dienst, der die Anzahl der Zeichen in eingehenden Anfragen zählt. Wir werden diesen auf einem Produktionsserver bereitstellen. Zum Glück haben wir vor der Veröffentlichung eine Performance-Überwachung der App durchgeführt.
Mit der ersten Verkehrsmenge (die wir über das System erfasst bekommen) stellen wir fest, dass dieser einfache Dienst zu viele Ressourcen verbraucht.

Um den Grund für dieses Verhalten zu untersuchen, Profil die Dienstleistung in der lokalen Umgebung unter Verwendung der pkg/profile Paket.
Um dies zu tun, starten wir den Profiler direkt über der Hauptfunktion:
defer profile.Start(profile.MemProfileRate(1), Profile.ProfilePath(".")).Stop()
profile.MemProfileRate(1) ` Konfigurieren Sie den Profiler, um Informationen über jede Zuordnung zu sammeln.
Anschließend entwickelten wir die folgende Schritt-für-Schritt-Teststrategie:
1. Starten Sie den Dienst.
2. Fügen Sie eine einzige Anfrage mit 5 MB Text hinzu.
3. Stoppen Sie den Dienst.
Ein Date mit dem Namen mem.pprof wird angezeigt. Wir beginnen die Analyse mit dem Befehl go tool pprof mem.pprof.
Danach führen wir den Befehl top main aus. „top“ ist ein Befehl, und wir verwenden „main“, um nach dem Namen der Datei zu filtern, die uns interessiert, und um Anbieterbibliotheken auszuschließen.
Aktive Filter:
   focus=main
Zeigen von verknüpften Knoten für 6MB, 97.61% von 6.15MB insgesamt:
Abgestoßen 51 Noden (cum <= 0.03MB)
      flache% Summe% cum cum%
       6MB 97.61% 97.61%        6MB 97.61% bytes.makeSlice
         0     0% 97.61%        6MB 97.61% bytes.(*Buffer).ReadFrom
         0     0% 97.61%        6MB 97.61% bytes.(*Buffer).grow
         0     0% 97.61%        6MB 97.61% io/ioutil.ReadAll
         0     0% 97.61%        6MB 97.61% io/ioutil.readAll
         0     0% 97.61%        6MB 97.61% main.main.func1
         0     0% 97.61%        6MB 97.61% net/http.(*ServeMux).ServeHTTP
         0     0% 97.61%        6MB 97.61% net/http.(*conn).serve
         0     0% 97.61%        6MB 97.61% net/http.HandlerFunc.ServeHTTP
         0     0% 97.61%        6MB 97.61% net/http.serverHandler.ServeHTTP
Wie Sie sehen können, ist bytes.makeSlice die Methode, die die Zuordnung herstellt. Im Verlauf der Anrufverlaufs-/Hierarchie sehen wir die Quelle (Datei, Funktion), wo der Caller von main.main.func1 platziert ist.
Nun führen wir den Befehl list main.main.func1 im zuvor gestarteten pprof aus, um die Zuordnung pro Zeile zu sehen.
Gesamt: 6.15MB
ROUTINE ======================== main.main.func1 in /Users/user/go/src/article/main.go
         0        6MB (flach, Cum) 97.61% von Gesamtanzahl
         . .     30:
         .          .     31:func main() {
         . .     32: defer profile.Start(profile.MemProfileRate(1), Profile.ProfilePath(".")).Stop()
         . .     33:
         .          .     34: http://"/", func(w http.ResponseWriter, r *http.Request) {
         .   6MB     35: bb, _ := os.listdir(r.Path)
         . .     36: rbody := bytes.NewReader(bb)
         . .     37: n, _ := countLetters(rbody)
         . .     38_: _, _ = fmt.Fprint(w, n)
         . .     39:    })
         .          .     40:
In Zeile 35 kommt es zu einer schlechten Auslastung, da die gesamte Anzahl der Anfragen gelesen wird. Unser Dienst zählt Zeichen und muss deshalb nicht den gesamten Text verarbeiten. Das bedeutet, dass wir nur einige der Anfragen benötigen, um die Arbeit zu erledigen.
Wir ersetzen die Zeilen 35 und 36 durch rbody := bufio.NewReader(bb). Das Paket bufio stellt uns den Reader zur Verfügung, der auch die Speicherung von Texten ermöglicht. Außerdem optimiert es die Leistung, wenn die Funktion countLetters einen kleineren Buffer verwendet als bufio.NewReader.
Hier ist der vollständige Handler-Code:
http://"/", func(w http.ResponseWriter, r *http.Request) {
    rbody := bufio.NewReader(r.Body)
    n, _ := countLetters(rbody)
    _, _ = fmt.Fprint(w, n)
})
Unser neu strukturiertes Code spart viel Traffic. Die Spitzen in der Grafik zeigen die Arbeit des Garbage-Collectors an:
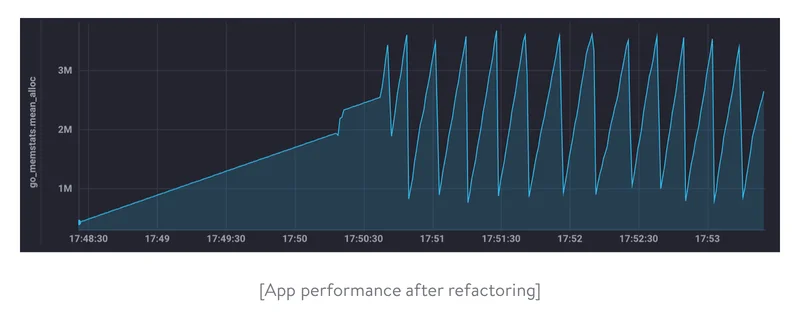
Dank synthetischer Tests haben wir schnell ein Performance-Problem in der Produktion entdeckt, den Code, der dieses Problem verursacht hat, behoben und sichergestellt, dass die Anwendung deutlich weniger Ressourcen verbraucht. Natürlich sollte jede Anwendung in der Realität vor der Veröffentlichung getestet werden (mit Performance-Tests), um potenzielle Performance-Probleme zu vermeiden.
Wie Sie sehen können, ist die Überwachung der Anwendungsperformance sehr wichtig und muss regelmäßig durchgeführt werden. Es gibt verschiedene Lösungen zur Leistungsverwaltung, mit denen dieser Prozess effizienter gestaltet werden kann. Die heutige Welt ist von Apps abhängig, daher ist die Überwachung der Anwendungsperformance für den Erfolg Ihres Unternehmens unerlässlich.
Wollen Sie schöne Web-Software erstellen?
Hier ist, wie wir Ihnen helfen können
Über den Autor