
Bei Yalantis arbeiten wir täglich mit verschiedenen Arten von mobilen und webbasierten Services – Entwicklung der Unternehmensgesundheitsversorgung, Digitale Banklösungen, IoT, Und andere. Obwohl sie hinsichtlich der bereitgestellten Funktionen unterschiedlich sein mögen, haben diese Apps eines gemeinsam – sie alle verfügen über eine Client-Server-Architektur, was bedeutet, dass sie ständig über das Internet mit Servern kommunizieren.
RESTful-APIs sind zum Hauptstandard geworden, um die Kommunikation zwischen dem Server-Bereich eines Produkts und seinen Clients, sowohl im Web als auch auf mobilen Geräten, zu ermöglichen. Deshalb ist das Design klarer und reibungsloser RESTful-APIs ein heißes Thema.
Wir erkennen die Bedeutung umfassender und schön gestalteter APIs an. Ihre API sollte idealerweise verschiedene Clienttypen unterstützen und von jedem Entwickler leicht verständlich sein. Die Qualität Ihres Projekts hängt davon ab.
Ein praktisches Beispiel für den Nutzen, den die REST-API für ein komplexes Produkt bieten kann, ist eine Kommunikationsplattform, die wir für KPMG, ein Big-Four-Rechnungswesenunternehmen. Eine einfache Integration brachte das System auf die nächste Stufe, indem es möglich wurde, Fotos und Audiodateien zu Benutzernachrichten hinzuzufügen, und half außerdem bei der Verwaltung der Benutzerautorisierung, der Sitzung und der Profildaten.
Was sollten Sie bei der Entwicklung einer API beachten? Wir haben die besten Praktiken zusammengestellt, die Ihnen helfen, die wichtigsten Probleme bei der API-Entwicklung zu vermeiden, wie z. B. schlecht geschriebene Dokumentation, unstrukturierte Architektur, Inkonsequenz, schlechte Sicherheit und Strenge.
Dokumentation
Die Dokumentation ist eine Einführung in die API, die Entwicklern dabei hilft, Ihre API zu verstehen und ihnen einen Hinweis darauf gibt, wo sie beginnen können. Um beispielsweise eine effektive Prototypisierung der Benutzeroberfläche Ihrer API durchzuführen, sollten Sie sich vielleicht an die Erstellung von Prototyp in Prinzip verwandeln, Dies ermöglicht es Ihnen, statische Designs in interaktive Mockups zu verwandeln. Durch die Dokumentation Ihrer API erhöhen Sie das Bewusstsein und die Akzeptanz der API und verkürzen Sie die Zeit und die Kosten für die Einführung sowohl von externen als auch internen Entwicklern. Darüber hinaus hilft die Dokumentation Ihren internen Teams dabei, die Details Ihrer Methoden, Ressourcen, Anfragen und Antworten zu kennen, wodurch die Wartung und Aktualisierungen einfacher und schneller werden. Unternehmen für Datenwissenschaftsdienstleistungen, Zum Beispiel könnte eine gut dokumentierte API, die eine nahtlose Integration und Datenfreigabe über verschiedene Systeme ermöglicht, großen Nutzen bieten.
Idealerweise sollten Sie prägnante Tutorials schreiben, um Entwicklern zu helfen, schnell loszulegen. Verpassen Sie nicht die Erstellung eines Glossars, in dem Sie Begriffe definieren, die in Ihrer API verwendet werden. Definieren Sie die in Ihrem Projekt verwendeten Ressourcen und Methoden so, dass sie verständlich sind. Stellen Sie sicher, alle in Ihrem Projekt verwendeten Begriffe aufzuführen und alle Beteiligten auf die gleiche Seite zu bringen, damit Ihre Endnutzer (Entwickler) die Begriffe für URLs und URIs verstehen können, zum Beispiel auch dann, wenn sie die Technologie dahinter nicht vollständig verstehen. LinkedIn hat eine separater Seiteninhalt mit der in ihrer API verwendeten Terminologie.
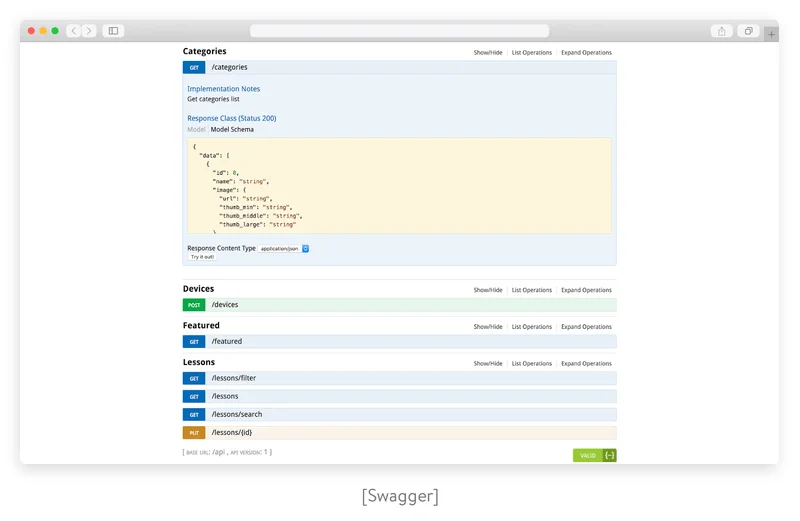
Glücklicherweise gibt es viele Software-Tools (Swagger, Raml, Apiary usw.), die die Aufgabe der Dokumentation vereinfachen.
Unterstützte Datentypen
In der Client-Server-Architektur ist eine API eine Brücke, die den Client mit dem Server verbindet. Daher sollte Ihre API Informationen in einem für beide Parteien komfortablen und verständlichen Format senden und empfangen. Ihre Auswahl des Datenformats bestimmt, wie effektiv Ihre API funktionieren wird und beeinflusst den Erfolg routinemäßiger und spezifischer Anrufe.
Gängige Datenformate, die in modernen APIs verwendet werden, sind:
- Direkte Datenformate. Sie sind dazu ausgelegt, Daten für die direkte Verwendung in anderen Systemen (Benutzern) zu verarbeiten. Sie eignen sich am besten für die Interaktion mit anderen APIs und für die Integration von Maschinen zu Maschinen. Die drei häufigsten direkten Datenformate sind JSON, XML und YAML.
- Fütterungsdatenformate. Formate dieser Art werden typischerweise verwendet, um Aktualisierungen von Servern, Websites und Frontend-Schnittstellen zu serialisieren und Anwender über diese Änderungen zu informieren. Feed-Datenformate – darunter RSS, Atom und SUP – eignen sich am besten für Blogs, Videodienste und soziale Medien.
- Datenformate in Datenbanken. Diese Formate werden in der Regel zur Kommunikation zwischen Datenbanken und zwischen Datenbanken und Benutzern verwendet. Zu den Formaten in dieser Kategorie gehören CSV und SQL.
Einheitliche Ressourcenidentifikatoren
Die zentrale Idee von REST besteht darin, Ihre API in logische Ressourcen aufzuteilen. Ein Uniform Resource Identifier, oder auch einfach als URI bezeichnet, ist eine Zeichenfolge, die eine Ressource identifiziert und Entwicklern oft die Möglichkeit gibt, Zugriff auf die Repräsentationen dieser Ressource zu erhalten. Die aktuelle Struktur und Syntax von URIs wird von der RFC 3986-Standard.
Zu diesem Punkt können wir die immer wiederkehrende Frage nicht umgehen: Was sind die Unterschiede zwischen einem URI und einer URL? Tatsächlich sind sowohl eine URL (Uniform Resource Locator) als auch eine URN (Uniform Resource Name) eine Art von URI.
Eine URL gibt die Position einer bestimmten Ressource sowie die Möglichkeit an, wie sie abgerufen werden kann an: http://example.com/example.html
Ein URN identifiziert die Ressource anhand ihres Namens, zeigt jedoch nicht unbedingt deren Standort an. Er beginnt oft mit dem Präfix „urn:“, z. B.: urn:uuid:6e7bc280-7c3a-11d9-9889-0800200c9a66

Ihre URI sollte das Ressourcenmodell der API klar kommunizieren. Wir haben einige Regeln zusammengestellt, um Ihnen dabei zu helfen, klare und schöne URIs zu entwerfen:
- Verwenden Sie Bindestriche, aber keine Unterstrichzeichen, um Ihre URI lesbar zu machen. Das ist eine gute Praxis:
http://api.example.com/best-products/home-decor. Das ist eine schlechte Praxis:http://api.example.com/best_products/home_decor/. Unterstriche sind aufgrund der Unterstreichung fast unsichtbar und können Verwirrung verursachen. - Ergänzungen sollten in URIs nicht enthalten sein. Die Bestimmung des Inhaltstyps im Körperteil lässt man dem Header „Content-Type“ überlassen.
- Verwenden Sie, sofern möglich, Kleinbuchstaben. Beachten Sie, dass alle URI-Komponenten, mit Ausnahme der Hostkomponenten und des Skemamaterials, bei Groß- und Kleinschreibung unterschiedlich geschrieben werden. Das bedeutet, dass
http://api.example.com/best-products/home-decorundhttp://API.EXAMPLE.COM/best-products/home-decorsind identisch. Aberhttp://api.example.com/My-Folder/my-docist eine völlig andere URI. - Verwenden Sie ein Trennzeichen (/) um Beziehungen anzuzeigen. Vermeiden Sie das Verwenden eines Rücktrichters (/) da dies Verwirrung verursachen kann. Einige APIs führen die Benutzer einfach auf eine URI ohne Trennzeichen um, andere senden stattdessen die 301: Moved Permanently-Antwort.
- Im Allgemeinen verfügt jede Ressource Ihrer API über mindestens eine URI. Daher sollte jede URI die Ressource angemessen beschreiben und eine vorhersehbare, hierarchische Struktur aufweisen, um die Benutzerfreundlichkeit zu verbessern.
Endpunkte
Endpunkte geben an, wo Ressourcen liegen und wie sie von Drittsoftware abgerufen werden können. In der Regel werden sie über eine URI abgerufen, auf die HTTP-Anfragen gesendet werden und von der die Antwort erwartet wird.
Wenn Sie nach ‘Was ist eine RESTful API?’ suchen, finden Sie die folgende Definition: eine Anwendungsprogrammierschnittstelle, die HTTP-Anfragen verwendet, um Daten zu empfangen, zu senden, zu posten und zu löschen. Was sind also GET, PUT, POST, DELTE und warum sind diese großgeschrieben? Dies sind die wichtigsten Methoden, die anzeigt, welche Art von Operation durchgeführt werden soll. Lassen Sie uns genauer darauf eingehen:
- GET – Erhalt von Ressourcen vom Server unter Verwendung einer bestimmten URI
- POST – Ressourcen an den Server senden
- PUT – Aktualisierung bestehender Informationen mit hochgeladenem Inhalt
- DELETE – alle vorhandenen Ressourcen entfernen
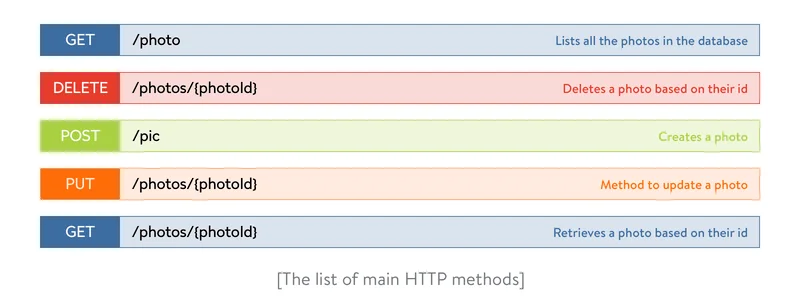
Wie bei URIs ist die Namensbestimmung von Ressourcenendpunkten für die Benutzerfreundlichkeit der API entscheidend. Hier sind einige Tipps zur Namensbestimmung von Endpunkten:
- Verwenden Sie bei der Namensgebung Ihrer Ressourcenpfad-Verknüpfung Nomen (nicht Verben); in unserem Fall sollten wir den Pfad „Photos“ nennen. Die folgenden Ressourcennamen sollten strikt vermieden werden: /getAllPhotos, /createPhoto, /updatePhoto, /deletePhoto.
- Verwechselen Sie keine Singular- und Pluralnamen nicht. Obwohl es möglicherweise falsch erscheint, eine einzelne Ressource in einer Pluralform zu beschreiben, legen die Designregeln der API vor, dass man konsequent sein sollte und für alle Ressourcen immer Pluralnamen verwendet. Verwenden
/EinstellungenStattdessen/Einstellungenund/ProdukteStattdessen/product. - Verwenden Sie Unterressourcen für Beziehungen, wenn eine Ressource mit einer anderen Ressource verknüpft ist. Beispielsweise:,
GET /products/:id/reviewsgibt eine Liste der Bewertungen für ein bestimmtes Produkt zurück, undGET /products/:id/reviews/:idGibt eine bestimmte Bewertung für ein bestimmtes Produkt zurück.
Versionierung
API-Schnittstellen ändern sich langsam, aber sie ändern sich dennoch. Lass uns das klarstellen: Auch wenn Ihre API vollständig neu geschrieben und mehrmals aktualisiert wird, sollten Sie die alten Versionen Ihrer API so lange weiterbetreiben und unterstützen, wie lange Ihre Benutzer sie benötigen. Es gibt vier gängige Möglichkeiten, eine API zu verifizieren, sodass Benutzer weiterhin auf die früheren Versionen zurückgreifen und erst dann auf die nachfolgenden Versionen upgraden können, wenn sie bereit sind:
- URI. Mit dieser Methode wird eine Version explizit in die URI der API aufgenommen. (Beispiel:
api.example.com/v1/resource oder example.com/api/v1/resource) - Eigene Anforderungshäufigkeiten. APIs können auch mit eigenen Header versehen werden, indem die Versionsnummer als Attribut angegeben wird. (Beispiel:
curl -H “API-Version: 1.0” http://www.example.com/api/products) - Versionierung des Medietyps (auch bekannt als Inhaltsverhandlung oder Accept-Header). In diesem Fall ändern Sie den Accept-Header, um die Version anzugeben. (Beispiel:
curl -H “Accept: application/vnd.example.v2+json” http://www.example.com/api/products) - Parameter-Versionierung. Eine weitere Möglichkeit besteht darin, die Versionsnummer als Abfrageparameter einzufügen. (Beispiel:
http://www.example.com/api/products?version=1)
Sicherheit & Authentifizierung
Schützen Sie stets die Anwendungsdaten vor Hackern und anderen unsicheren Nutzern. Hier sind einige wichtige Regeln zur Sicherstellung der Sicherheit während der Backend-Entwicklung:
- Verwenden Sie HTTPS. Eine sichere REST-API sollte nur HTTPS-Endpunkte bereitstellen. Dies ist eine gute Möglichkeit, Authentifizierungsdaten wie API-Schlüssel, Passwörter und JSON Web Tokens (JWT).
- Ergänzen Sie HTTP-Anforderungen mit einer Zeitmarke. Neben anderen Parametern sollten Sie eine Zeitmarke für Ihre Anfrage angeben. Auf diese Weise kann der Server die Zeitmarke der Anfrage mit der aktuellen Zeitmarke vergleichen und die Anfrage nur innerhalb eines bestimmten Zeitraums akzeptieren, beispielsweise einer oder zwei Minuten. Auf diese Weise werden Wiederholungsangriffe von Hackern, die versuchen, das System mit brutalen Methoden zu hacken, eliminiert.
- HTTP-Methoden einschränken. Erstellen Sie eine Liste der zulässigen Methoden und verwerfen Sie alle Anfragen, die nicht in dieser Liste enthalten sind. Außerdem stellen Sie sicher, dass der Anrufer die Berechtigung hat, die eingehende HTTP-Methoden auf der Ressource zu verwenden.
- Denken Sie an die Eingabevalidierung. Validieren Sie die Anforderungsparameter bereits in der ersten Stufe. Implementieren Sie robuste Validierungsprüfungen und verwerfen Sie eine Anfrage sofort, wenn die Validierung fehlschlägt. Validieren Sie die Eingabeart, die Länge, den Formattyp und den Bereich.
- Verwenden Sie OAuth. Obwohl die grundlegende Authentifizierung ausreichend sicher ist, sollten Sie OAuth in Betracht ziehen. Das OAuth 2.0-Autorisierungsframework ermöglicht es Drittanbieter-Apps, einen begrenzten Zugriff auf einen HTTP-Dienst zu erhalten – entweder im Auftrag des Ressourceninhabers, indem sie eine Genehmigungsinteraktion zwischen dem Ressourceninhaber und dem HTTP-Dienst orchestrieren, oder indem sie der Drittanbieter-Anwendung die Möglichkeit eingeräumt werden, selbst Zugriff zu erlangen.
- Veröffentlichen Sie keine sensiblen Daten in URLs. Benutzernamen, Passwörter, JWT und API-Schlüssel sollten niemals in einer URL enthalten sein. Falls dies dennoch der Fall ist, können sie in den Protokolldateien des Webservers gespeichert werden und somit leicht ausgenutzt werden.
- Durchführen von Sicherheitskontrollen. Erstellen Sie eine Sicherheitsliste, um die Wahrscheinlichkeit von SQL- und XSS-Angriffen zu minimieren: schützen Sie Kopfzeilen, Sitzungen und Cookies und erlauben Sie die Eingabe von Parametern; verbergen Sie sensible Daten in Protokollen; verwenden Sie CSRF-Tokens; validieren Sie Umleitungen und Weiterleitungen; implementieren Sie eine starke Sicherheitsprüfung von Passwörtern; schützen Sie Datenbanken usw. Um diese Aufgaben zu vereinfachen, können Sie automatisierte Tools wie Brakeman verwenden.
Unternehmen nutzen APIs, um Dienste zu verbinden und Daten zu übertragen. Beschädigte, ungeschützte oder gehackte APIs sind die Ursache für große Datendiebstähle. Eine schlecht gesicherte API kann für ein Unternehmen riskant sein, weshalb Entwickler sie nicht verwenden möchten.
Lesen Sie auch: Sichere Anwendungsentwicklung: Von der Planung bis zur Produktion
Skalierbarkeit und Flexibilität
Skalierbarkeit ist die Fähigkeit des Systems, eine wachsende Anzahl von Anfragen schnell und stabil zu verarbeiten oder die Möglichkeit, das System zu erweitern, um dem Wachstum gerecht zu werden. Dies ist eine wichtige Überlegung für alle API-Plattformen.
Es gibt zwei Arten von Skalierbarkeit: vertikale Skalierung (Verwendung einer leistungsfähigeren Maschine) und horizontale Skalierung (Verteilung der Last auf mehrere Maschinen). Wenn eine Cloud verwendet wird, kann sie das System automatisch skalieren. Vor der Konzeption eines Systems sollten Sie dessen geschätzte Belastung (Anfragen pro Sekunde, Größe der Anfragen usw.) ermitteln. Während der Betriebsdauer des Systems sollten Sie dann verschiedene Kennzahlen wie die Lastverteilung, die Latenz und die Antwortzeit überprüfen.
Entwerfen Sie Ihre API so, dass Skalierbarkeit im Hinterkopf berücksichtigt wird. Auf diese Weise können Sie bei einer zunehmenden Anwendung problemlos neue Funktionen hinzufügen und die Performance verbessern. Um dies zu erreichen, halten Sie die Architektur einfach.
Um Skalierbarkeitsprobleme zu lösen, ist es empfehlenswert, eine Cloud zu nutzen. Cloud-Services ermöglichen es, auf Anfrage schnell neue Serverinstanzen zu starten, anstatt kostspielige Hardware zu kaufen, um mehr Daten verarbeiten zu können.
Außerdem ist es wichtig, manuelle Codeoptimierungen durchzuführen, bei denen der Code manuell analysiert wird, um schlecht performende Teile zu identifizieren und sie zu optimieren.
Überwachung und Fehlerbehandlung
Die Überwachung der Echtzeit-Trends in Bezug auf API-Zugriffe und -Verbrauch ist unerlässlich. Es ist wichtig, die Fehlerbehandlung unter Kontrolle zu haben, damit Sie wichtige Informationen bereitstellen können, die den API-Kunden ermöglichen, zu wissen, was auf dem Server passiert.
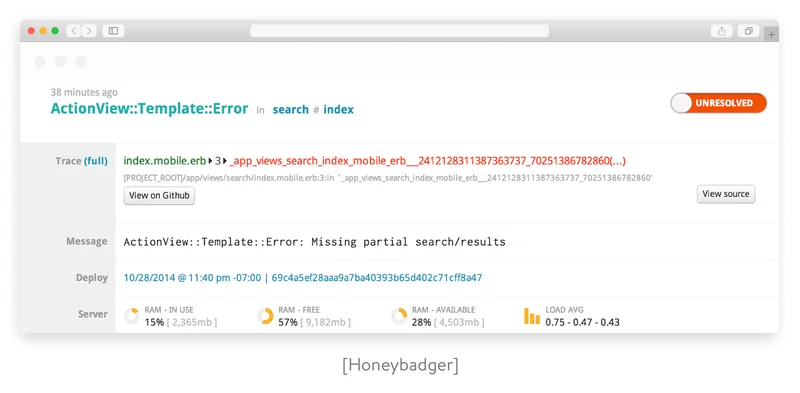
Alle Ausnahmen sollten in einer Fehler-Payload angegeben werden. In der Regel ist es wichtig zu erklären, woher der Fehler kommt. Es ist außerdem wichtig, einige Anweisungen darüber zu geben, wie man einen fehlerhaften Aufruf beheben kann. Wenn Sie Ihre API mithilfe von Ruby on Rails erstellen, können Sie die exception_notification gem ermöglicht es Ihnen, die am häufigsten verwendeten Benachrichtigungskanäle wie E-Mail, Slack und WebHooks schnell einzurichten. Wenn Sie Statistiken anzeigen möchten, können Sie Drittanbieter-Dienste wie Honeybadger, Sentry und NewRelic verwenden.
HTTP-Statuscodes
HTTP-Statuscodes, die manchmal auch als Internet- oder Browserfehlercodes bezeichnet werden, sind Standardantwortcodes, die von einem Webserver gesendet werden und die besagen, ob eine durchgeführte Aktion erfolgreich war oder warum Seiten oder Ressourcen nicht ordnungsgemäß geladen werden. Sie helfen auch Entwicklern bei der Fehlerbehebung und der Fehlerbehandlung.
Es gibt fünf Kategorien von Antworten und mehr als fünfzig Antwortcodes. Wir haben eine Liste der am häufigsten verwendeten Codes erstellt:
2XX (Erfolg)
200: Okay. Dies ist die am häufigsten verwendete Antwort, um zu informieren, dass ein Anforderungseingang erfolgreich war.
201: Objekt erstellt. Der Server hat die Anfrage erfüllt und eine neue Ressource erstellt.
204: Kein Inhalt. Der Server hat den Anforderung erfolgreich erfüllt und die API verzichtet auf die Rücksendung einer Statusmeldung oder einer Darstellung in dem Antworttext.
206: Teilinhalt. Der Server hat die Anfrage erfüllt und der Body enthält die angeforderten Datenbereiche, wie in der Range-Header-Information der Anfrage beschrieben.
3XX (Weiterleitung)
304: Keine Änderung. Der Client hat die Zwischenspeicherung angefordert und es besteht keine Notwendigkeit, sie erneut zu übertragen.
4XX (Fehler beim Client)
400: Fehlerhafte Anforderung. Der Server konnte die Anforderung aufgrund einer ungültigen Syntax nicht verstehen (z. B. ungültige Anforderungsmeldungsrahmen oder irreführende Anforderungsrouting).
401: Nicht autorisiert. Der Benutzer oder das System versucht, auf einer geschützten Ressource zu arbeiten, ohne entsprechende Authentifizierungsangaben anzugeben.
403: Verboten. Der Server versteht den Request, weigert sich jedoch, ihn zu autorisieren.
404: Nicht gefunden. Der Ursprungsserver kann keine aktuelle Darstellung der Zielressource finden oder ist nicht bereit, diese zu offenlegen.
5XX (Serverfehler)
500: Interne Serverfehler. Idealerweise sollten Sie diese Fehlermeldung nicht ausdrücklich zurückgeben, aber falls etwas unerwartet fehlschlägt, wird der Benutzer genau diese Fehlermeldung erhalten.
503: Dienstleistung nicht verfügbar. Der Server kann die Anfrage derzeit aufgrund einer vorübergehenden Überlastung oder einer geplanten Wartung nicht verarbeiten.
Dies sind Standard-Statuscodes, die jedoch erweiterbar sind. Wenn Sie benutzerdefinierte HTTP-Antwortcodes erstellen, stellen Sie sicher, dass diese in der richtigen Kategorie eingetragen sind. Denken Sie daran, dass dies nicht als gute Praxis gilt, da einige Proxys unbekannte Codes filtern. Ob Sie benutzerdefinierte oder standardmäßige Codes erstellen, dokumentieren Sie diese immer. Hier ist ein Beispiel für Statuscodes: Twitter-API-Dokumentation.
Testen, Stabilität und Support
Verwenden Sie immer Testwerkzeuge, um Endpunkte einfach zu testen und deren Antworten zu überprüfen. Es gibt eine Reihe von Tools, mit denen Sie die Testroutine automatisieren können: Rspec, API Fortress, API Science, Parasoft, Postman, SmartBear, Runscope usw.
Verwaltungskomplexität
Nach einer erfolgreichen Implementierung folgt eine kontinuierliche Wartung und Unterstützung. Dazu gehört die Betriebssicherheit des Systems, die Untersuchung von Fehlern, die Behebung von Bugs und die Einführung neuer Funktionen.
Die Funktionsfähigkeit des Systems erfordert Folgendes:
- Patch- und Fix-Anwendungen
- Planungsfähigkeit
- Verbesserung der Konfigurationsverwaltung
- Die Wissensbasis zum System zu erhalten
Die Einführung neuer Funktionen erfordert eine einfache Anpassung an Änderungen. Dies ist eng mit der Einfachheit und Abstraktion des Systems verbunden. Einfache und verständliche Systeme sind einfach zu modifizieren.
Caching
Caching dient dazu, häufig (oder zuletzt) angefragte Daten in einer Speicherlösung mit schneller Zugriffstemperatur (in der RAM-Speicher oder außerhalb davon) zu speichern, um eine Anfrage schnell zu erfüllen. Mithilfe von HTTP-Headern gibt ein Ursprungsserver an, ob eine Antwort in Form eines Caches gespeichert werden kann und, falls ja, von wem und für wie lange.
In der Regel behandeln Browser alle GET-Anforderungen als cachefähig. POST-Anforderungen sind standardmäßig nicht cachefähig, können jedoch durch Hinzufügen einer Expires- oder einer Cache-Control-Header an die Antwort zu cachefähig gemacht werden. Antworten auf PUT- und DELETE-Anforderungen sind nicht cachefähig.
Es gibt vier Haupt-HTTP-Response-Header, mit denen wir das Cachingverhalten steuern können:
-
Verlängert sich
Der HTTP-Header Expires legt eine absolute Ablaufzeit für eine abgelegte Darstellung fest. Nach Ablauf dieser Zeit gilt die abgelegte Darstellung als veraltet und muss erneut von dem Ursprungsserver validiert werden. Um anzuzeigen, dass eine Darstellung niemals abläuft, kann ein Dienst eine Zeitspanne von bis zu einem Jahr in der Zukunft angeben.
-
Cache-Control
Der Headerwert besteht aus einem oder mehreren kommas getrennten Anweisungen. Diese Anweisungen legen fest, ob eine Antwort in die Zwischenspeicherung aufgenommen werden kann und falls ja, von wem und für wie lange. Verfügbare Anweisungen:
– public – Dies bedeutet, dass eine Ressource von jeder Komponente komprimiert werden kann.
– private – Dies bedeutet, dass eine Ressource nur vom Client und dem Server cachefähig ist (kein Zwischenspeicher kann die Ressource cachen).
– no-cache/no-store – Dies bedeutet, dass eine Ressource nicht als Cache-Speicher nutzbar ist.
– max-age – Indiziert, dass die abgelegten Daten bis zu max-age in Sekunden gültig sind. Danach muss der Client eine weitere Anfrage stellen.
– s-max-age – Übertritt max-age für einen gemeinsamen Cache, wie z. B. auf Proxy-Servern. Man hat normalerweise mehr Kontrolle über den Proxy-Cache als über den lokalen Cache des Clients, daher kann man hier längere Werte hinzufügen.
– muss erneut validiert werden – Befehlt dem Server, die Ressource erneut zu validieren, wenn der max-age-Wert überschritten ist.
Beispiel: `Cache-Control: max-age=3600`
Cachefähige Antworten (ob für eine GET- oder eine POST-Anforderung) sollten außerdem einen Validator enthalten: entweder ein ETag oder eine Last-Modified-Header-Information.
-
ETag
Ein ETag-Wert ist ein unsichtbarer Zeichenketten-Token, den ein Server einer Ressource zuweist, um den Status dieser Ressource über ihren gesamten Lebenszyklus eindeutig zu identifizieren. Wenn die Ressource sich ändert, ändert sich der ETag entsprechend. Beispiel: `ETag: "abcd1234567n34jv"`
-
Letzte Änderung
Während der Date-Header einer Antwort angibt, wann die Antwort erstellt wurde, gibt der Last-Modified-Header an, wann die zugehörige Ressource zuletzt selbst geändert wurde. Der Last-Modified-Wert darf nicht später als der Date-Wert sein.
Außerdem ist es eine gute Idee, Cache-Schichten nicht nur in HTTP zu verwenden, sondern auch in dem gesamten Request-Processing-Pipeline (memcached, Redis, Cassandra).
Suchen, Filtern und Sortieren
Komplexe Ergebnisfilter, Sortieranforderungen und erweiterte Suchfunktionen lassen sich problemlos als Anfrageparameter über die Basis-URL implementieren und vereinfachen so das Leben der Entwickler erheblich.
Um eine Datenset zu filtern, legen Sie über die Query-Sprache einen eindeutigen Anfrageparameter für alle Felder fest. URL-Parameter sind die einfachste Möglichkeit, grundlegende Filterungseinstellungen in REST-APIs zu implementieren. Beispielsweise:
GET /dogs?breed=Akita&age<=2
Um Elemente zu sortieren, verwenden Sie den Parameter sortURL. Um komplexe Sortieranforderungen zu ermöglichen, lassen Sie den Parameter sortURL eine Liste von Klammern getrennten Feldern enthalten, wobei ein ungarischer Negativwert möglich ist, um eine absteigende Sortierreihenfolge zu ermöglichen. Beispielsweise:
GET /dogs?sort=-breed,+name oder GET /dogs?sort=breed_desc,name_asc
Manchmal reichen grundlegende Filter nicht aus und man benötigt die Leistungsfähigkeit einer vollständigen Textsuche. Wenn Sie eine Suche über Endpunkte benötigen, können Sie Unterstützung für Filter und Bereiche direkt mit dem Suchparameter hinzufügen. Sie können ElasticSearch oder eine andere Lucene-basierte Suchtechnologie verwenden.
Seitenumbrüche
Um Ihre Server glücklich zu machen, muss die API die angeforderten Elemente automatisch in Seiten teilen. Wenn das Datenvolumen zu groß ist, kann man es in kleinere Teile aufteilen. Dies verbessert die Performance und erleichtert die Verarbeitung der Antworten. Vergrößern Sie die Flexibilität der Seitenteilung, indem Sie per Seite separate Parameter unterstützen.
GET /dogs?page=3&per_page=20
Bei der Erstellung einer API muss man ständig daran denken, dass sie nur dann genutzt wird, wenn sie gut gestaltet, dokumentiert und unterstützt ist. Das Design einer API muss sich daher auf eine Mischung aus Funktionalität, Benutzerfreundlichkeit und Entwicklerfreundlichkeit konzentrieren. Wir hoffen, dass dieser Tutorial Ihnen dabei helfen wird, eine für Entwicklerfreundliche API zu erstellen. Wenn Sie Fragen haben oder Hilfe bei der Erstellung Ihrer API benötigen, können Sie sich jederzeit auf uns verlassen.
Erfahren Sie, wie wir maßgeschneiderte Software für Unternehmen entwickeln.
Und erwägen Sie eine Zusammenarbeit mit Yalantis
Über den Autor