Maschinelles Lernen wird seit Jahren eingesetzt, um Bilderkennung, Spam-Erkennung, natürliche Sprachverarbeitung, Produktempfehlungen und medizinische Diagnosen zu bieten. Heute können maschinelle Lernalgorithmen uns dabei helfen, die Cybersicherheit zu verbessern, die öffentliche Sicherheit zu gewährleisten und die medizinischen Ergebnisse zu verbessern.Entwicklung von achine Learning-Lösungen Es kann auch den Kundenservice verbessern und die Sicherheit der Fahrzeuge erhöhen.
Als ich mit dem Experimentieren mit maschinellem Lernen als Dienst begonnen habe, wollte ich eine Anwendung entwickeln, die ein reales Problem lösen würde, aber nicht zu kompliziert implementieren sei. Außerdem wollte ich an Regressionalgorithmen arbeiten. Also begann ich, nach einem Problem zu suchen, das eine Lösung wert war. Hier ist, was ich dabei herausfand.
Wenn Sie ein Haus verkaufen möchten, müssen Sie wissen, welchen Preis Sie dafür veranschlagen sollten. Und ein Computeralgorithmus kann Ihnen eine genaue Schätzung liefern!
In diesem Artikel zeige ich Ihnen, wie ich einen Regressionsalgorithmus geschrieben habe, um die Hauspreise vorherzusagen.
Möchten Sie Preise, Nachfrage oder andere wichtige Kennzahlen für Ihr Unternehmen vorhersagen? Lassen Sie uns ein maßgeschneidertes maschinelles Lernmodell für Sie entwickeln.
Regression in aller Kürze
Kurz gesagt, Regression ist ein Werkzeug der maschinellen Lernanalyse, das Ihnen hilft, Prognosen zu erstellen, indem sie – anhand der vorhandenen statistischen Daten – die Beziehungen zwischen Ihrem Zielparameter und einer Reihe anderer Parameter lernen. Nach dieser Definition hängt der Preis eines Hauses von Parametern wie der Anzahl der Schlafzimmer, der Wohnfläche, der Lage usw. ab. Wenn wir künstlicher Lernprozesse auf diese Parameter anwenden, können wir die Immobilienbewertungen für einen bestimmten geografischen Bereich berechnen.
Die Idee der Regression ist ziemlich einfach: Mit genügend Daten können Sie das Verhältnis zwischen Ihrem Zielparameter (dem Ergebnis) und anderen Parametern (den Eingaben) beobachten und diese Beziehung dann auf reale beobachtete Daten anwenden.
Um Ihnen zu zeigen, wie der Regressionsalgorithmus funktioniert, berücksichtigen wir nur einen Parameter – den Wohnbereich eines Hauses – um den Preis vorherzusagen. Es ist logisch anzunehmen, dass es eine lineare Beziehung zwischen Fläche und Preis gibt. Und wie wir aus der Schule noch wissen, wird eine lineare Beziehung durch eine lineare Gleichung dargestellt:
y = k0 + k1 * x
In unserem Fall, y Gleiche Preis und x Gleiche Fläche. Die Preisprognose für ein Haus ist so einfach wie die Lösung der Gleichung (wo k0 und k1 sind konstante Koeffizienten):
Preis = k0 + k1 * Fläche
Wir können diese Koeffizienten berechnen (k0 und k1) Mit Hilfe der Regressionsanalyse. Angenommen, wir haben in einem bestimmten Gebiet 1000 bekannte Hauspreise. Mit Hilfe einer Lernmethode können wir eine Reihe von Koeffizientenwerten ermitteln. Sobald diese gefunden sind, können wir die entsprechenden Flächenwerte einfügen, um den erreichten Preis vorherzusagen.
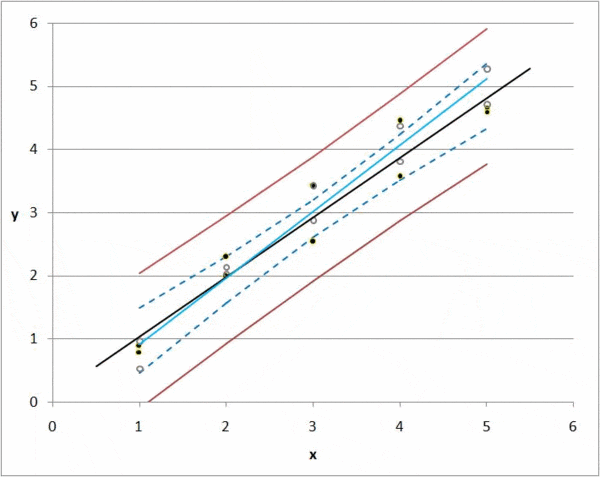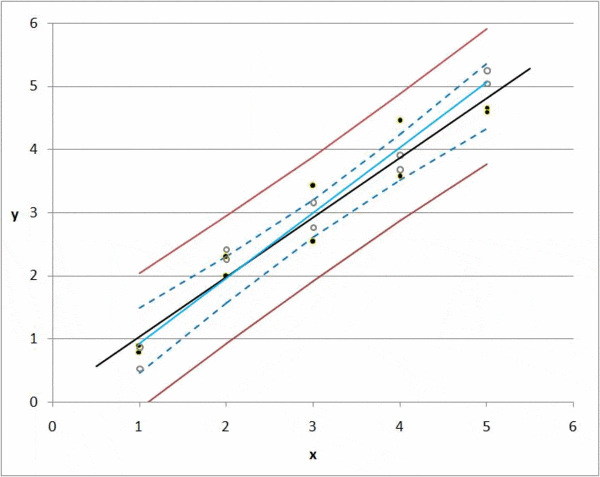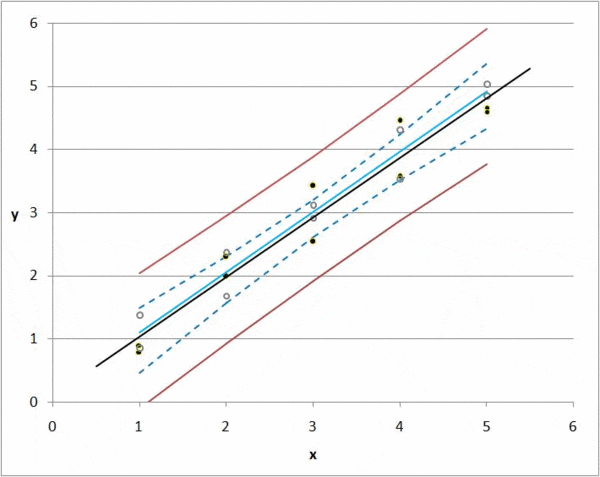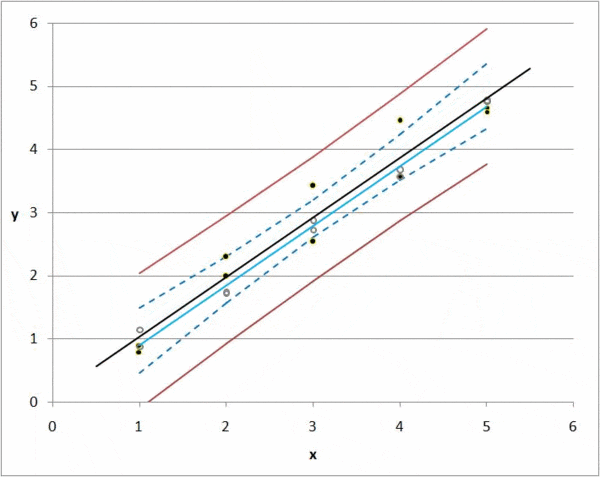
Aber es gibt immer eine Abweichung oder einen Unterschied zwischen einem vorhergesagten Wert und einem tatsächlichen Wert. Wenn wir 1000 Beobachtungen haben, können wir die Gesamtausdehnung aller Elemente berechnen, indem wir die Abweichungen für jeden addieren. k0 und k1 Kombination.
Regression erfasst alle möglichen Werte für k0 und k1 und minimiert die Gesamtdifferenz; das ist im Kern die Idee der Regression.
In der Realität gibt es jedoch weitere Herausforderungen, mit denen man umgehen muss. Die Immobilienpreise hängen natürlich von mehreren Faktoren ab, und es gibt keine klare lineare Beziehung zwischen all diesen Parametern. Um solche komplexen Probleme anzugehen, setzen Unternehmen oft auf Experten. KI-Beratung um maßgeschneiderte Lösungen zu entwickeln, die auf die spezifischen Herausforderungen ihrer Datenanforderungen zugeschnitten sind.
Nun werde ich Ihnen erzählen, wie ich Regressionalgorithmen eingesetzt habe, um die Hauspreise für mein Projekt zu prognostizieren.
Wie man Regressionsalgorithmen in der Maschinellen Lernanalyse verwendet
1. Datenerhebung
Der erste Schritt bei jeder Art von maschinellen Lernanalysen besteht darin, Daten zu sammeln – die unbedingt gültig sein müssen. Um präzise Prognosen zu gewährleisten, arbeiten viele Organisationen mit spezialisierten Partnern zusammen. Entwicklungsdienstleistungen für maschinelles Lernen Dies rationalisiert die Datenvorbereitung und die Modellentwicklung. Wenn Sie die Gültigkeit Ihrer Daten nicht garantieren können, ist eine Analyse der Daten sinnlos. Sie müssen auf die Quelle achten, aus der Sie Ihre Daten beziehen.
Für meine Zwecke habe ich auf eine Datenbank eines der größten Immobilienportale in den Niederlanden zurückgegriffen. Da der Immobilienmarkt in den Niederlanden streng reguliert ist, musste ich deren Gültigkeit nicht überprüfen.
Ursprünglich musste ich einige Datenanalysen durchführen, da die benötigten Daten in verschiedenen Formaten aus mehreren Quellen verfügbar waren. In den meisten realen Projekten müssen Sie ebenfalls einige Datenanalysen durchführen. Wir werden dies nicht weiter erläutern. Datenmining-Dienste Hier ist es jedoch nicht wirklich relevant für unser Thema.
Im Rahmen dieses Artikels stellen wir uns vor, dass alle Immobiliendaten, die ich gefunden habe, im unten gezeigten Format vorliegen.
2. Datenanalyse
Sobald die Daten gesammelt wurden, ist es an der Zeit, sie zu analysieren. Nach der Analyse der Daten erhielt ich die folgenden Datensätze:
-
{ “has_garden” : 1, “year” : 1980, “lng” : 4.640685, “has_garage” : 0, “changes_count” : “2”, “area” : 127, “bedrooms_count” : “4”, “com_time” : 57, “price” : 305000, “energy_label” : 1, “lat” : 52.30177, “rooms_count” : “5”, “life_quality” : 6, “house_type” : 1, “is_leasehold” : 0 }
-
{ “has_garden” : 1, “year” : 1980, “lng” : 4.656503, “has_garage” : 0, “changes_count” : “3”, “area” : 106, “bedrooms_count” : “3”, “com_time” : 64, “price” : 275000, “energy_label” : 3, “lat” : 52.35456, “rooms_count” : “4”, “life_quality” : 5, “house_type” : 1, “is_leasehold” : 0 }
-
{ “has_garden” : 1, “year” : 1980, “lng” : 4.585596, “has_garage” : 0, “changes_count” : “3”, “area” : 106, “bedrooms_count” : “3”, “com_time” : 74, “price” : 244000, “energy_label” : 3, “lat” : 52.29309, “rooms_count” : “4”, “life_quality” : 6, “house_type” : 1, “is_leasehold” : 0 }
-
{ “has_garden” : 1, “year” : 1980, “lng” : 4.665817, “has_garage” : 0, “changes_count” : “2”, “area” : 102, “bedrooms_count” : “4”, “com_time” : 77, “price” : 199900, “energy_label” : 3, “lat” : 52.14919, “rooms_count” : “5”, “life_quality” : 6, “house_type” : 1, “is_leasehold” : 0 }
-
{ “has_garden” : 1, “year” : 1980, “lng” : 4.620336, “has_garage” : 0, “changes_count” : “1”, “area” : 171, “bedrooms_count” : “3”, “com_time” : 79, “price” : 319000, “energy_label” : 1, “lat” : 52.27822, “rooms_count” : “4”, “life_quality” : 6, “house_type” : 1, “is_leasehold” : 0 }
-
{ “has_garden” : 1, “year” : 1980, “lng” : 5.062804, “has_garage” : 1, “changes_count” : “1”, “area” : 139, “bedrooms_count” : “5”, “com_time” : 38, “price” : 265000, “energy_label” : 5, “lat” : 52.32992, “rooms_count” : “6”, “life_quality” : 7, “house_type” : 1, “is_leasehold” : 0 }
-
{ “has_garden” : 1, “year” : 1980, “lng” : 5.154957, “has_garage” : 1, “changes_count” : “2”, “area” : 129, “bedrooms_count” : “4”, “com_time” : 57, “price” : 309500, “energy_label” : 1, “lat” : 52.35634, “rooms_count” : “5”, “life_quality” : 6, “house_type” : 1, “is_leasehold” : 0 }
-
{ “has_garden” : 1, “year” : 1980, “lng” : 4.622486, “has_garage” : 0, “changes_count” : “1”, “area” : 125, “bedrooms_count” : “4”, “com_time” : 76, “price” : 289000, “energy_label” : 1, “lat” : 52.2818, “rooms_count” : “5”, “life_quality” : 6, “house_type” : 1, “is_leasehold” : 0 }
Hier ist die Bedeutung der Felder:
- has_garden – hat die Immobilie einen Garten? 1 – wahr, 0 – falsch
- Jahr – Baujahr
- lat, lng – Koordinaten der Lage des Hauses
- Bereich – Gesamtfläche des Wohnraums
- has_garage – hat das Anwesen eine Garage? 1 – wahr, 0 – falsch
- Schlafzimmer_anzahl – Anzahl der Schlafzimmer
- rooms_count – Gesamtanzahl der Zimmer
- energy_label – Energieeffizienz-Label (für jedes Haus in den Niederlanden vergeben)
- Lebensqualität – Qualitätsmarke für das Leben, die von den lokalen Behörden für jeden Bezirk berechnet wird
- house_type – Art des Objekts (1 – Haus, 0 – Wohnung)
- com_time – Fahrzeit zum Zentrum von Amsterdam
- changes_count – Änderungen im Transportplan gelten, wenn Sie mit öffentlichen Verkehrsmitteln ins Zentrum von Amsterdam fahren.
Ich ging davon aus, dass dies alle messbare Daten sind, die den Preis eines Hauses beeinflussen. Natürlich gibt es auch weitere Parameter, die eine Rolle spielen, wie zum Beispiel der Zustand und die Lage des Hauses. Aber diese Parameter sind eher subjektiv und kaum messbar, weshalb ich sie ignoriert habe.
3. Überprüfen Sie die Korrelation zwischen den Parametern
Nun müssen Sie nach starken Korrelationen zwischen den gegebenen Parametern suchen. Falls diese vorhanden sind, entfernen Sie einen der Parameter. In meinem Datensatz gab es keine starken Korrelationen zwischen den Werten.
4. Aussengewohnheiten aus der Datensammlung entfernen
Outlier sind Beobachtungspunkte, die sich von anderen Beobachtungen weit entfernt befinden. In meinen Daten gab es beispielsweise ein Haus mit einer Fläche von 50 Quadratmetern zu einem Preis von $500.000 Kronen. Solche Häuser können aus verschiedenen Gründen auf dem Markt existieren, aber sie sind statistisch nicht aussagekräftig. Ich möchte eine Preisvorhersage anhand des Marktdurchschnitts erstellen, und daher berücksichtige ich solche Outlier nicht.
Die meisten Regressionsmethoden erfordern ausdrücklich, dass Ausschnitte aus dem Datensatz entfernt werden, da diese die Ergebnisse erheblich beeinflussen können. Um die Ausschnitte zu entfernen, benutzte ich die folgende Funktion:
def get_outliners(Dataset, Outlier-Fraktion =0.25):
clf = svm.OneClassSVM(nu=0.95 * outliers_fraction + 0.05, kernel="rbf", gamma=0.1)
clf.fit(dataset) Ergebnis
= clf.predict(dataset)
zurück Ergebnis
Dies wird die Werte 1 für Ausreißer und 1 für Nicht-Ausreißer zurückgeben. Anschließend können Sie Folgendes tun:
training_dataset = full_dataset[get_outliners(full_dataset[analytics_fields_with_price], 0.15)==1]Danach haben Sie nur noch Beobachtungen ohne Ausreißer. Jetzt ist es an der Zeit, die Regressionsanalyse zu starten.
5. Wählen Sie einen Regressionsalgorithmus
Es gibt mehr als eine Möglichkeit, Regressionanalysen durchzuführen. Was wir suchen, ist die beste Vorhersagungsgüte unter Berücksichtigung unserer Daten. Aber wie können wir die Genauigkeit überprüfen? Eine gängige Methode ist die Berechnung einer sogenannten r^2 Ein Wert, der im Grunde die Differenz zwischen einem tatsächlichen Wert und einem prognostizierten Wert ist.
Es ist wichtig zu bedenken, dass unser Modell möglicherweise übertrainingen kann, wenn wir dasselbe Datenvolumen für das Lernen und die Überprüfung unserer Genauigkeit verwenden. Das bedeutet, dass es bei einem bestimmten Datensatz eine hervorragende Genauigkeit aufweist, aber bei der Bereitstellung neuer Daten völlig fehlschlägt.
Eine gängige Methode, um dieses Problem zu lösen, besteht darin, die ursprüngliche Datenbasis in zwei Teile aufzuteilen und dann eine für das Lernen und die andere für die Testung zu verwenden. Auf diese Weise simulieren wir neue Daten für unser Lernmodell und können eventuelle Übertrainingzustände erkennen.
Wir können unser Datensatz anhand eines Verhältnisses von 80/20 aufteilen. Wir verwenden 80% für das Training und die restlichen 20% für die Prüfung. Schauen wir uns diesen Code genauer an:
//Code zur Qualitätsbewertung von Algorithmen
aus sklearn Importieren svm
Importieren matplotlib.pyplot als plt
aus sklearn.neighbors Importieren KNN-Regler
aus sklearn.linear_model Importieren LinearRegression, LogisticRegression
aus sklearn.svm Importieren SVR
aus sklearn.metrics Importieren r2_score
aus sklearn.cross_validation Importieren train_test_split
aus sklearn.ensemble Importieren RandomForestRegressor
Importieren Pandas als pd

    #Dataset vorbereiten
    #....
    #verzerrender Datensatz
    Xtrn, Xtest, Ytrn, Ytest = train_test_split(training_dataset[analytics_fields], training_dataset[['preis'[],
                                                test_size=0.2)

    # model = RandomForestRegressor(n_estimators=150, max_features='sqrt', n_jobs=-1) # Zufälliger Wald
    Modelle = [LinearRegression(),
              RandomForestRegressor(n_estimators=100, max_features='sqrt'),
              KNNRegressor(n_neighbors=6),
              SVR (Kernel ='linear'),
              LogisticRegression()
              ]

    TestModels = pd.DataFrame()
    tmp = {}

    für Modell in Modelle:
        # Erhalte den Modellnamen
        m = str(model)
        tmp['Modell'] = m[:m.index('(')]
        # Passendes Modell auf Trainingsdatenbank
        model.fit(Xtrn, Ytrn['preis'])
        # Preise für das Testdatenpaar vorhersagen und r^2 berechnen
        tmp['R2_Price'] = r2_score(Ytest['preis'], model.predict(Xtest))
        # die erhaltenen Daten schreiben
        TestModels = TestModels.append([tmp])

    TestModels.set_index('Modell', inplace=Wahr)

    fig, axes = plt.subplots(columns=1, -10, 4))
    TestModels.R2_Price.plot(ax=axes, kind='bar', Titel='R2_Price')
    plt.show()
Infolgedessen habe ich den folgenden Graph erhalten:

Wie Sie sehen können, ist das Random Forest Regressor zeigte die beste Genauigkeit, weshalb wir uns für diesen Algorithmus für die Produktion entschieden haben.
Die Preisvorhersage in der Produktionsversion funktioniert fast genauso wie in unserem Testcode, mit dem Unterschied, dass es nicht erforderlich ist, die Berechnung durchzuführen. r^2 und keine Modelle mehr wechseln.
Zu diesem Zeitpunkt können wir faire Preisvorhersagen anbieten. Wir können den tatsächlichen Preis eines Hauses mit unserem prognostizierten Preis vergleichen und die Abweichung beobachten.
Über den Autor